




ポイント: scikit-learnのパーミュテーション重要度法は、データをシャッフルし、パフォーマンスの変化を測定することによって、モデルの結果に対する入力変数の重要性を評価します。この技術はモデルの精度を向上させ、不要な変数を特定して排除するのに役立ちます。
- パーミュテーション重要度は、入力データを変更することによって変数の関連性を評価します。
- この方法は、不要な変数を特定することによってモデルの精度を向上させます。
この投稿では、なぜ人々が前回の米国選挙でトランプに投票したのかを示します。これはクリントンに対して反対するということと同じです。なぜなら、周辺候補者はほとんど票を得なかったからです、相対的に見て。
ここでの技術は、ブラックボックス分類器と回帰モデルにおける最も厄介な質問の一つを扱います:回帰モデルからどの変数を削除すれば、より正確になるのでしょうか?
パーミュテーション重要度の仕組み
ELI5 scikit-learn Pythonフレームワーク内で、パーミュテーション重要度法を使用します。パーミュテーション重要度は、多くのscikit-learn推定量に対して機能します。データをシャッフルし、異なる入力変数を削除して、トレーニングモデルの計算における相対的な変化を確認します。また、入力変数が与えられた場合の結果がどれだけ上がるか、または下がるかを測定し、それによって結果に対する影響を計算します。
言い換えれば、線形回帰の場合、最初に係数α、β、γなどを計算します。
y = αa + βb + γc + … + ωz + B
そして、交差エントロピーまたは他の技術を使用してモデルをテストし、次にr2スコア、F1、精度を計算します。最後に、a、b、cの一つを削除し、再度実行します。
この方法には二つの欠点があります:
- 他のMLフレームワークはこれをサポートしていません。
- その出力は、iPython(別名Jupyter)を使用してのみ表示可能なHTMLオブジェクトです。
Jupyterの実行
Jupyterを実行することは非常に簡単です。Zeppelinよりも設定が簡単です。Anacondaをインストールするだけで、Macではjupyter notebookと入力します。これにより、ブラウザでこのURLが開きます http://localhost:8889/tree。
クリントン対トランプ
まず、こちらで米国選挙データを入手してください here。これらの概要は、米国の各州の各郡についてのものです。私たちが書くコードはこちらに格納されています。
選挙データを読み取るためにread_csv Pandasメソッドを使用し、いくつかの列のみを取得します。他の変数が有権者の選択と相関関係があるかどうかを調べるために、さらに多くの列を追加できます。
下部に完全なコードがあります。ここでは異なるセクションを説明します。しかし最初に、HTMLおよびテキスト形式の結果をご覧ください。
データフレーム内の列をそのインデックスによって見ることができます。ここにあります:
    Index(['Trump', 'age65plus', 'SEX255214', 'White', 'Black', 'Hispanic',
       'Edu_highschool'],
      dtype='object')
ここに相対的な重みがあります。
| 列名 | 重み | 特徴 |
| 65歳以上 | 0.5458 ± 0.0367 | x0 |
| ヒスパニック | 0.3746 ± 0.0348 | x4 |
| 白人 | 0.2959 ± 0.0159 | x2 |
| 性別255214 | 0.0323 ± 0.0064 | x1 |
| 高校卒業 | 0.0272 ± 0.0038 | x5 |
| 黒人 | 0.0207 ± 0.0023 | x3 |
グラフィックはiPythonノートブックに次のように表示されます:
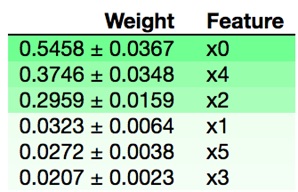
ご覧のとおり、トランプに投票するかどうかの決定は主に年齢によるもので、65歳以上の有権者が結果に最も密接に相関しています。驚くべきことに、性別はあまり重要ではありません。
コードの説明
別のブログでは、線形回帰を行う方法を説明します。ここでも同じ技術を使用しますが、独立変数が一つ以上、すなわちxを使用します。
独立変数xxをトランプを除くすべてとし、従属変数yyをトランプへの投票とします。トランプへの投票は、ヒラリーへの投票ではありません。したがって、yy変数の出力は同じであるか、類似しているべきですが、データ内でyy <> 1 - xxに正確に同じではなくなります。
データフレームのvaluesプロパティを使用して、NumPy配列に変換します。これはfitメソッドが要求するものです。
    xx = train[['White','Black','Hispanic','age65plus','Edu_highschool','SEX255214']].values
yy = train[['Trump']].values
配列を再形成する必要はありません。次元がペアリングできる要件に適合しています。xxは3112行と6列を持ち、yyは3112 x 1です。
    xx.shape is (3112, 6)
yy.shape is (3112, 1)
次に、linear_modelのfitメソッドを実行します。次に係数を印刷します:
    Coefficients:
 [[ 0.51503519 -0.13783668 -0.44485146  0.00352575 -0.00985589 -0.00801731]]
次に、パーミュテーション重要度のフィットメソッドを実行し、グラフを描きます。これにより、入力変数がシャッフルされ、線形回帰が複数回実行され、どの独立変数が係数の計算およびyに最も大きな影響を与えるかが計算されます。
    perm = PermutationImportance(reg, random_state=1).fit(xx, yy)
eli5.show_weights(perm)
ここに完全なコードがあります。
    import matplotlib.pyplot as plt
from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error, r2_score
import pandas as pd
import eli5
from eli5.sklearn import PermutationImportance

train = pd.read_csv('/Users/walkerrowe/Documents/keras/votes.csv',usecols=['Trump','White','Black','Hispanic','age65plus','Edu_highschool','SEX255214'])

xx = train[['White','Black','Hispanic','age65plus','Edu_highschool','SEX255214']].values
yy = train[['Trump']].values
reg = linear_model.LinearRegression()
model=reg.fit(xx,yy)
print('Coefficients: \n', reg.coef_)
perm = PermutationImportance(reg, random_state=1).fit(xx, yy)
eli5.show_weights(perm)
scikit Learn ガイド
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。