




ポイント: 外れ値検出は、詐欺検出や機器の故障分析などのアプリケーションにとって重要です。このガイドでは、データ分布と異常スコアを分析することによって外れ値を特定するscikit-learnのアイソレーションフォレスト法について説明しています。
- 外れ値検出技術にはzスコアとアイソレーションフォレストが含まれます。
- アイソレーションフォレストは、ランダムなデータ分割を通じて外れ値を特定する決定木を使用します。
この記事では、外れ値検出の方法を説明します。外れ値検出は、クレジットカードの詐欺、サイバーセキュリティ、システム内の故障した機器を検出するなど、さまざまなシナリオで重要です。
アプローチ
外れ値検出の最も簡単なアプローチは、正規分布を仮定し、いくつかの標準偏差でしきい値を設定することです。それをzスコアと呼びます。
この例では、異なるアプローチであるアイソレーションフォレストを使用します。これは、ランダムに値を選択し、ランダムに選択された範囲内で各データポイントを分割し、次に値を減少する範囲で再度ランダムに選択する決定木の一種です。最後に、そのツリー内の最短パスにあるものを外れ値としてフラグ付けします。これは計算によって異常スコアをフラグ付けします。
以下のサンプルでは、scikit-learnの機械学習フレームワーク内でアイソレーションフォレストを使用して異常検知を行う方法を示すためにサンプルデータをモックします。
コードの説明
この例のコードはこちらです。
まず、平均4、標準偏差1の標準正規分布から100サンプルを引き出して、100x2の行列を作成します:
train = rng.normal(4,1,(100,2))
次に、そのモデルをトレーニングします:
    from sklearn.ensemble import IsolationForest

clf = IsolationForest(behaviour='new', max_samples=100,
                      random_state=rng, contamination='auto')

clf.fit(train)
次に、別のサンプルを作成します。
typical = rng.normal(4,1,(100,2))
印刷すると、値は2から6の範囲にあることがわかります。したがって、値8と1の外れ値を作成します:
    outliers = np.array([
                     [8,6],
                     [1,4]
])
ここに完全なコードがあります:
    import numpy as np
import matplotlib.pyplot as plt
from sklearn.ensemble import IsolationForest

rng = np.random.RandomState(20)

train = rng.normal(4,1,(100,2))


typical =  rng.normal(4,1,(100,2))

outliers = np.array([
                     [8,6],
                     [1,4]
])


clf = IsolationForest(behaviour='new', max_samples=100,
                      random_state=rng, contamination='auto')

clf.fit(train)

pred_train = clf.predict(train)
pred_test = clf.predict(typical)
pred_outliers = clf.predict(outliers)
データのサンプルは、1以上6未満の範囲ですので、アルゴリズムが外れ値としてフラグを立てるべき1以上と6未満のデータをモックします。
    typical

array([[2.49602218, 5.31396783],
       [3.96987389, 4.63501308],
       [4.50243523, 5.16196591],
       [3.69425171, 5.71228277],
       [5.169437  , 3.72418513],
       [1.48821929, 3.58272819],
       [4.54157245, 3.8548927 ],
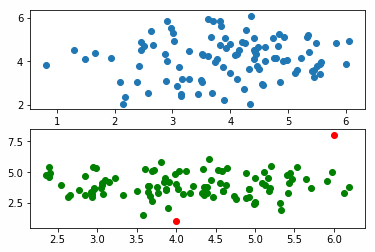
その後、3つの予測を実行し、それらをプロットし、各行列の2番目の列[:1]をx列、1番目の列をy軸[:0]にプロットして、ペアを視覚化する簡単な方法を示します。正規分布から引き出されているため、中心に集まります。
    pred_train = clf.predict(train)
pred_test = clf.predict(typical)
pred_outliers = clf.predict(outliers)
    fig, axis = plt.subplots(2)

axis[0].scatter(train[:,1], train[:,0] )

axis[1].scatter(typical[:,1], typical[:,0]  , c='g'  )
axis[1].scatter(outliers[:,1], outliers[:,0] , c='r'  )
[8,6]と[1,4]の点は外れ値であり、赤でプロットされているため、簡単に確認できます。
scikit Learn ガイド
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも示すものではありません。