




ポイント: 平均検出時間(MTTD)は、ITインシデントの発生からその発見までの平均時間を測定し、サービスの質を維持し、収益への影響を軽減するために不可欠です。正確な追跡はプロアクティブなインシデント管理を可能にします。
- MTTDは、システムの信頼性と可用性を評価するのに役立ちます。
- MTTDを改善するには、戦略的投資と自動化が必要です。
DevOps チームは、効率的な SDLC パイプラインを確立し維持するために、データ駆動の洞察に依存しています。さまざまなITインシデントの指標は、ITインフラ全体のパフォーマンス評価および個々のITインシデントを評価するのをサポートします。ITOpsとサービスデスクの課題は、特にエンドユーザーへの影響を最小限に抑えるのに貢献する最も重要な指標を特定することにあります。
この記事では、問題解決能力やパフォーマンスに関係なく、ITインシデントをより早く見つけることに焦点を当てた指標である平均検出時間(MTTD)について説明します。DevOpsとITOpsの両方のチームがMTTDを利用できます。
[helix-video]
平均検出時間とは何ですか?
ITインシデント管理における主要なパフォーマンス指標(KPI)である平均検出時間(MTTD)は、ITインシデントの発生からその発見までの平均時間を指します。
MTTDは、次の式で数学的に計算できます:
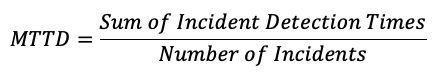
MTTDを数学的に計算するのは簡単ですが、ITインシデントの開始時刻について正確な知識が必要です。これは、歴史的なインフラKPIデータの評価を必要とする場合があります。複数のITインシデントの開始から実際の発見までの経過時間の平均を取ります。これらの計算は、MTTDパフォーマンスの変化を評価するために、さまざまな期間(例:日次、週次、または四半期)にわたって実行できます。
平均検出時間は、システムの信頼性と可用性をサポートするいくつかの指標の1つです。
効果的なインシデント管理のためのMTTD
インシデント管理は、インシデントを検出するだけでなく、エンドユーザーのパフォーマンスや収益ストリームに影響を与える可能性のあるインシデントを特定することに帰着します。パフォーマンスや収益に影響を与えないインシデントは、優先度が低くなる可能性があります。MTTDは、以下の両方の追跡を支援します:
- 単一の指標ではなく、複数のインフラ指標が収益に影響を与えるインシデントを報告する必要があります。これは良いことですが、すべてのITで生成される膨大なログメトリクスのボリュームには多くのノイズがあります。従来のITSMツールを使用しているITチームは、ITの問題をプロアクティブに特定するのに苦労するかもしれません。
- エンドユーザーも、サービスの中断や他のパフォーマンスの問題などのパフォーマンスに影響を与えるインシデントを報告する際にITインシデントを特定するのを助けます。根本的なインシデントがすでにあなたのチームに知られていないか、見えない場合、エンドユーザーからの報告の種類とスケールは、あなたのインシデント管理方法や監視ソリューションの不十分さに関する不一致を示すかもしれません。
これら2つのMTTD関連の問題に対処することは、技術的および戦略的な性質を持つ可能性があります:
- DevOpsは、インシデントの影響許容度の定義を再評価する必要があるかもしれません。
- ITは、ログメトリクスのビッグデータを使用して粒度の高い洞察を生成できる技術ソリューションに投資する必要があるかもしれません。いくつかのITSMイベントツールは、ITインシデント情報の複数のソースからの情報を相関させ、隠れたパターンの洞察を特定することができます。
これらを明らかにすることは、パフォーマンスと収益への影響が出る前に重要なITインシデントを特定するのに役立ちます。ITインシデントが優先度が高いと認識された場合、DevOpsチームは、優先度とSDLCパフォーマンスへの影響に基づいて問題を解決するための事前に設計されたプロトコルに従うことができます。
MTTDのベストプラクティス
MTTDを改善することは、DevOpsチームがエンドユーザーへの影響が及ぶ前にITインシデントに対処する機会を提供します。即時の解決を必要としない低優先度のインシデントに対しても、ITOpsは正確なインシデント関連情報を収集できます。
多くのサービス中断は、複数のインフラノードにわたるITインシデントの連鎖を引き起こします。各ノードで、個々のITインシデントは、是正措置を講じるに足るリスクを提示しないかもしれません。しかし、MTTDを改善することにより、ITOpsはITインシデントとインフラノードの評価範囲を拡大し、大規模なサービス中断を減少させるプロアクティブな手段にすることができます。
この文脈において—プロアクティブで予防的なインシデント管理—以下のMTTDのベストプラクティスが役立ちます:
戦略を立てる
単一の指標として、MTTDだけではインフラのパフォーマンスの十分な像を提供しません。同様に、すべてのインシデントが同じではありません。MTTDパフォーマンスを評価する際には、ITインシデントの多様な性質を考慮しなければなりません。戦略的であることは、DevOpsチームがインシデントの監視と管理を強化するためにリソースにより良い投資を行うことを可能にします。
DevOps環境では、戦略にはITSMに対するスリムなアプローチも必要です。MTTDに関連するITインシデント管理のために固定されたプロトコルを遵守するのではなく、より広いITSMの視点が必要です。ITOpsは、ITの変更の原因と結果を観察しなければなりません前に、ITインシデントのスペクトル全体で改善または緩和されたMTTD目標をターゲットにする必要があります。
人材を育成する
ITインフラの複雑な性質とITインシデント監視ソリューションの高度化にもかかわらず、人為的なエラーは不正確なMTTDメトリクスに重要な役割を果たし続けています。
- 監視ツールから得られる膨大な洞察を考慮すると、あなたのITOpsチームは、発生するさまざまなITインシデントに関連する技術やITSMプロセスについて深い理解が必要です。あなたのITSMツールはインシデントをフラグ付けするかもしれません—しばしば圧倒的に—したがって、あなたのITOpsチームは、影響を与えるサービスの中断につながるインシデントに関する正しい情報を抽出するための人間の知識、専門知識、スキルを備えている必要があります。
- 人為的なエラーや認識の欠如も、不正確または不十分なMTTD情報を引き起こす要因かもしれません。特に測定が手動で行われなければならない場合、あなたのサービス技術者は、必要な測定を定期的に記録するために慎重に行動しなければなりません。
- 最後に、あなたのITサービスデスクも、インシデント報告やエンドユーザーからの苦情に対してプロアクティブに対応しなければなりません。スリムなサービスデスクプロセスは、ITOpsがエンドユーザーによって報告されたITインシデントを発見するために重要です。
自動化とコーディング
自動化はDevOpsの心臓部ですが、インシデント検出と解決のプロセスにも重要に適用されるべきです。(自動化が不可能または完全な可視性を提供できない場合、あなたのITOpsチームはインシデント検出のための体系的なアプローチを開発し、利用する必要があります。)
インシデント検出と管理の自動化から得られる明確さには、いくつかの利点があります:
- ITOpsが適切なITSMプロセスをコーディングしやすくします。
- ITOpsがインシデントログとKPIメトリクスのさまざまな価値閾値で取られたアクションの正確な文書を維持するのを助けます。
- 柔軟でアジャイルな環境を促進します。問題検出と解決プロセスが戦略的なITSMおよびDevOpsの目標と整合しなくなった場合、ITOpsは単にコーディングされたパラメータを調整できます。
- ITチームの要件が変化しても、一貫したデータ収集と報告を維持します。
検出が先、解決が次
ITSMプロセスを改善する次のステップは、サービスデスクメトリクスである平均解決時間(MTTR)を使用して問題を解決することです。
BMC BlogsにはITメトリクスに関する多くのリソースがあります。私たちのエンタープライズIT用語集をブラウズするか、これらの記事を参照してください:
- サービスデスクメトリクスとしての平均解決時間(MTTR)
- MTBF対MTTF対MTTR:ITおよびデータセンター環境における障害の定義
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。