




ポイント: MongoDBシャーディングは、大規模データセットを複数のサーバーに分散させ、パフォーマンスとスケーラビリティを向上させます。シャード、クエリルーター、構成サーバーから構成され、高スループットアプリケーションでの効率的なデータ管理を可能にします。
- シャーディングは水平方向のスケーリングを可能にし、ハードウェアの負担を軽減し、クエリのパフォーマンスを向上させます。
- 主要なコンポーネントには、シャード、mongos、および構成サーバーが含まれ、それぞれがデータ分配において特定の役割を担っています。
この包括的な記事では、MongoDBにおけるシャーディングを探ります。記事は2つのセクションに分かれています:
- 概念、コンポーネント、利点と欠点
- シャーディングの設定に関するステップバイステップのチュートリアル
シャーディングとは何ですか?
シャーディングは、データを複数のホストに分散させるプロセスです。MongoDBでは、シャーディングは大規模なデータセットを複数のMongoDBインスタンスに分割することによって実現されます。
シャーディングの動作
高スループットのアプリケーションや非常に大きなデータベースを扱う場合、基盤となるハードウェアが主な制約となります。高いクエリレートはCPU、RAM、ディスクドライブのI/O容量にストレスをかけ、エンドユーザーの体験を悪化させる可能性があります。この問題を軽減するために、2つのスケーリング方法があります。
垂直スケーリング
垂直スケーリングは、単一のサーバーのハードウェア能力を増加させる従来の方法です。このプロセスには、CPU、RAM、およびストレージ容量のアップグレードが含まれます。ただし、単一のサーバーをアップグレードすることは、技術的な制約やコストの制約によってしばしば困難です。
水平スケーリング
この方法は、データセットを複数のサーバーに分割し、各サーバーインスタンスにデータベースの負荷を分散させます。負荷を分散させることで、必要なハードウェアリソースへのストレスが軽減され、障害が発生した場合の冗長性が提供されます。ただし、水平スケーリングは基盤となるアーキテクチャの複雑さを増加させます。MongoDBは、シャーディングを通じて水平スケーリングをサポートしており、これは以下で示すように大きな利点の1つです。
MongoDBシャーディングの基本
MongoDBのシャーディングは、少なくとも3つのサーバーから成るMongoDBインスタンスのクラスターを作成することによって機能します。つまり、シャーディングされたクラスターは、3つの主なコンポーネントで構成されています:
- シャード
- Mongos
- configサーバー
シャード
シャードは、シャーディングされたデータのサブセットを保持する単一のMongoDBインスタンスです。シャードはレプリカセットとしてデプロイされて、可用性を高め、冗長性を提供します。複数のシャードの組み合わせが完全なデータセットを作成します。たとえば、2TBのデータセットは、元のデータセットから500GBのデータを含む4つのシャードに分割できます。
Mongos
Mongosはクエリルーターとして機能し、アプリケーションとシャーディングされたクラスターの間の安定したインターフェースを提供します。このMongoDBインスタンスは、クライアントリクエストを正しいシャードにルーティングする役割を担っています。
Configサーバー
configサーバーは、クラスター全体のメタデータと設定設定を保存します。
コンポーネントの図解
以下の図は、公式のMongoDBドキュメントから、各コンポーネント間の関係を説明しています:
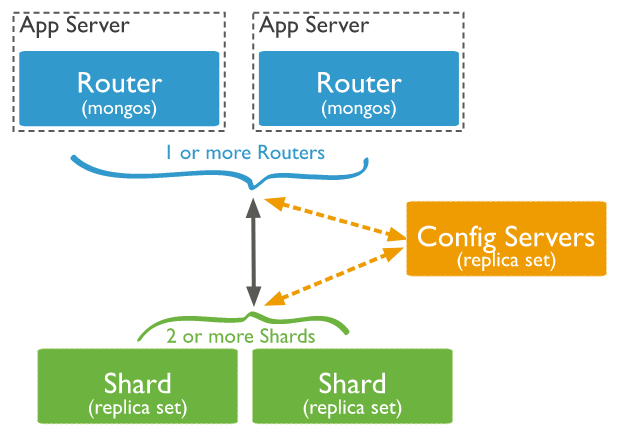
- アプリケーションは、実行するクエリについてルーター(mongos)と通信します。
- mongosインスタンスは、configサーバーに相談して、必要なデータセットを含むシャードを確認し、そのシャードにクエリを送信します。
- 最後に、クエリの結果がアプリケーションに返されます。
configサーバーはレプリカセットとしても機能することを忘れないでください。
シャードキー
MongoDBコレクションをシャーディングする際、シャードキーが初期ステップの1つとして作成されます。「シャードキー」は、MongoDBコレクションのドキュメントをすべてのシャードに分散させるために使用されます。キーは、各ドキュメント内の1つのフィールドまたは複数のフィールドで構成されます。シャーディングされたキーは、不変であり、シャーディング後は変更できません。シャーディングされたコレクションは、単一のシャードキーのみを含みます。 populatedコレクションをシャーディングする場合、コレクションはシャードキーで始まるインデックスを持っている必要があります。適切なインデックスを持たない空のコレクションの場合、MongoDBは指定されたシャードキーのインデックスを作成します。シャードキーはクラスターのパフォーマンスに直接的な影響を与える可能性があります。そのため、クラスターに関連するアプリケーションのボトルネックを引き起こす可能性があります。この問題を軽減するために、コレクションをシャーディングする前に、シャードキーは以下に基づいて作成する必要があります:
- データセットのスキーマ
- データセットのクエリ方法
チャンク
チャンクは、共有データのサブセットです。MongoDBは、シャーディングされたデータをチャンクに分割し、それらを共有クラスター内のシャードに分配します。各チャンクは、シャードキーに基づいて包含下限と排他的上限の範囲を持ちます。各クラスターに特有のバランサーがチャンクの分配を処理します。バランサーはバックグラウンドジョブとして実行され、必要に応じてチャンクを分配して、すべてのシャード間でチャンクの均等なバランスを実現します。このプロセスは均等チャンク分配と呼ばれます。
シャーディングの利点と制限
概念が理解できたので、MongoDBのシャーディングの利点と制限を見てみましょう:
利点
- 従来のレプリケーションシナリオでは、プライマリノードが書き込み操作の大部分を処理し、セカンダリサーバーは読み取り専用操作またはデータセットのバックアップの維持に制限されます。しかし、シャーディングはレプリカセットとともにシャードを利用するため、すべてのクエリがクラスター内のすべてのノードに分散されます。
- 各シャードが完全なデータセットのサブセットであるため、追加のシャードを単に追加することで、複雑なハードウェアの再構成を行うことなくクラスターのストレージ容量を増加させることができます。
- レプリケーションは、大規模なデータセットを処理する際に垂直スケーリングを必要とします。この要件は、ハードウェアの制約やコストの問題につながる可能性がありますが、MongoDBは水平スケーリングを利用するため、ワークロードが分散されます。必要に応じて、追加のサーバーをクラスターに追加できます。
- シャーディングでは、読み取りおよび書き込みのパフォーマンスは、クラスター内のサーバーノードの数に直接関連しています。このプロセスにより、追加のノードを単に追加することでクラスターのパフォーマンスを迅速に向上させる方法が提供されます。
- シャーディングされたクラスターは、単一または複数のシャードが利用できなくなっても運用を続けることができます。それらのシャードのデータが利用できない場合でも、クライアントアプリケーションは、ダウンタイムなしでクラスター内の他のすべての利用可能なシャードにアクセスできます。運用環境では、すべての個別のシャードがレプリカセットとしてデプロイされ、クラスターの可用性がさらに向上します。
制限
- シャーディングは、シャーディングされたクラスターを維持するために慎重な計画とメンテナンスを必要とします—複雑さが関与しているためです。
- MongoDBコレクションをシャーディングすると、シャーディングされたコレクションをアンシャードにする方法はありません。
- シャードキーは、コレクション内のすべてのドキュメントを識別するために使用されるため、基盤となるクラスターの全体的なパフォーマンスに直接的な影響を与えます。
- MongoDBのシャーディングされた環境内には、いくつかの操作上の制約があります。たとえば、geoSearchコマンドは、シャーディングされた環境内ではサポートされていません。
- シャードキーや複合シャードキーのプレフィックスが存在しない場合、Mongoはクラスター内のすべてのシャードをクエリするブロードキャスト操作を実行し、長時間実行されるクエリタスクを引き起こす可能性があります。
MongoDBシャーディングの設定方法
シャーディングの概念を理解したので、いくつかのチュートリアルを始めましょう。以下の手順では、3つのサーバーでシャーディングされたクラスターを設定する方法を示します。すべての3つのサーバーにUbuntu 20.04 LTSとMongoDB 4.4.1がインストールされています。サーバーを以下のように定義できます:
- mongodb01 - 10.10.10.56 - Config Server
- mongodb02 - 10.10.10.57 - クエリルーター(mongos)
- mongodb03 - 10.10.10.58 - シャード
次に、以下のアクションをいくつか通じて、次のことを行う方法を説明します:
configサーバーの設定
データベースとログファイルのためのディレクトリ構造を作成します。
    mkdir -pv  mongodb/data/configdb/
mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/configsvr.log
ls -alRv mongodb/
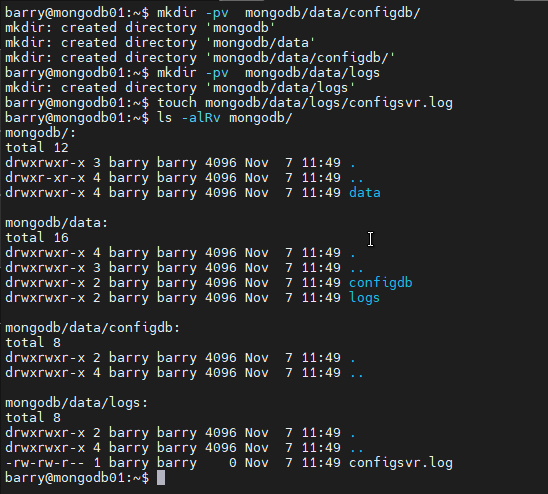
configファイルを作成します。上記のコマンドを実行すると、これらのディレクトリに加えてconfigファイルが作成されます。次に、configファイルを開き、サーバーのポートとIPアドレスを割り当てます。また、クラスターの役割をconfigsvrとして設定することも忘れないでください。
sudo nano /etc/mongodConfig.conf
ファイル - mongodConfig.conf
    storage:
  dbPath: /home/barry/mongodb/data/configdb
  journal:
  enabled: true

systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/configsvr.log

net:
  port: 27019
  bindIp: 10.10.10.56

sharding:
  clusterRole: configsvr

replication:
  replSetName: ConfigReplSet
構成サーバーを開始します。次に、以下のコマンドで構成サーバーを開始できます。
mongod --config /etc/mongodConfig.conf&
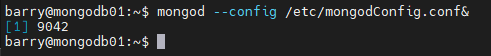
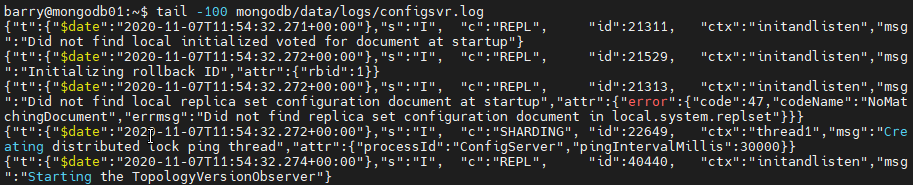
サーバーが実行中かどうかを確認するためにログを確認します。
tail -100 mongodb/data/logs/configsvr.log
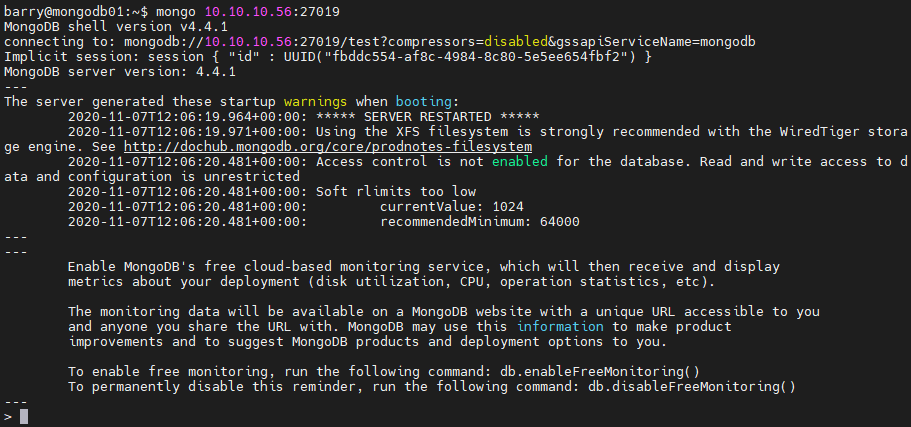
構成サーバーに接続します。
mongo 10.10.10.56:27019
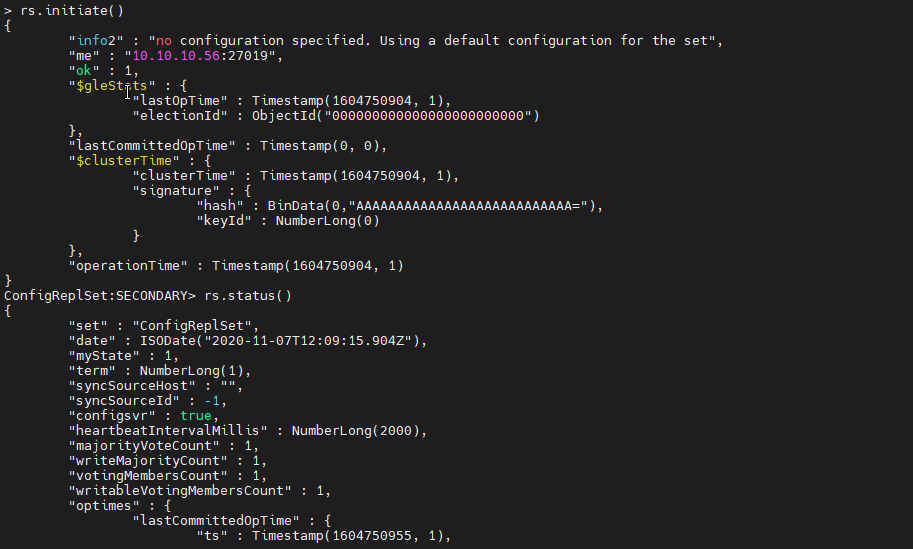
構成サーバーを初期化します。 initiate()関数を使用して、デフォルト構成で構成サーバーを初期化できます。その後、status() 関数でサーバーの状態を確認します。
    rs.initiate()
rs.status()
クエリルーターを設定する
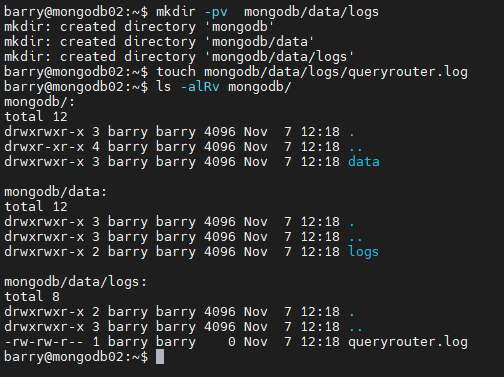
ディレクトリ構造と空のログファイルを作成します。
    mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/mongorouter.log
ls -alRv mongodb/
構成ファイルを作成します。 クエリルーターを作成するために、ログの場所、IP、およびサーバーインスタンスのポートを提供します。さらに、このクエリルーターが属する構成サーバーを定義する必要があります。
sudo nano /etc/mongoRouter.conf
ファイル - mongoRouter.conf
    systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/queryrouter.log

net:
  port: 27017
  bindIp: 10.10.10.57

sharding:
  configDB: ConfigReplSet/10.10.10.56:27019
mongosコマンドでクエリルーターを起動します。
mongos --config /etc/mongoRouter.conf&
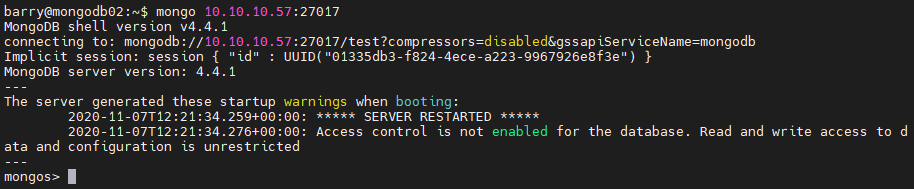
クエリルーターインスタンスが到達可能かどうかを確認します。
mongo 10.10.10.57:27017
シャードの設定
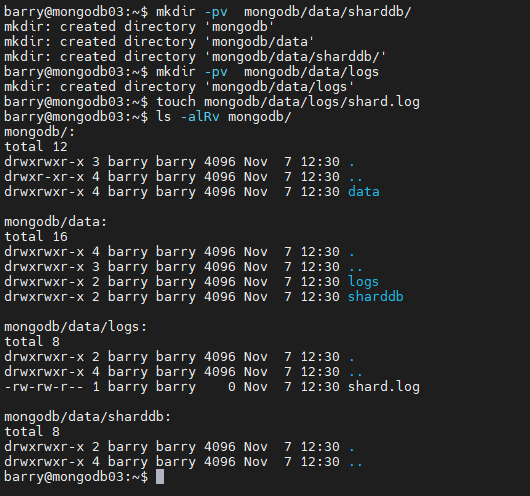
ディレクトリ構造とログファイルを作成します。
    mkdir -pv  mongodb/data/sharddb/
mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/shard.log
ls -alRv mongodb/
configファイルを作成します。シャードのconfigファイルには、データベースストレージ、ログ、およびシャーディングクラスターの役割がshardsvrに設定されているパスが含まれています。さらに、サーバーインスタンスへのネットワーク設定も含まれています。最後に、データを複製できるようにreplSetNameを設定しています。
sudo nano /etc/mongodShard.conf
ファイル - mongoShard.conf
    storage:
  dbPath: /home/barry/mongodb/data/sharddb
  journal:
    enabled: true

systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/shard.log

net:
  port: 27018
  bindIp: 10.10.10.58

sharding:
  clusterRole: shardsvr

replication:
  replSetName: ShardReplSet
シャードサーバーを起動します。
mongod --config /etc/mongodShard.conf&
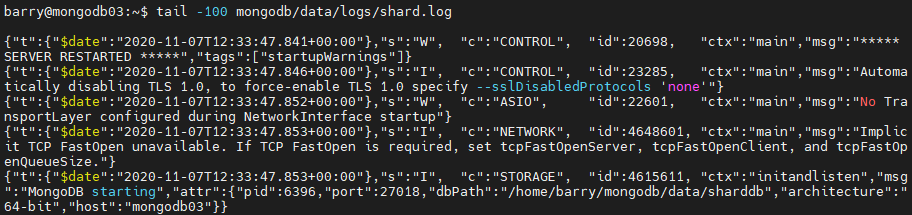
サーバーが稼働しているかどうかを確認するためにログを確認します。
tail -100 mongodb/data/logs/shard.log
シャードサーバーにログインします。
mongo 10.10.10.58:27018
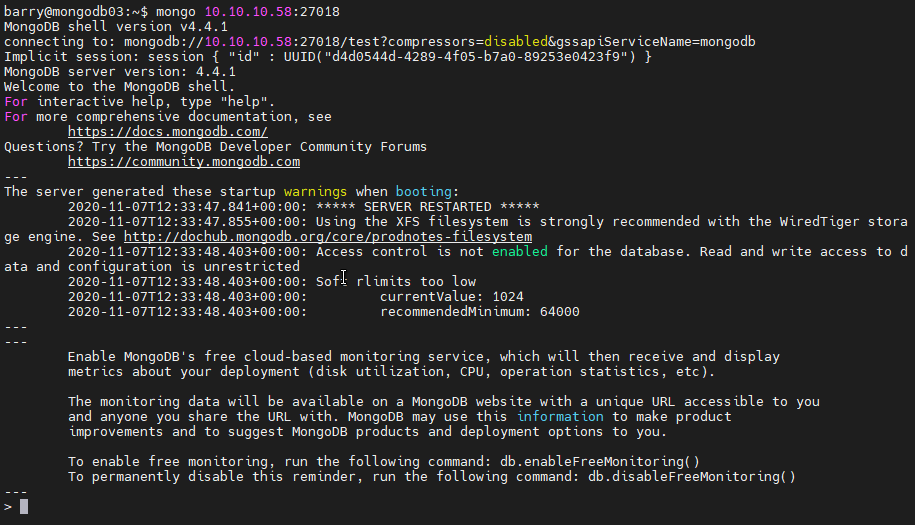
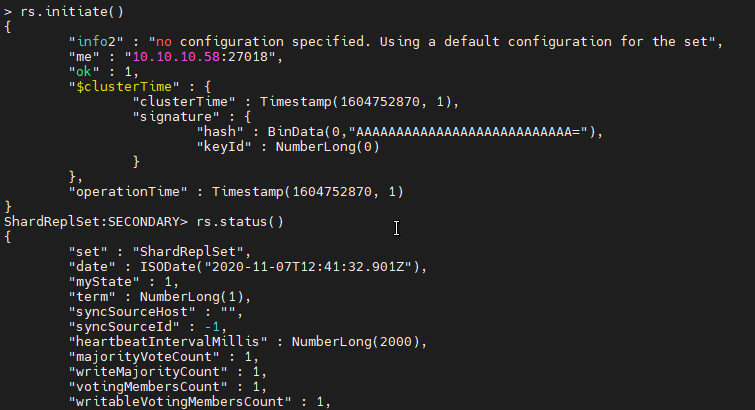
シャードサーバーを初期化します。デフォルト設定を使用してレプリケーションが有効になっており、initiate()関数を使用しています。その後、status()関数で初期化の状態を確認します。
    rs.initiate()
rs.status()
クラスタにシャードを追加
クエリルーターに接続します。
mongo 10.10.10.57:27017
シャードをクラスタに追加します。 addShard() コマンドを使用して、シャードインスタンスのIPアドレスとポートをreplSetNameに提供します。
sh.addShard( "ShardReplSet/10.10.10.58:27018")

シャーディングを有効にする
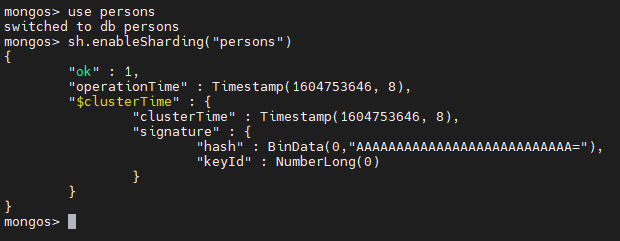
データベースを作成します。 クエリルーターを使用して「persons」という名前のデータベースが作成されます。このデータベースはシャーディング操作で使用されます。シャーディングを有効にするための必要な手順は以下の通りです:
    use persons
sh.enableSharding("persons")
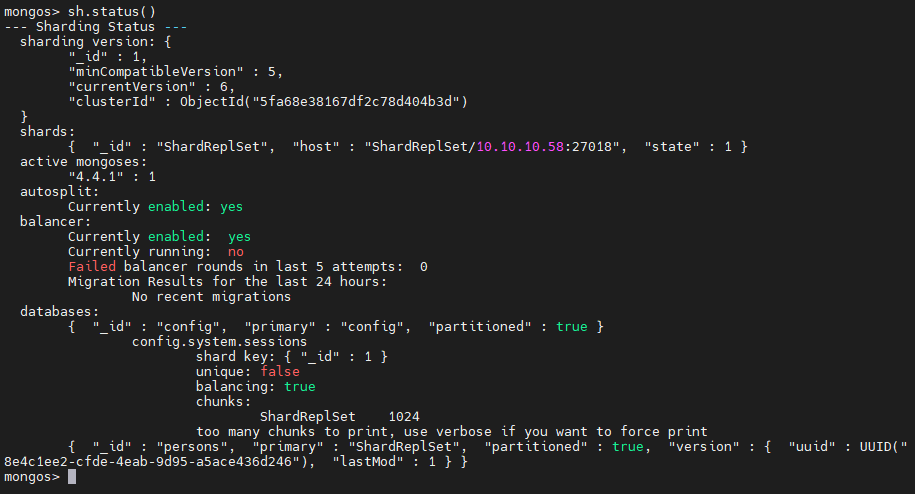
シャーディングの状態を確認します。 status() コマンドを使用して、データベースにシャーディングが有効かどうかを確認します。以下に示すように、「persons」データベースでシャーディングが有効です。
sh.status()
シャーディングデータセットを作成する
このセクションでは、MongoDBコレクションとperson_idというシャードキーとして使用するインデックスを作成します。コレクション内のデータはコレクションとシャードキーを使用してシャーディングされます。コレクションを作成します。
db.createCollection("personscollection")
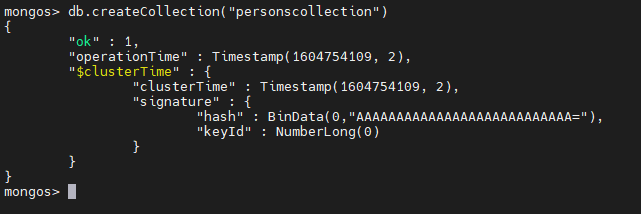
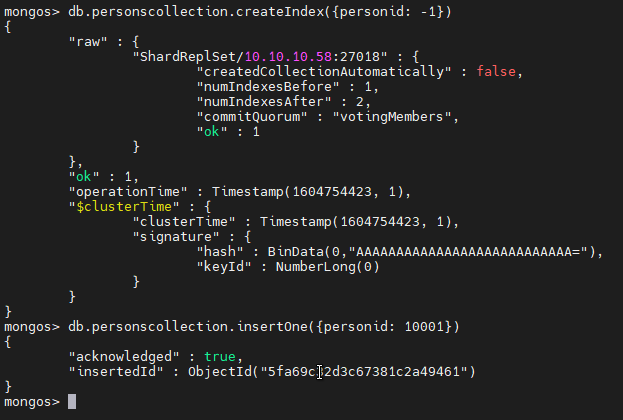
インデックスを作成し、レコードを追加します。 personidを降順でフィールドとしてインデックスを作成します。
db.personscollection.createIndex({personid: -1})
値10001のpersonidを追加します。
db.personscollection.insertOne({personid: 10001})
「personscollection」のためのシャーディングを有効にする
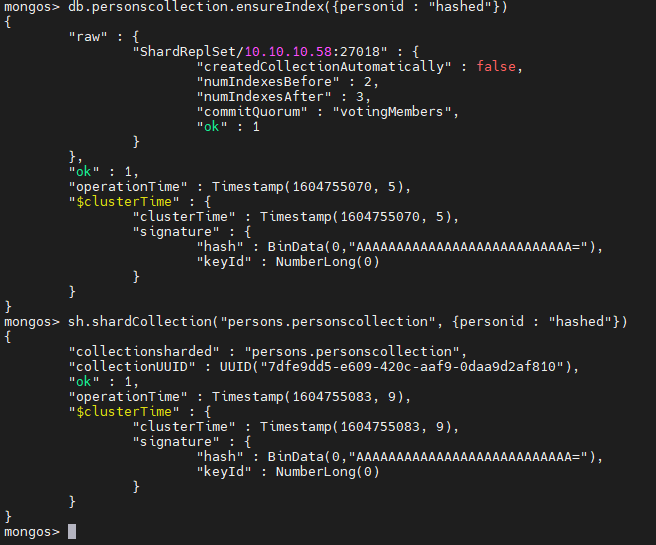
最初のステップは、インデックスpersonidがハッシュ化されていることを確認することです。そうでない場合、エラーが発生し、シャーディングが失敗します。これを達成するために、MongoDB内でensureIndex()関数を使用します。
db.personscollection.ensureIndex({personid : "hashed"})
インデックスが正しく使用されている場合、「personid」をシャードキーとしてシャーディングを有効にできます。
sh.shardCollection("persons.personscollection", {personid : "hashed"})
操作が成功した場合、次の出力が表示されます。
シャーディングが意図した通りに機能しているか確認します。 getShardDistribution()コマンドを使用してシャーディング操作の状態を確認します。
db.personscollection.getShardDistribution()
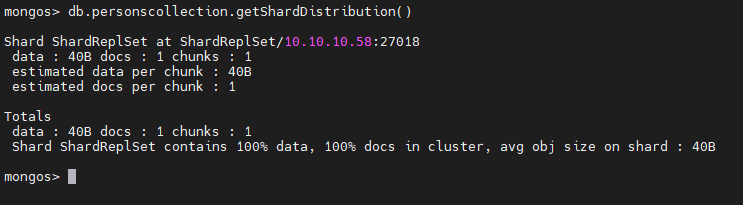
上記の出力は、personscollectionがシャードサーバー(10.10.10.58)のShardRepSetにシャーディングされていることを示しています。単一のチャンク内に単一のドキュメントが含まれています。利用可能なドキュメントは、コレクションに入力した単一のレコードです。
MongoDBシャーディングの要約
MongoDBシャーディングは、大規模データセットを効率的に管理する方法であり、サーバー間で作業負荷を分散させ、データベースの全体的なパフォーマンスに悪影響を与えることなく実現します。また、シャーディングは、将来の要件に合わせてクラスターを効率的にスケールする能力を提供し、基盤となるハードウェアインフラストラクチャの複雑な再構築を必要としません。
関連文献
MongoDBガイド
- MongoDBの概要: MongoDBの使い始め方
- UbuntuとMacにMongoDBをインストールする方法
- MongoDBでデータベースを作成する
- MongoDBシェルの基本コマンド
- MongoDB Compass: MongoGUIの使用
- MongoDBの役割ベースのアクセス制御(RBAC)の説明
- MongoDBの投影および投影演算子の説明
- MongoDBの集約関数の説明
- MongoDBのソート: sort()メソッドと例
- MongoDBでのPushおよびPull演算子の使用
- MongoDB $unwindの使用方法
- 23の一般的なMongoDBクエリ演算子とその使用方法
- MongoDBのGeoLocationクエリの例
- MongoDBトランザクションの紹介
- MongoDBインデックス: 主要なインデックスタイプとその管理方法
- 知っておくべきMongoDBの主要コマンド
- MongoDBレプリケーション: 完全な紹介
- MongoDBクラスターを設定する方法
- MongoDBシャーディング: 概念、例、およびチュートリアル
- MongoDB Atlas: 管理されたMongoDBの設定と使用
- MongoDBをDockerコンテナとして実行する方法
- MongoDBのメモリ使用量、管理、および要件
- MongoDBバックアップ用のmongodumpの使用方法
- MongoDBバックアップを復元するためのmongorestoreの例
- PyMongoの使用方法
- MongoDBとNodeJS用のMongooseの使用方法
- MongoDBチートシート
- MongoDB対Cassandra: NoSQLデータベースの比較
- PostgreSQL対MongoDB: データベースの比較
- MySQL対MongoDB: データベースの比較
- MongoDB認定: 入門
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。