




ポイント: MongoDBレプリケーションは、レプリカセットを使用してデータ耐障害性を強化し、サーバー間で複数のコピーを作成し、可用性と自動フェイルオーバーを確保します。書き込み操作のためのプライマリノードとデータレプリケーションのためのセカンダリノードを含みます。
- レプリケーションには、効果的な構成のために最低3つのノードが必要です。
- ハートビートプロセスはノードの状態を監視し、自動フェイルオーバーを促進します。
レプリカセットを使用したレプリケーションは、MongoDBデータベース全体のデータ耐障害性を高めるための堅牢な方法です。
この記事では、以下の内容について説明します:
始めましょう。
MongoDBレプリケーションとは?
簡単に言うと、MongoDBレプリケーションは、同じデータセットのコピーを複数のMongoDBサーバーに作成するプロセスです。これは、レプリカセットを使用することで実現できます。レプリカセットは、同じデータセットを維持し、任意のmongodプロセスに関連するMongoDBインスタンスのグループです。
レプリケーションにより、データベース管理者は以下を提供できます:
- データ冗長性
- データの高可用性
同じデータを持つ複数のMongoDBサーバーを維持することで、データへの分散アクセスを提供し、バックアップを提供することでデータベースの障害耐性を高めます。
さらに、レプリケーションは、負荷分散の一部としても使用でき、読み取りおよび書き込み操作をユースケースに応じてすべてのインスタンスに分散させることができます。
MongoDBレプリケーションの仕組み
MongoDBは、複数のMongoDBノードを単位としてまとめたレプリカセットを通じてレプリケーションを処理します。
レプリカセットには、最低3つのMongoDBノードが必要です:
- ノードの1つは、すべての書き込み操作を受け取るプライマリノードと見なされます。
- 他のノードはセカンダリノードと見なされます。これらのセカンダリノードは、プライマリノードからデータをレプリケートします。
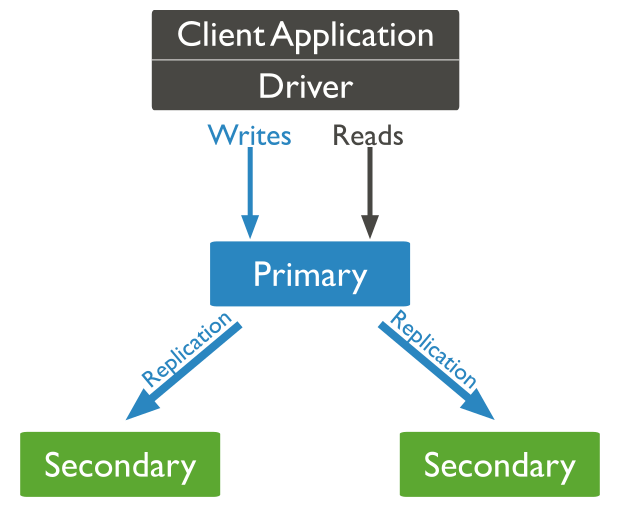
プライマリノードは書き込み操作を受け入れる唯一のインスタンスですが、レプリカセット内の他の任意のノードが読み取り操作を受け入れることができます。これらはサポートされているMongoDBクライアントを通じて構成できます。
プライマリノードが利用できないか、操作できない場合は、セカンダリノードがプライマリノードの役割を引き継ぎ、データの継続的な可用性を提供します。その場合、プライマリノードの選択は、最も適切なセカンダリノードが新しいプライマリノードとして選択されるプロセスであるレプリカセット選挙を通じて行われます。
ハートビートプロセス
ハートビートは、レプリカセット内のMongoDBノードの現在の状態を特定するプロセスです。そこで、レプリカセットノードは互いに2秒ごとにピンを送信します(それゆえこの名前)。ノードが10秒以内に応答しない場合、レプリカセット内の他のノードはそれをアクセス不可能としてマークします。
この機能は、プライマリノードが到達不能で、セカンダリノードが指定された時間枠内にハートビートを受信しない場合の自動フェイルオーバープロセスにとって重要です。その場合、MongoDBは自動的にセカンダリサーバーにプライマリサーバーとして機能させます。
レプリカセット選挙
レプリカセット内の選挙は、どのMongoDBノードがプライマリノードになるべきかを決定するために使用されます。これらの選挙は、以下のインスタンスで発生する可能性があります:
- プライマリノードへの接続の喪失(ハートビートによって検出される)
- レプリカセットの初期化
- 既存のレプリカセットに新しいノードを追加
- 強化または
rs.reconfigメソッドを使用したレプリカセットのメンテナンス
選挙のプロセスでは、最初にノードの1つが選挙を要求するフラグを立て、他のすべてのノードがそのノードをプライマリノードとして選出するために投票します。選挙プロセスが完了するまでの平均時間は12秒であり、レプリカの構成設定がデフォルト値であると仮定しています。選挙の完了時間に影響を与える主要な要因はネットワークの遅延であり、新しいプライマリノードでレプリカセットを運用に戻すのに遅れを引き起こす可能性があります。
レプリカセットは選挙が完了するまで書き込み操作を処理できません。ただし、読み取り操作は、読み取りクエリがセカンダリノードで処理されるように構成されている場合には提供できます。MongoDB 3.6は、互換性のある書き込み操作を再試行するために構成できる互換性のある接続ドライバーをサポートしています。
MongoDBレプリカセット対MongoDBクラスター
レプリカセットは、レプリカセットノード間で同じデータセットの複数のコピーを作成します。レプリカセットの基本目的は:
- データの可用性を高める
- 組み込みのバックアップソリューションを提供する
クラスターは異なる方法で機能します。MongoDBクラスターは、シャードキーを使用してデータを複数のノードに分散させます。このプロセスでは、データを「シャード」と呼ばれる複数の部分に分解し、それぞれのシャードを別々のノードにコピーします。
クラスターの主な目的は、非常に大きなデータセットと高スループット操作をサポートするために、ワークロードを水平方向にスケーリングすることです。
レプリカセットとクラスターの主な違いは:
- レプリカセットはデータセット全体をコピーします。
- クラスターはワークロードを分散させ、複数のサーバーにデータの断片(シャード)を保存します。
MongoDBは、各シャードがセカンダリサーバーにレプリケートされることで、高いデータ可用性と冗長性を提供するシャーディングクラスターを作成することで、これら2つの機能を組み合わせることをユーザーに許可します。
レプリケーション遅延の処理
レプリケーションの構成に関する主要な懸念は、レプリケーション遅延(ラグ)です。これは、レプリカセット内のプライマリノードの更新後、セカンダリノードへのレプリケーションプロセスにおける遅延を指します。
大規模データセットをレプリケートする際の一定のレプリケーションラグは正常ですが、以下の要因はレプリケーション遅延を増加させ、最新のレプリケーションの利点を否定する可能性があります:
- ネットワーク遅延。 レプリケーション中に異なるサーバーにある複数のMongoDBインスタンスを扱う場合、主な通信方法はネットワークになります。ネットワークがレプリケーションプロセスのニーズを満たすのに不十分な場合、レプリケーションデータの遅延が発生します。したがって、常に十分な帯域幅を持つ安定したネットワークでトラフィックをルーティングすることが望ましいです。
- ディスクスループット。 レプリケーションノードが異なるディスクタイプを使用する場合(例:プライマリノードがSSDを使用し、セカンダリノードがHDDを使用している場合)、プライマリノードに比べてセカンダリノードが書き込みクエリを遅く処理するため、レプリケーションに遅延が生じます。これは、マルチテナントや大規模な展開において一般的な問題です。
- 重いワークロード。 プライマリノードで重く長時間実行される書き込み操作を実行することも、レプリケーションプロセスに遅延をもたらします。したがって、レプリケーションプロセスが全体のパフォーマンスに影響を与えずにワークロードに追いつけるように、MongoDBの書き込みの優先度を正しく構成することが最善です。
- バックグラウンドタスク。 もう1つの重要なステップは、サーバーの更新、cronジョブ、セキュリティチェックなどのバックグラウンドタスクを特定することです。これらはネットワークやディスクの使用に予期しない影響を与え、レプリケーションプロセスに遅延を引き起こす可能性があります。
- データベース操作。 一部のデータベースクエリは実行に時間がかかる場合があり、いくつかはかなりの時間を要することがあります。データベースプロファイラを使用して、これらのクエリを特定し、それに応じて最適化を試みることができます。
レプリカセットの構成
上記のセクションでは、レプリケーションに関連するすべての重要な理論をカバーしました。次に、3つのUbuntuサーバーにインストールされたMongoDBインスタンスを使用してレプリカセットを構成します。
環境の設定
それぞれのUbuntuサーバーには、標準のMongoDBポート27017がファイアウォールを通じてアクセス可能な独自のMongoDBインスタンスがあります。MongoDBは、プロダクション環境でレプリカセットを構成する際に、IPアドレスの代わりに論理DNSホスト名を使用することを推奨しています。これは、IPアドレスの変更によるレプリカセット内の通信の中断を避けるためです。
/etc/hostsファイルを更新して、テスト環境内の各サーバーにホスト名を割り当てることができます。そこでは、下記のホスト名を追加して各ノードを示し、新しい構成を読み込むために各サーバーを再起動する必要があります。
/etc/hosts
    10.10.10.56 mongodb-node-01
10.10.10.57 mongodb-node-02
10.10.10.58 mongodb-node-03
MongoDBインスタンスの開始
MongoDBインスタンスを開始する前に、各サーバーの設定ファイルを修正してIPアドレスを反映させ、レプリカセットを示す必要があります。各mongod.confファイルに以下の修正を行います。
mongodb-node-01
mongodb-node-02
mongodb-node-03
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1,mongodb-node-01# replica set
replication:
replSetName: replicasetMain
mongodb-node-02
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1,mongodb-node-02# replica set
replication:
replSetName: replicasetMain
mongodb-node-03
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1,mongodb-node-03# replica set
replication:
replSetName: replicasetMain
アップデートが完了したら、各インスタンスでmongodサービスを再起動して構成を再読み込みします。
sudo systemctl restart mongod
レプリカセットの初期化
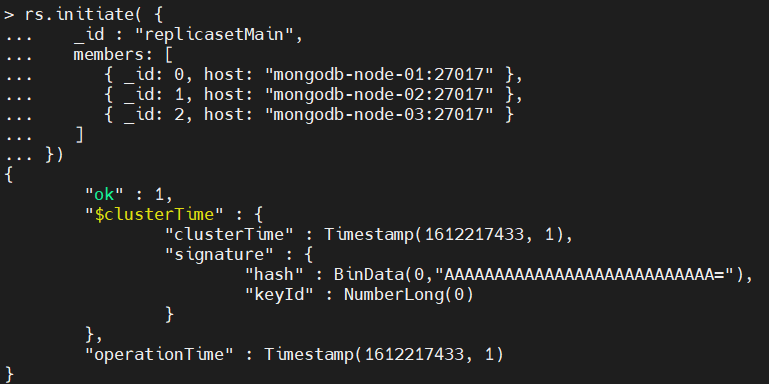
rs.initiate()メソッドを使用してレプリカセットを初期化できます。このメソッドは、レプリカセット内の単一のMongoDBインスタンスでのみ実行する必要があります。初期化メソッド内で、レプリカセットの名前とメンバーを指定できます。これらの詳細は、前のステップで各設定ファイルで行った構成と一致する必要があります。
結果:
    rs.initiate( {
_id : "replicasetMain",
members: [
{ _id: 0, host: "mongodb-node-01:27017" },
{ _id: 1, host: "mongodb-node-02:27017" },
{ _id: 2, host: "mongodb-node-03:27017" }
]
})
結果:
rs.conf()コマンドを使用して、以下のようにレプリカセットの構成を表示できます。
結果:
rs.conf()
結果:

データレプリケーションの検証
レプリケーションセットを構成したので、次のステップはレプリケーションプロセスを検証することです。まず、レプリカセットのプライマリMongoDBノードにログインします。
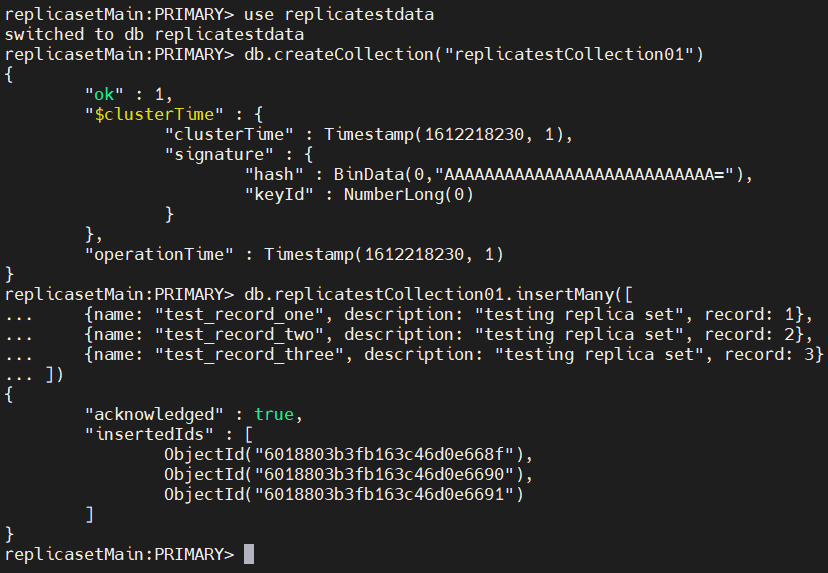
次に、以下のコマンドを使用してサンプルデータを含むコレクションを作成する必要があります:
結果:
    use replicatestdata
db.createCollection("replicatestCollection01")
db.replicatestCollection01.insertMany([
{name: "test_record_one", description: "testing replica set", record: 1},
{name: "test_record_two", description: "testing replica set", record: 2},
{name: "test_record_three", description: "testing replica set", record: 3}
])
結果:
次に、セカンダリノードにログインし、データがレプリケートされているかどうかを確認します。ここで重要な点は、デフォルトではセカンダリノードで読み取りクエリが無効になっていることです。したがって、以下のコマンドを使用してそれらを有効にする必要があります。
db.getMongo().setSecondaryOk()
その後、データを検索して、それらがセカンダリノードに適切にレプリケートされているかどうかを確認できます。
結果:
    show dbs
use replicatestdata
show collections
db.replicatestCollection01.find().sort({record: 1}).pretty()
結果:
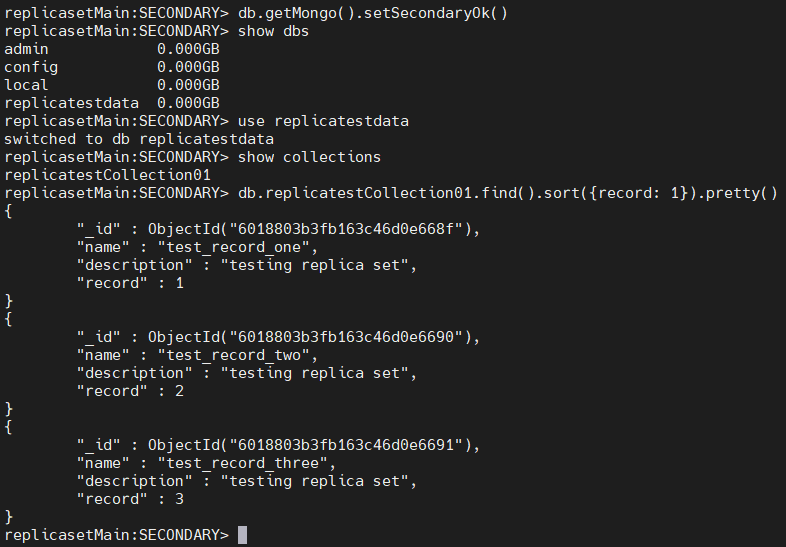
上記の結果は、プライマリノードのデータがセカンダリインスタンスに正常にレプリケートされたことを示しています。
レプリカセットに新しいノードを追加
rs.add()コマンドを使用して、既存のレプリカセットに新しいノードを追加できます。
新しいノードを追加する前に、それを構成する必要があります。そのためには、mongd.confファイルを修正してレプリカセットを示し、mongodサービスを再起動します。
mongodb-node-04
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1, mongodb-node-04# replica set
replication:
replSetName: replicasetMain
次に、レプリカセットのプライマリノードに移動し、以下のパラメータを含むadd()コマンドを実行します。
- hostは新しいノードのIPアドレスまたはホスト名を指します。
- priorityは、新しいノードがプライマリノードになる相対的な適格性を示します。(優先度0は、そのノードがいかなる状況でもプライマリノードになれないことを意味します。)
- vote は、そのノードがプライマリノードを選定するための選挙で投票できるかどうかを示します。
結果:
rs.add( { host: "mongodb-node-04:27017", priority: 0, votes: 1 } )
結果:

上記のコマンドは、新しいノードをレプリカセットに追加します。rs.status()コマンドを使用して、新しいノードが追加されたかどうかを確認できます。このコマンドは、新しいノードの詳細を表示します。
結果:
rs.status()
結果:

最後に、他のノードのデータが自動的に新しいノードにレプリケートされます。
レプリカセットからノードを削除
rs.remove()コマンドを使用して、レプリカセットからノードを削除できます。ノードを削除する前に、サーバーインスタンスをシャットダウンする必要があります。削除する際には、そのノードの名前を使用してどのノードを削除するかを指定できます。
結果:
rs.remove("mongodb-node-04:27017")
結果:

この結果は、そのノードがレプリカセットから正常に削除されたことを示しています。
関連文献
MongoDBガイド
- MongoDB概要:MongoDBの始め方
- UbuntuおよびMacにMongoDBをインストールする方法
- MongoDBでデータベースを作成する
- MongoDBシェル基本コマンド
- MongoDB Compass:Mongo GUIの使用
- MongoDBのロールベースアクセス制御(RBAC)の説明
- MongoDBのプロジェクション&プロジェクションオペレーターの説明
- MongoDBの集約関数の説明
- MongoDBのソート:sort()メソッドと例
- MongoDBでのPush&Pullオペレーターの使用
- MongoDBの$unwindの使い方
- 23の一般的なMongoDBクエリオペレーターとその使用方法
- MongoDBのGeoLocationクエリ例
- MongoDBトランザクションの紹介
- MongoDBインデックス:主要インデックスタイプとその管理方法
- 知っておくべき主要なMongoDBコマンド
- MongoDBレプリケーション:完全な紹介
- MongoDBクラスターの設定方法
- MongoDBシャーディング:概念、例、およびチュートリアル
- MongoDB Atlas:管理されたMongoDBの設定と使用
- MongoDBをDockerコンテナとして実行する方法
- MongoDBのメモリ使用量、管理、および要件
- MongoDBバックアップのためのmongodumpの使用法
- MongoDBバックアップの復元のためのmongorestoreの例
- PyMongoの使用法
- MongoDBおよびNodeJS用のMongooseの使用方法
- MongoDBチートシート
- MongoDB対Cassandra:NoSQLデータベースの比較
- PostgreSQL対MongoDB:データベースの比較
- MySQL対MongoDB:データベースの比較
- MongoDB認証:紹介
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。