




ポイント: MongoDBプロジェクションは、ユーザーがドキュメントから特定のフィールドを選択的に取得できるようにし、データ管理とパフォーマンスを向上させます。$elemMatch、$slice、$metaなどのオペレーターを利用して、データ抽出をカスタマイズします。
- プロジェクションは、クエリ中のリソース使用量を削減します。
- オペレーターは、特定のデータ取得のための高度な機能を提供します。
MongoDBでは、find()メソッドを使用してデータを取得します。ただし、find()はフィルタリングなしでドキュメント内のすべてのフィールドを取得します。MongoDBプロジェクションは、この問題を解決し、find()関数をデータフィルタリング引数と共に使用できるようにし、ユーザーがドキュメントから必要なデータフィールドのみを抽出できるようにします。このハンズオン記事では、次のことを示します:
MongoDBプロジェクションの仕組み
MongoDBプロジェクションは、ドキュメントから必要なフィールドのみを抽出するために使用できる強力なツールです。すべてのフィールドではなく、特定のフィールドのみを抽出します。これにより、
- 簡潔で透明なデータをプロジェクトする
- データセットをフィルタリングし、全体のデータベースパフォーマンスに影響を与えない
MongoDBプロジェクションは、既存のfind()メソッドの上に構築されているため、既存の関数に大幅な変更を加えることなく、任意のプロジェクションクエリを使用できます。さらに、プロジェクションは、特定のデータセットからユーザー固有のデータを見つける際の重要な要素です。
MongoDBプロジェクションの基本構文
db.collection_name.find({},{ : })
MongoDBプロジェクションは、同じfind構文を使用しますが、find関数に一連のパラメータも追加します。この一連のパラメータは、MongoDBインスタンスに返されるべきフィールドを通知します。「vehicleinformation」と呼ばれるコレクションを考えてみましょう。

トヨタ(make: 'Toyota')の車両のモデル年を取得しようとします(通常のfind()ステートメント)。
db.vehicleinformation.find({make : "Toyota"}).pretty()
結果:

このステートメントでは、makeがToyotaであるドキュメント内のすべてのデータを受け取ります。年だけを取得するには、以下に示すようにプロジェクションを使用できます。MongoDBプロジェクションステートメント
db.vehicleinformation.find({make : "Toyota"}, {year : 1}).pretty()
結果:

プロジェクションステートメントでは、Boolean値1(True)を持つyearフィールドを使用して、「year」フィールドのみを要求していることを示します。制限として、MongoDBは、オブジェクトID(_id)を各ドキュメントに返しますが、オブジェクトIDを要求しないことを明示的に指定しない限り、返します。MongoDBプロジェクションステートメントで「_id」を除外
db.vehicleinformation.find({make : "Toyota"}, {year : 1, _id : 0}).pretty()
結果:

このステートメントでは、オブジェクトIDフィールドを要求しないことを示すために0をBoolean演算子として渡します。
MongoDBプロジェクションのオペレーター
MongoDBプロジェクションメソッドを使用してドキュメントから特定のデータを取得すると、データベースのパフォーマンスに良い影響を与えます。なぜなら、検索クエリの負荷を軽減し、リソース使用量を最小限に抑えるからです。負荷を軽減するために、MongoDBは以下のオペレーターを提供しており、プロジェクションクエリ内で使用できます:
- $
- $elemMatch
- $slice
- $meta
$オペレーター
$オペレーターは、配列の内容を制限して、クエリ条件に一致する最初の要素を投影するために使用されます。MongoDB 4.4以降、クエリ条件が存在しない場合、指定された配列内の最初の要素が返されます。構文:
db.collection.find( { : ... }, { ".$": 1 } )
$演算子の制限:
- 単一のクエリでは単一の$演算子のみを使用できます。
- クエリは、適用される配列フィールドに対して単一の条件のみで構成されなければなりません。
- find()メソッド内のsort()関数は、$演算子の前に適用されます。この関数により、ソート順が正しく表示されないことがあります。
- $演算子は、フィールドパスの最後にのみ適用できます。この制限は、MongoDB 4.4で導入され、フォーマットの問題を軽減するためのものです。
- $sliceプロジェクション式は、同じ式の一部として$演算子と一緒に使用できません。
「studentgrades」コレクションを使用して、$演算子を示します。
db.studentgrades.find({},{_id:0}).pretty()
結果:

「studentgrades」コレクションを使用して、学生が80以上の成績を取得したかどうかを検索します。$演算子を使用しないとどうなるかを見てみましょう。以下のコードは、80以上のアイテムがある場合、クエリが配列内のすべての値を出力として返す結果になります。
db.studentgrades.find( {grades: { $gte: 80}}, {"grades": 1})
結果:
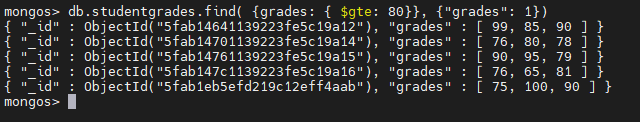
$演算子を使用すると、80以上の最初のアイテムのみが返されます。
db.studentgrades.find( {grades: { $gte: 80}}, {"grades.$": 1})
結果:

$elemMatch演算子
$elemMatch演算子は、与えられた条件に一致する最初の要素に配列の内容を制限します。この条件は、$演算子とは異なり、$elemMatchプロジェクション演算子には明示的な条件引数が必要です。find()メソッドで$elemMatchを使用する構文を見てみましょう。
db.collection.find( { : ... }, { ".$elemMatch": ($elemMatch operator) } )
$elemMatch演算子の制限
- ドキュメント内のフィールドの順序に関係なく、$elemMatchプロジェクションが適用されるフィールドは、ドキュメントの最後のフィールドとして返されます。
- MongoDBビューで実行されるfind()操作は、$elemMatchプロジェクション演算子をサポートしていません。
- $textクエリ式は、$elemMatch演算子と一緒にサポートされていません。
「schooldata」コレクションを使用して、$elemMatch演算子を示します。
db.schooldata.find()
結果:

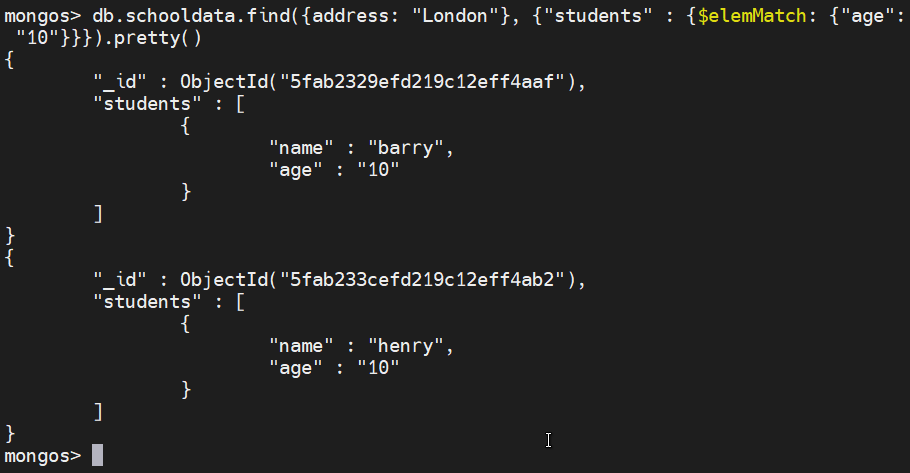
今回は単一のフィールドでこれを実行します。$elemMatch演算子を使用して、ロンドンの学校で10歳の学生を検索します。pretty()メソッドは、出力をフォーマットするために使用されます。
db.schooldata.find({address: "London"}, {"students" : {$elemMatch: {"age": "10"}}}).pretty()
結果:
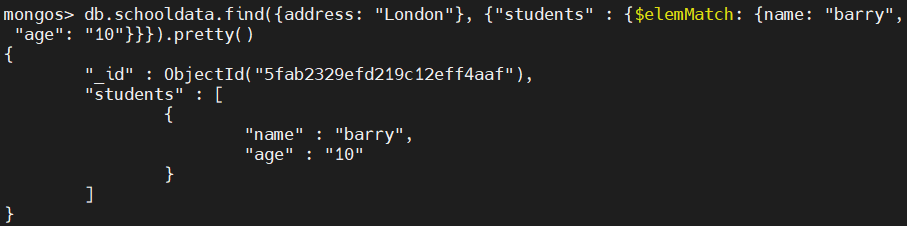
以下の例では、複数のフィールドをチェックします。ここでは、学生の年齢と名前の両方を確認します。「barry」という名前の10歳の学生がロンドンの学校に通っているかどうかを確認します。
db.schooldata.find({address: "London"}, {"students" : {$elemMatch: {name: "barry", "age": "10"}}}).pretty()
結果:
$sliceプロジェクション演算子
$slice演算子は、クエリの出力として返されるべき要素の数を指定します。構文:
db.collection.find( , { : { $slice: } })
$slice演算子の制限:
- MongoDB 4.4の導入により、$slice演算子はスライスされた要素のみを返します。ネストされた配列の他のアイテムは返されません。
- $slice演算子は、MongoDBビューでのfind()操作をサポートしていません。
- $slice演算子は、MongoDBの制限により、$プロジェクション演算子と一緒に使用できません。トップレベルフィールドは、フィールド名の一部として$(ドル記号)を含むことができません。
- クエリには、$sliceの配列と、同じステートメントの一部として配列に埋め込まれたフィールドを含めることができません。これにより、MongoDB 4.4からパスの衝突を排除します。
「schooldata」コレクションを使用して、$slice演算子を示します。
db.schooldata.find()
結果:
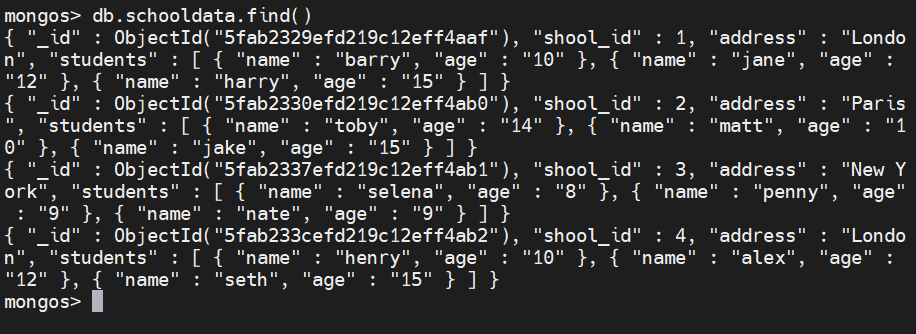
配列の最初の要素をスライスしてみましょう。この結果を得るために、$slice演算子を使用して学生の配列から最初の要素のみをスライスします。
db.schooldata.find({}, {students: {$slice : 1}})
結果:
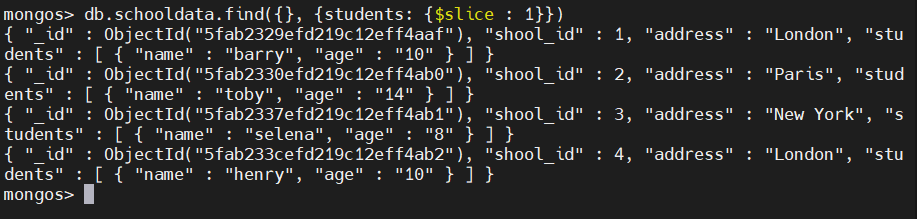
次に、配列の最後の要素をスライスします。「-1」を使用して最後のレコードを示します。
db.schooldata.find({}, {students: {$slice : -1}})
結果:

要素をスキップするには、スキップする要素と返される要素の数を定義する必要があります。以下の例がこのシナリオを示しています。最初の要素をスキップし、次の2つの要素を返します。
db.schooldata.find({}, {students: {$slice : [1, 2]}})
結果:

このステートメントでは、「students」配列をスライスし、最初の要素をスキップし、残りの2つの要素を返します。これらは角括弧[]内に定義されていました。最初の値は無視される要素であり、2番目の値は返される残りの要素の数です。最初の要素をスキップした後、配列に2つ未満の要素がある場合、残りのすべての要素が返されます。
$meta演算子
$meta演算子は、ドキュメントに関連するメタデータを取得するために使用されます。$meta演算子は、MongoDBの集約およびMongoDBプロジェクションの両方で使用できます。このセクションでは、MongoDBプロジェクションの基本をカバーし、$meta演算子がプロジェクションでどのように使用されるかを説明します。$meta演算子は、次の構文を使用します。
{ $meta: }
「metaDataKeyword」には、次の値を関連付けることができます:
- 「textScore」キーワード。「textScore」は、指定された$text文字列に関連付けられたスコアを返します。このキーワードは、検索用語がドキュメント内の指定されたフィールドにどのように一致するかを基本的に判断します。MongoDB 4.4で「textScore」キーワードを使用する場合、$textクエリが必須です。
- 「indexKey」キーワード。MongoDB 4.4で導入された、cursor.returnKey()関数の代替として推奨されるものです。この関数は、非テキストインデックスが使用されているドキュメントのインデックスキーを返します。このキーワードは、デバッグ目的のみに使用され、製品環境では使用しないでください。
$meta演算子の使用と制限:
- { $meta: 「textScore」}式は、ドキュメント内でテキストスコアを取得するためのプロジェクションクエリの一部になることができます。この式は、プロジェクションステートメントにおける包含または除外のいずれかであることができます。唯一の制限は、式がドキュメント内の既存のフィールドに設定されている場合、プロジェクションされたメタデータ値がフィールド内の現在の値を上書きすることです。
- find()メソッドで「text score」を定義できません。したがって、最良の選択肢はMongoDB集約を使用することです。
- $meta式は、sort()関数内で使用できます。「textScore」メタデータは、降順にソートされます。
- { $meta: 「textScore」}式がプロジェクションとソートの両方の関数に含まれている場合、各関数は式の異なるフィールド名を持つことができます。クエリシステムは、sort()内のフィールド名を無視します。
では、いくつかの例を見てみましょう: { $meta : 「textScore」}について、食べ物コレクションを使用します。
db.food.find().pretty()
結果:

「食べ物」コレクションのインデックスを作成しましょう。「food_desc」フィールドを使用して、テキストインデックスを作成します。
db.food.createIndex({"food_desc": "text"})
結果:

今度はテキストスコアを見つけましょう。検索用語として「pizza」を使用し、$meta演算子を使用して各ドキュメントのテキストスコアを取得します。 (_id: 0)フィールドは、出力をより明確にするために各ドキュメントのオブジェクトIDを省略するために使用されます。
db.food.find( {$text : {$search: "pizza"}}, {score: {$meta: "textScore"}, _id: 0})
結果:
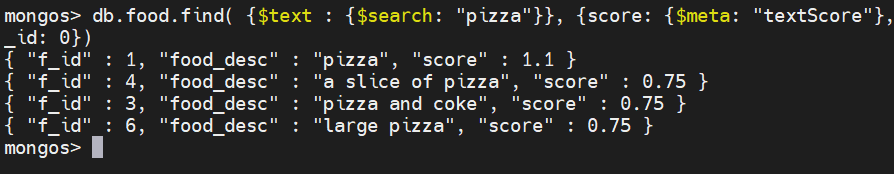
現在、{$meta: "indexKey"}に移ります。「indexKey」はデバッグ目的のためだけに厳密に使用されるため、公式のMongoDBドキュメントでは次のように述べています。
    NOTE
The { $meta: "indexKey" } expression is for debugging purposes only and not for application logic. MongoDB returns the value associated with the index chosen by the query system. The system can choose a different index upon subsequent execution.
For the selected index, the return value depends on how the database decides to represent values in an index and may change across versions. The represented value may not be the actual value for the field.
以下の例は「vehiclesales」コレクションを使用して作成されています。{_id:0}フィールドを使用すると、オブジェクトIDが出力から省略されます。
db.vehiclesales.find({},{_id:0})
結果:
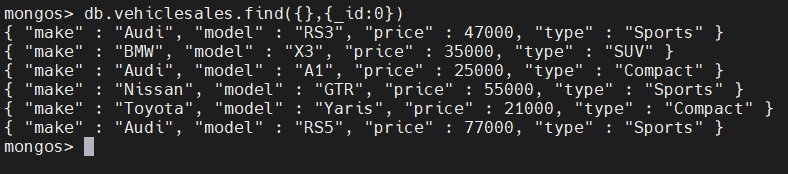
ここでは、「make」と「type」フィールドを使用して複合インデックスを作成します。
db.vehiclesales.createIndex({make : 1, type: 1})
結果:

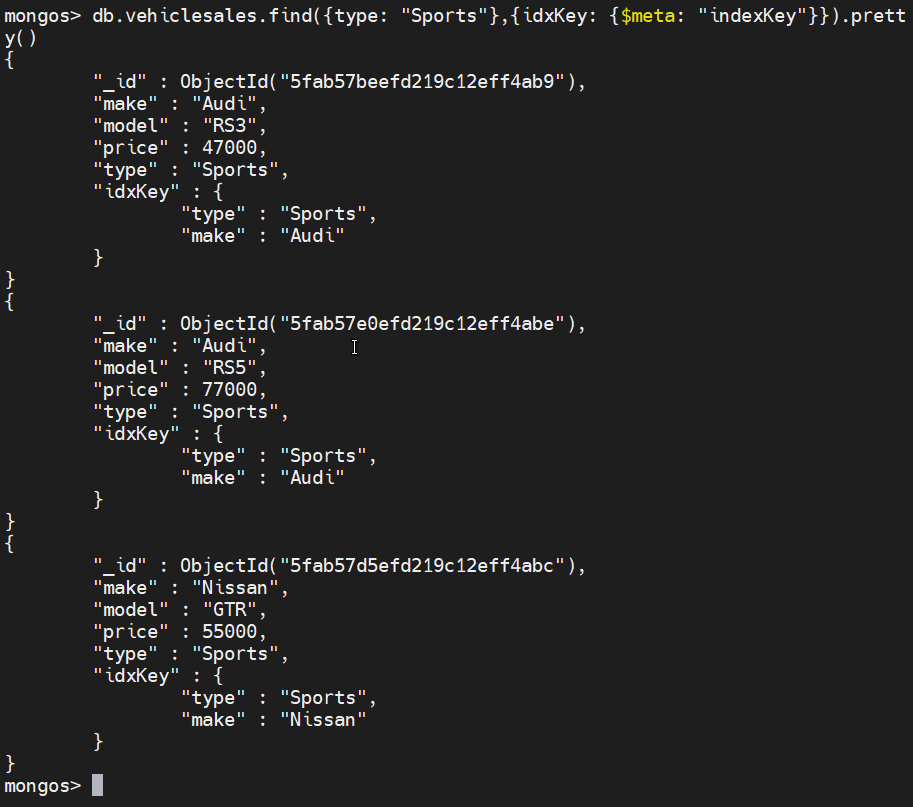
次に、インデックスを使用したプロジェクションを行います。「vehiclesales」コレクション内で、タイプが「Sports」と等しいドキュメントを検索し、各ドキュメントのインデックスキーを取得するために$metaオペレーターを使用します。
db.vehiclesales.find({type: "Sports"},{idxKey: {$meta: "indexKey"}}).pretty()
結果:
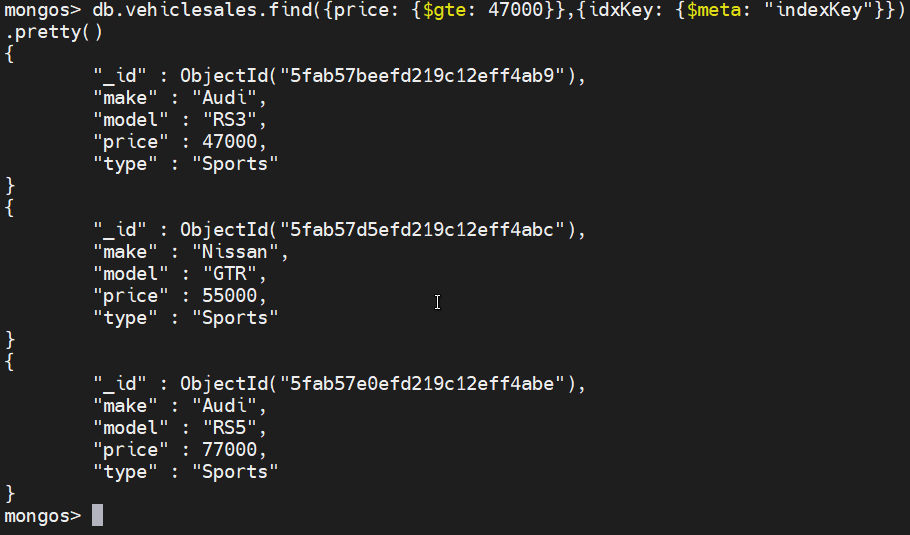
インデックスなしのプロジェクションはどうでしょうか?インデックスの一部でないフィールドを要求した場合、インデックスがnullとなるため、クエリは値を返しません。この場合、価格フィールドがインデックスの一部でないため、インデックスは返されません。
db.vehiclesales.find({price: {$gte: 47000}},{idxKey: {$meta: "indexKey"}}).pretty()
結果:
この情報チュートリアルはこれで終了です。
関連情報
MongoDBガイド
- MongoDBの概要: MongoDBの始め方
- UbuntuおよびMacにMongoDBをインストールする方法
- MongoDBでデータベースを作成する
- MongoDBシェルの基本コマンド
- MongoDB Compass: Mongo GUIの使用
- MongoDBの役割ベースのアクセス制御(RBAC)の説明
- MongoDBプロジェクションとプロジェクション演算子の説明
- MongoDBの集約関数の説明
- MongoDBのソート: sort()メソッドと例
- MongoDBでのプッシュおよびプル演算子の使用
- MongoDB $unwindの使用方法
- MongoDBの23の一般的なクエリ演算子とその使用方法
- MongoDBの地理位置情報クエリの例
- MongoDBトランザクションの紹介
- MongoDBのインデックス: トップインデックスタイプとその管理方法
- 知っておくべきトップMongoDBコマンド
- MongoDBのレプリケーション: 完全な紹介
- MongoDBクラスターの設定方法
- MongoDBシャーディング: 概念、例、およびチュートリアル
- MongoDB Atlas: マネージドMongoDBの設定と使用
- MongoDBをDockerコンテナとして実行する方法
- MongoDBのメモリ使用量、管理、および要件
- MongoDBバックアップのためのmongodumpの使用方法
- MongoDBバックアップを復元するためのmongorestoreの例
- PyMongoの使用方法
- MongoDBとNodeJSのためのMongooseの使用方法
- MongoDBチートシート
- MongoDB vs Cassandra: NoSQLデータベースの比較
- PostgreSQL vs MongoDB: データベースの比較
- MySQL vs MongoDB: データベースの比較
- MongoDB認定: 入門
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表すものではありません。