




ポイント: 解釈可能性と説明可能性は、機械学習モデルを理解するために重要です。解釈可能性は因果関係に関わり、説明可能性はパラメーターの重要性を明らかにします。どちらも信頼と倫理的AIの構築に不可欠です。
- 高い解釈可能性は、高リスクの状況において責任を持つために重要です。
- 説明可能性は、自動化された意思決定プロセスにおける偏見を減らすのに役立ちます。
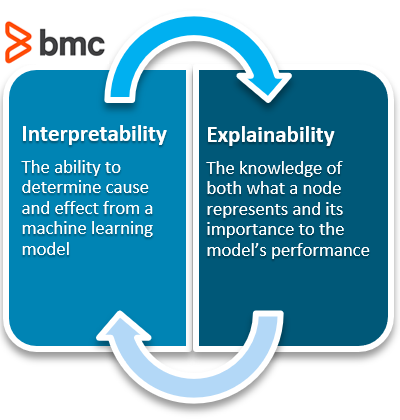
解釈可能性は、機械学習モデルが原因と結果をどれだけ正確に関連付けられるかに関わります。説明可能性は、しばしば深層ネットワークに隠れているパラメーターが結果をどのように正当化するかに関わります。
これは長い記事です。頑張ってください。最後には、次のことを理解できるでしょう:
- 解釈可能性が説明可能性とどのように異なるか
- なぜモデルが解釈可能または説明可能である必要があるのか
- 誰がブラックボックス問題を解決しようとしているのか、そしてどのように
解釈可能性とは?
チポトレはあなたの胃を痛めますか?大きな音は聴力の低下を加速させますか?女性は男性よりも攻撃的ではありませんか?もし機械学習モデルがこれらの関係に基づいて定義を作成できるなら、それは解釈可能です。
すべてのモデルは仮説から始まります。人間の好奇心は、あるものが別のものに関連していることを直感的に理解させます。「うーん、黒人が警官に撃たれることが多い…他の人種に比べて不釣り合いに見える…何かが構造的かもしれない?」探求してください。
人々は周囲を解釈するための内部モデルを作成します。機械学習の分野では、これらのモデルは世界の正確または不正確な表現としてテストおよび検証できます。
解釈可能性は、原因と結果を特定できることを意味します。
モデルが入力を受け取り、常に同じ出力を得ることができるなら、そのモデルは解釈可能です:
- 夕食時にパスタを食べすぎて、いつも眠れない場合、その状況は解釈可能です。
- 2016年のすべての世論調査が民主党の勝利を示し、共和党候補が政権を取った場合、すべてのモデルは低い解釈可能性を示しました。世論調査員の目標が良いモデルを持つことであり、ジャーナリズムの制度が真実を報告することを強いられているなら、エラーは彼らのモデルの更新が必要であることを示しています。
低い解釈可能性
解釈可能性は低リスクのシナリオでは問題を引き起こしません。モデルが視聴する映画を推薦している場合、それは低リスクのタスクです。(あなたが大手コンテンツプロバイダーの一人であり、すべての推薦が悪くて、視聴者が時間を無駄にしていると感じる場合を除いて、ですが)。モデルがあなたのその日の好きな色を生成したり、日中に集中すべき簡単なヨガの目標を生成している場合、彼らは低リスクのゲームを行い、モデルの解釈可能性は不要です。
高い解釈可能性の必要性
解釈可能性は、あるモデルが別のモデルよりも優れている理由を正当化するために、高い必要があります。
マネーボールでは、古い学校のスカウトたちは、野球チームの良い選手を選ぶための解釈可能なモデルを使用していました。これらは機械学習モデルではありませんが、スカウトたちはどの選手があるシーズンにうまく機能するかを選択するための方法(基本的にはアルゴリズム)を開発しました。しかし、ヘッドコーチはこの方法を変更したいと考えていました。
ビリー・ビーンの方法が機能し、その方法論が広がるためには、彼のモデルは業界が真実だと信じていたすべてに反して、高い解釈可能性を持っている必要がありました。高いモデルの解釈可能性は議論に勝ちます。
リスクと責任
高い解釈可能性を持つモデルは、高リスクの賭けゲームで望ましいです。高い解釈可能なモデルは、他の当事者を責任を持たせることができます。そして、モデルが人が癌にかかっているかどうかを予測している場合、人々は下された決定に対して責任を持たれる必要があります。高い解釈可能性を持つモデルを設計基準として維持することは、エンジニアとユーザー間の信頼を構築するのに役立ちます。
命令系統が人々が決定を下した当事者に話すことを妨げると、十分悪いです。決定を下した当事者が存在せず、すべての責任が機械学習モデルにある場合は、さらに悪いです。モデルの行動に対して罰を与えることに対して、報復はありません。
テラノスが「一滴の血」から正確な結果を出せなかった場合、人々はその会社を支持することから撤退し、その企業とその詐欺的なリーダーが破産するのを見守ることができました。
最後に、高い解釈可能性は人々がシステムを操作することを可能にします。教師がテストの採点方法を示すルーブリックを配布すれば、学生はテストの回答をその方法に合わせればよいだけです。教師がウェインズ・ワールドの熱狂者なら、学生はウェインズ・ワールドに関する逸話を挿入する必要があります。あるいは、教師が学生が胃の中でバクテリアがタンパク質を分解するプロセスを理解していることを確認したい場合、学生は存在するタンパク質やバクテリアの種類を説明すべきではありません。代わりに、彼らはバクテリアが何をしているかにすぐにジャンプすべきです。
学生たちは、自動採点システムやSATが試験で書かれた内容を実際に理解できないことを指摘しました。学生たちは、自身の書いた文章がただのナンセンスであるか、少なくとも中程度に首尾一貫しているかをアルゴリズムに理解させる方法を作り出しています。
説明可能性とは?
MLモデルはしばしばブラックボックスモデルと呼ばれます。なぜなら、事前に設定された数の空のパラメーターやノードが機械学習アルゴリズムによって値を割り当てられるからです。具体的には、逆伝播ステップがエラー関数に基づいて重みを更新する責任があります。
ある人がいつ亡くなるかを予測するために、モデルはその入力を受け取り、その人が80歳まで生きる確率を出力します。
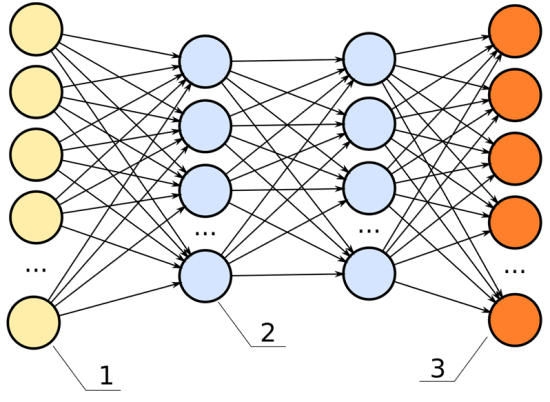
以下はニューラルネットワークの画像です。入力は黄色であり、出力はオレンジです。全体のグレードに対するルーブリックのように、説明可能性は各パラメーター(すべての青いノード)が最終決定にどのように寄与するかを示します。
例えば、以下のデータ入力があります:
- 年齢
- BMIスコア
- 喫煙年数
- 職業カテゴリ
このモデルに高い説明可能性があれば、たとえば次のように言えます:
- 職業カテゴリは約40%重要
- 喫煙年数は35%重要
- 年齢は15%重要
- BMIスコアは10%重要
説明可能性:重要だが、常に必要ではない
説明可能性は機械学習の分野で重要です。なぜなら、しばしば明らかではないからです。説明可能性はしばしば不要です。機械学習エンジニアは、モデルの説明可能性を考慮せずにモデルを構築できます。それは構築プロセスの余分なステップであり、車を運転する際のシートベルトを着用するようなものです。車の性能には必要ありませんが、事故が起きたときに保険を提供します。
深層ニューラルネットがエンジニアに提供する利点は、パラメータのブラックボックス、つまり偽の追加データポイントを作成し、モデルがそのデータに基づいて決定を下すことができるようになる点です。これらの偽データポイントはエンジニアには知られていません。ブラックボックス、または隠れ層は、モデルが与えられたデータポイントの間に関連付けを行い、より良い結果を予測することを可能にします。たとえば、誰かがどれくらい生きるかを決定し、職業データを入力として使用する場合、モデルは高リスク職業と低リスク職業に職業を自動的に分類できる可能性があります。
ノードを調べると、石油掘削作業員、潜水溶接工、およびボートの料理人を互いに関連付けている可能性があります。ニューラルネットは、これらの個人の寿命と関連付けるためのプレースホルダーを深層ネットに置く可能性があります。ブラックボックスの個々のノードを調べれば、このクラスタリングが水のキャリアを高リスクの仕事であると解釈していることがわかります。
前のチャートでは、黄色い点から青い点に接続されている各線が信号を表し、そのノードが全体の出力スコアを決定する上での重要性を測定します。
- その信号が高い場合、そのノードはモデルの全体的なパフォーマンスにとって重要です。
- その信号が低い場合、そのノードは重要ではありません。
この理解を持って、説明可能性を次のように定義できます:
1つのノードが何を表し、モデルのパフォーマンスにどれほど重要かを知ること。
「どのように?」を問いかける
画像分類タスクは興味深いです。なぜなら、通常提供されるデータはピクセルのシーケンスと画像データのラベルだけだからです。画像データを使用する一般的な目的は、画像内のオブジェクトを検出することです。犬の画像を入力すると、出力は「犬」であるべきです。どのようにこれが起こるかは完全に不明であり、モデルが機能する限り(高い解釈可能性)、どのように行われるかに疑問はありません。
画像検出アルゴリズム、通常は畳み込みニューラルネットワークでは、最初の層は陰影とエッジ検出を参照します。人間はエッジや影を明示的に定義する必要はありませんが、両者はすべての写真に共通しているため、特徴が単一のノードとしてクラスタリングされ、アルゴリズムがノードを最終結果予測に対して重要と評価します。画像検出モデルはより説明可能になります。
Googleは最近、彼らのモデルの結果について謝罪しました。見出しが言うように、彼らのアルゴリズムは人種差別的な結果を出しました。機械学習モデルは一般的に単一の決定を下すために使用されるものではありません。彼らはソフトウェアやコンピュータのように、何度も何度も多くの決定を下すために作られています。機械学習モデルはスケールで決定を下すことを目的としています。もしそれらの決定がある人種または性別に偏見を含むことがあれば、それは非常に大きな方法で誤ることがあります。
それは、ある子供にキャンディを与え、他の子供には与えないと言うことと同じです。その決定は、その子供にキャンディなしで行動するように条件付けます。MLでは、これはスケールで、すべての人に起こります。そして、重要なポイントは、影響を受ける人々は偏見を主張するための参照点を持っていないことが多いということです。彼らはただ、何かが起こっていることを知っていますが、それを完全には理解していません。
説明可能性の支持
活動家の熱心な支持者にとって、説明可能性は、MLエンジニアがモデルが性別、人種、またはその他のあいまいにしたいデータポイントに基づいて決定を下していないことを保証するために使用することが重要です。これらの項目に基づいてモデルが下す決定は、モデル間で深刻または誤ったものになる可能性があります。
幸運なことに、自由で民主的な社会では、世界の活動家やジャーナリストのような人々が企業を監視し、Googleのようなエラーを指摘し、害が行われる前にそれを指摘しようとします。独立した請負業者や多くのリモートワーカーがいる社会では、企業は悪いモデルを構築して実践に投入する独裁者のような支配を持っていません。多くの企業の労働者は、他の人に自分の発見を報告するのが容易であり、さらに重要なことに、日々の仕事をしている間に滑り落ちるかもしれない誤りを修正する立場にいます。
良好なコミュニケーションと民主的なルールは、自己修正する社会を保証します。このことは、レジリエントエンジニアリングやカオスエンジニアリングでも一貫して真実です。これは、企業の死のスパイラルを避ける理由です。説明可能なモデルを支持する理由です。説明可能なモデル(XAI)は、決定に関するコミュニケーションを改善します。
MLモデルの説明可能なコンポーネントを探求し、それらのコンポーネントを調整することで、全体的な予測を調整することが可能です。別のホットなトピックを挙げると、Googleは2019年に性別バイアスを終わらせる「代名詞解決」の競争を開催しました。基本的に、自然言語処理(NLP)は、代名詞を名詞にリンクさせるためにコアフェレンス解決と呼ばれる技術を使用します。「シャウナ」という単語の後に「彼女」という代名詞を予測することが機械学習タスクになっています。
シャウナはレースが好きです。それは彼女のお気に入りのスポーツです。
コアフェレンス解決は、次のようにマッピングします:
- シャウナ → 彼女
- レース → それ
この技術は、すべての未知のエンティティ(彼女、彼、彼、彼ら、彼女たち)を実際のエンティティに置き換えることで、データセット内の既知の情報を3~5倍増加させることができます。競争の目標は、性別を説明する内部メカニズムを明らかにし、それをオフにすることでした。
大企業がこれらの問題を終わらせるために戦っているとは思われるかもしれませんが、彼らのエンジニアは積極的にこれらの問題を考慮しようとしています。経済的には、彼らの善意を高めます。
私はこの記事でGoogleをかなり使用しましたが、Googleは単一の思考ではありません。Googleは約20万人の従業員を抱える小さな都市であり、ほぼ同じ数の派遣労働者がいます。その影響は計り知れません。アマゾンは900,000人の従業員を抱え、恐らく似たような状況にいます。これは、多くの人々にとってあまりにも多く、秘密が存在することはありません。エンロンはその日の29,000人の人々を抱えていました。
ブラックボックス問題の解決
最後に、Googleに高い評価を与えるために、スーザン・ルユ・チーが、Google DeepMindがブラックボックス問題を解決した可能性がある理由に関する良い議論をまとめました。要点は、説明可能性はML分野が積極的に解決している核心的な問題であるということです。多くの人々が同じ問題の多くの側面に取り組んでいるため、本当に悪いものが誰かの目を通過するのは難しいでしょう。
コンピュータは常に社会の外部者を惹きつけてきました。大規模なシステムは常に彼らに逆行しています。これらの人々は毎日異常を見つめており、誰がどのように扱われるかを決定するコードの行を磨く完璧な監視役です。説明可能性と解釈可能性はMLモデルに観察可能な要素を追加し、監視者がすでに行っていることを可能にします。
新しい世代の20代の人々には、告発者の価値を理解する期待があります。彼らは、他のすべての前に独自の道徳基準を維持しています。私を信じないなら、なぜ彼らが仕事を次々と移ると思いますか?
追加リソース
BMC機械学習&ビッグデータブログおよびこれらの関連リソースを探求してください:
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を示すものではありません。