




ポイント: Amazon S3 から Snowflake へのデータインポートには、ウェアハウス、外部ステージ、データベースの作成、データアップロード、SQL 実行が含まれます。BMC の Control-M プラットフォームはこの統合をサポートしています。
- 効率的なデータ読み込みのために Snowflake の COPY コマンドを利用します。
- 外部ステージはデータ管理を強化し、アクセスを簡素化します。
この記事では、Amazon S3 から Snowflake に JSON データを読み込む方法を示します。
Snowflake と JSON ファイル
Snowflake は AWS 上のデータウェアハウスです。Snowflake の COPY コマンドは、JSON、XML、CSV、Avro、Parquet、および XML 形式のデータファイルをコピーできます。しかし、Snowflake が JSON ファイルをサポートしていると言うのは少し誤解を招く表現です。これらのデータファイルを解析しないため、Amazon Redshift の例で示したように、実際にはデータをすべて Snowflake の variant 型のカラムにコピーします。その後、それに対して JSON SQL クエリを実行します。ここからダウンロードできる 2 つのデータファイルを読み込みます:
注意: これは NDJSON 形式です。つまり、全体のファイルは有効な JSON ファイルではありません。個々の JSON レコードで構成されています。
データベースおよびウェアハウスの作成
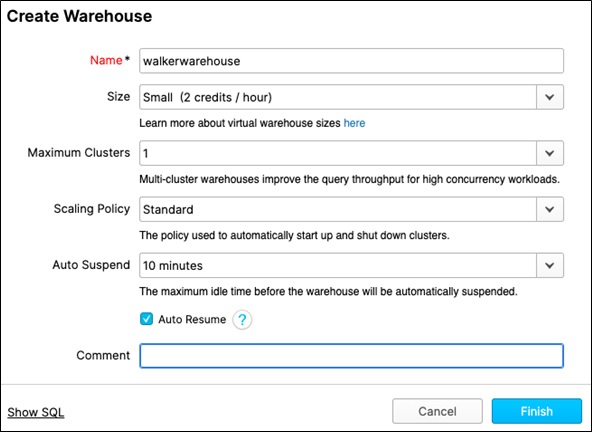
私たちは Amazon AWS 上で Snowflake クラスターを運用しています。(Amazon AWS コンソールのサービスとしてはリストされていません。代わりに、Snowflake サイトでサインアップし、Amazon、Microsoft、または Google クラウド上でインスタンスを起動します。) このようにしてウェアハウスを作成します。ここでは、マシンサイトとサーバーの数を選択し、計算能力とコストを選択します。
外部ステージの作成
Amazon S3 から直接データをコピーできますが、Snowflake は 外部ステージ エリアを使用することを推奨しています。その理由は示されていません。しかし、こうすることで、資格情報を保存し、コピー構文を簡素化し、ワイルドカードパターンを使用してファイルを選択してコピーできます。
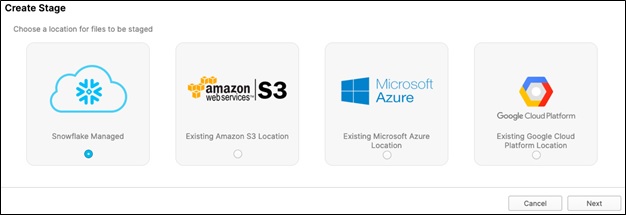
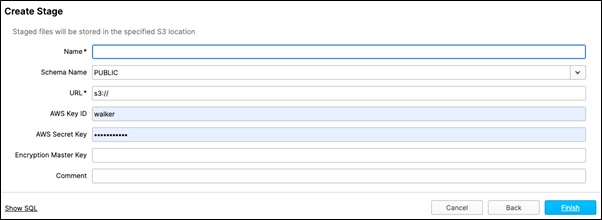
名前を付けて S3 バケットを指定します。
データベースの作成
他のデータベースと同様に、データベース はテーブルのコレクションです。したがって、この単純な例では単なる名前です。Snowflake コンソールからこのようにして作成します:
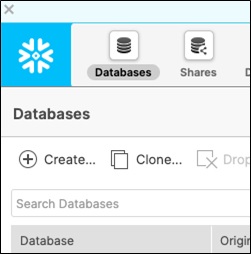
テーブルの作成
次に、ワークシートエディタを開き、以下の SQL を貼り付けて 顧客 と 注文 テーブルを作成します。どちらも variant 型のカラムが 1 つあることに注意してください。
    use database inventory;

create table customers (customer variant);

create table orders(orders variant);
JSON データを S3 にアップロード
Amazon S3 コンソールまたは AWS CLI コマンドラインを使用してデータを S3 にコピーします:
    aws s3 cp customers.json s3:/(bucket name)

aws s3 cp orders.json s3://(bucket name)
JSON データを Snowflake にバルクロード
顧客と注文データを Snowflake にこのようにコピーします。その S3 バケットには両方のファイルが含まれているため、PATTERN を使用して名前を指定します。これには任意の正規表現を使用できます。
    copy into customers
  from @GLUEBMCWALKERROWE
  FILE_FORMAT=(TYPE= 'JSON')
  PATTERN= 'customers.json';
1 つの厄介な機能は、すべてのクエリ チェックボックスを選択しないと、実行 ボタンが有効にならないことです:
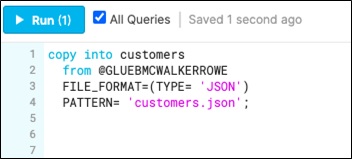
SQL を実行する際、ワークシートはこのように表示されます。
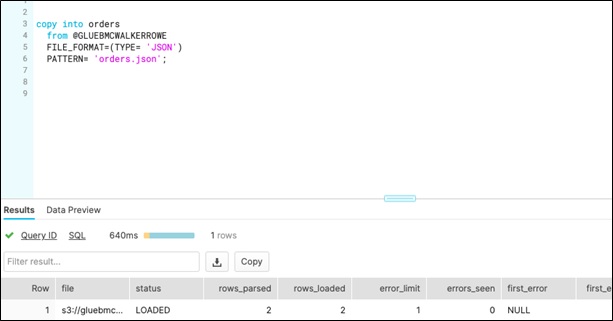
その後、ファイル をクリックして、読み込まれたデータを確認します。
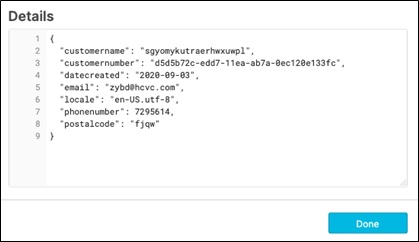
BMC、Control-M が Snowflake をサポート
BMC は Snowflake テクノロジーアライアンスパートナープログラムのメンバーです。Snowflake のクラウドデータプラットフォームは、Snowflake の市場をリードするクラウドデータウェアハウスと Control-M を使用して、データ駆動型企業を加速するのに役立ちます。
追加リソース
このようなチュートリアルについては、これらのリソースを探ってください:
- BMC 機械学習およびビッグデータブログ
- AWS ガイド、15 の記事とチュートリアルを含む
- Amazon Braket クラウドコンピューティング: 始める方法

Snowflake ガイド
- Snowflake 101: Snowflake データクラウドの紹介
- Amazon S3 データを Snowflake にインポートする方法
- Snowflake で JSON データをクエリする方法
- S3 から Snowflake への CSV ファイルの読み込み
- Snowflake: 分析および統計関数の使用
- Snowflake ウィンドウ関数: パーティションおよび順序による
- Snowflake ラグ関数と移動平均
- Snowflake SQL 集約関数とテーブル結合
- Snowflake におけるユーザー定義関数 (UDF)
- Snowflake ストリームの作成と使用
- Snowflake におけるストアドプロシージャの使用
- Snowflake と Redshift: 違いと選択方法
これらの投稿は私自身の意見であり、必ずしも BMC の立場、戦略、または意見を表すものではありません。