




ポイント: Amazon SageMakerとControl-Mを使用した金融詐欺検出の自動化された機械学習パイプラインは、統合されたデータプロセスを通じて効率と精度を向上させます。このソリューションは、進化する詐欺パターンに適応するために、さまざまなAWSサービスを活用します。
- 最適な詐欺検出のためにロジスティック回帰や決定木のようなモデルを活用します。
- Control-Mを使用して効率的なワークフロー管理のためにエンドツーエンドの自動化を実装します。
BMC & AWSロゴ
BMC & AWSロゴ
モデルのトレーニングと評価は、機械学習(ML)ベースの詐欺検出システムの効果が、詐欺取引を正確に特定し、偽陽性を最小限に抑える能力に依存しているため、決済詐欺検出において基本的です。金融詐欺の高いボリューム、速度、進化する性質を考慮すると、適切に訓練され、継続的に評価されたモデルは、精度と効率を維持するために不可欠です。詐欺検出には、大規模なトランザクションデータセットを分析し、詐欺行為を特定するためのスケーラブルで自動化された効率的なアプローチが必要です。
このブログでは、Amazon Web Services(AWS)ソリューションに基づくML駆動の詐欺検出パイプラインを提示します—Amazon SageMaker、Amazon Redshift、Amazon EKS、Amazon Athena—そしてControl-Mを使用してシームレスな自動化、スケジューリング、ワークフロー管理を確保します。目標は、3つのモデル—ロジスティック回帰、決定木、マルチレイヤパーセプトロン(MLP)分類器を、精度、再現率、正確性という3つのベクトルにわたってトレーニングすることです。結果は、どのモデルを本番環境に昇格させることができるかを決定するのに役立ちます。
モデルのトレーニングと評価は結果ですが、トレーニングと評価はより大きなパイプラインの一部です。このブログでは、示されたパイプラインが、データ抽出と前処理からモデルのトレーニング、評価、結果の視覚化に至るまで、各段階での自動化を統合しています。Control-Mのオーケストレーション機能を活用することで、ワークフローは最小限の手動介入、最適化されたリソース利用、相互依存タスクの効率的な実行を確保します。
プロセスフロー:
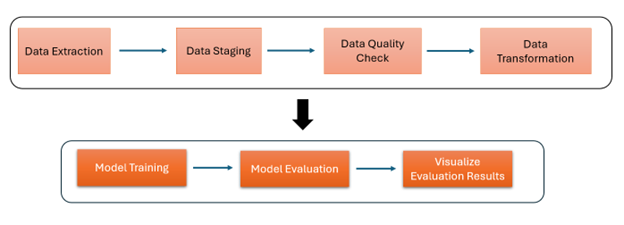
主要なアーキテクチャのハイライトには、
- Amazon RedshiftからAmazon S3へのデータの自動抽出と移動をControl-M Managed File Transfer (MFT)を使用
- AWS LambdaとKubernetes(Amazon EKS)を使用したデータ検証と前処理のオーケストレーション
- スケーラブルなコンピュートリソースを使用したAmazon SageMakerでのモデルのトレーニングと評価の自動化
- Amazon AthenaとQuickSightを使用したパフォーマンスモニタリングと視覚化のスケジュール
- Control-Mによるエンドツーエンドのワークフローオーケストレーション、障害耐性、依存関係管理、最適化されたスケジューリングを実現
本番環境では、大規模データ、モデルの再トレーニングサイクル、継続的な監視を扱う複雑さのために、MLパイプラインを手動で実行することは現実的ではありません。Control-Mをワークフローオーケストレーションに統合することで、このソリューションはスケーラビリティ、効率、リアルタイムの詐欺検出を確保し、運用オーバーヘッドを削減します。このブログでは、ベストプラクティス、セキュリティ上の考慮事項、および組織が堅牢な自動化とオーケストレーション戦略で詐欺検出システムを構築および最適化する手助けをするための教訓についても説明します。
このワークフローの中核サービスはAmazon SageMakerであり、Control-M SageMaker統合を使用してSageMaker MLパイプラインをオーケストレーションすることで、チームはエンタープライズスケジューリング、依存関係管理、およびモデルトレーニングライフサイクル全体にわたる監査トレイルを得ることができます。Amazon SageMaker Pipelinesを使用してMLワークフローを自動化したことで、複雑なMLワークフローをオーケストレーションするための強力なフレームワークが提供されました。その結果、AWSのML機能とデータ処理およびストレージサービスを組み合わせた詐欺検出ソリューションが実現しました。このアプローチは、開発を加速するだけでなく、本番環境でのスケーラビリティと信頼性を確保します。
データセットの概要
この演習で使用されるデータセットは、Kaggleから取得されており、実世界に近いデータでモデルのパフォーマンスを評価するための優れた基盤を提供します。
この分析に使用されるKaggleデータセットは、金融取引の合成表現であり、実世界の複雑さを再現するように設計されており、詐欺行為を統合しています。アフリカの国のモバイルマネーサービスの金融ログから集約されたデータを使用したPaySimシミュレーターから派生したこのデータセットは、詐欺検出および金融分析研究の貴重なリソースです。
データセットには以下の特徴が含まれます:
- step: シミュレーションされた30日間の時間単位(時間)。
- type: 現金の入金、出金、デビット、支払い、転送などの取引タイプ。
- amount: 現地通貨での取引価値
- nameOrig: 取引を開始した顧客。
- oldbalanceOrg/newbalanceOrig: 取引前後の開始顧客の残高。
- nameDest: 取引の受取人。
- oldbalanceDest/newbalanceDest: 取引前後の受取人の残高。
- isFraud: 詐欺行為を含む取引を特定します。
- isFlaggedFraud: 大規模な未承認の転送をフラグ付けします。
アーキテクチャ
このパイプラインは以下のアーキテクチャを持ち、Control-Mを使用してオーケストレーションされます。
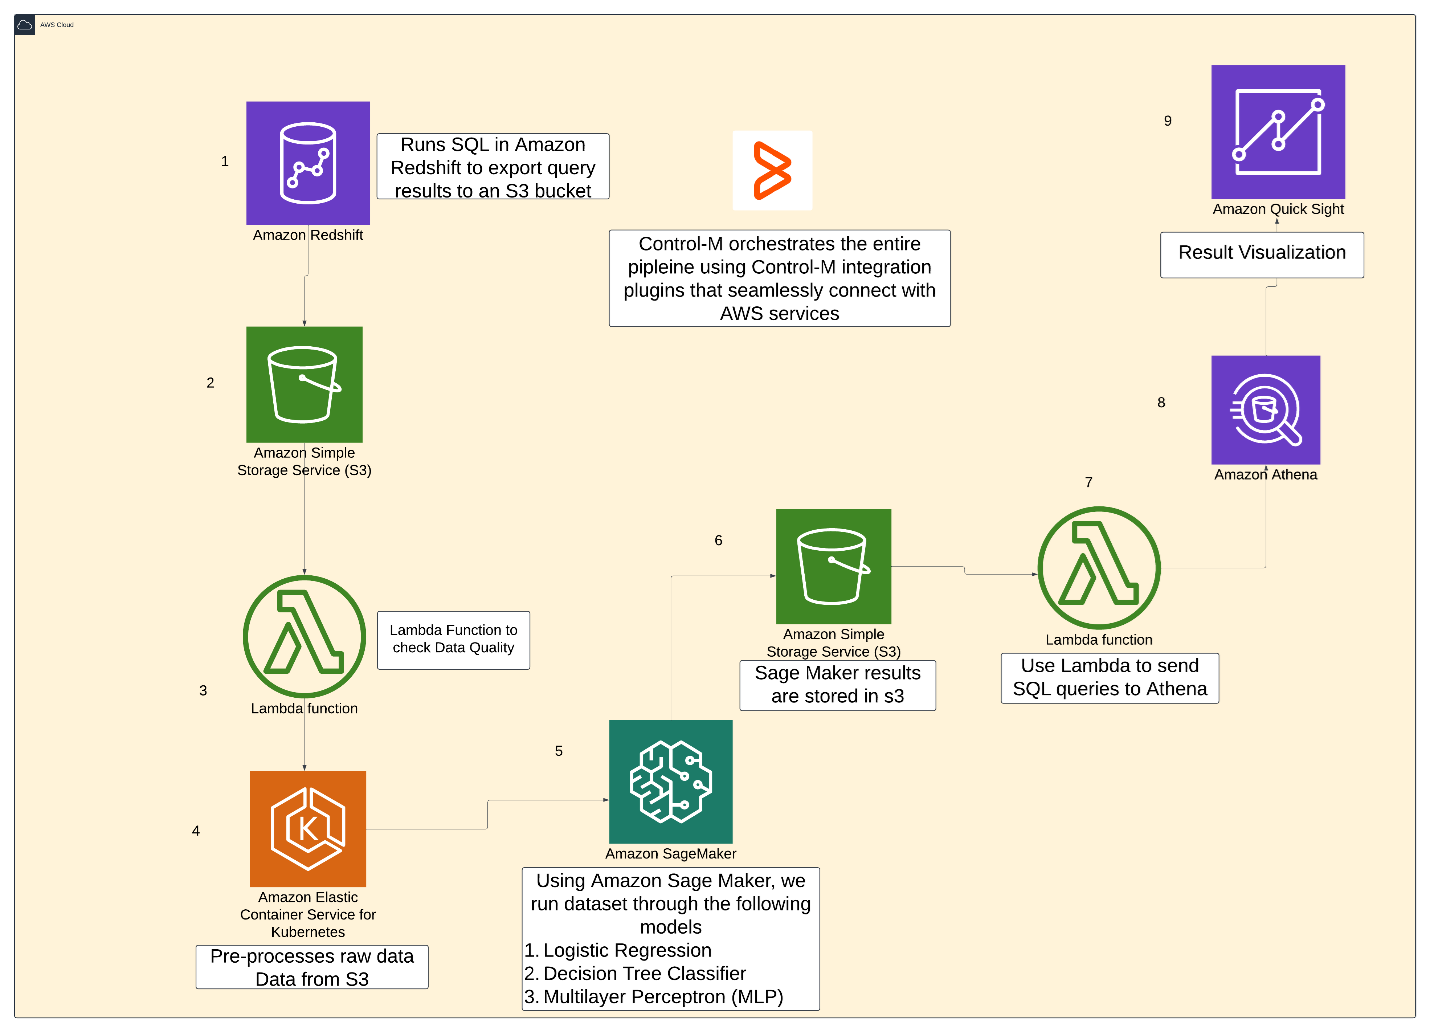
Amazon SageMaker:
注意: 使用されるすべてのコードアーティファクトは、こちらのリンクで入手できます。
このアーキテクチャで使用されるControl-M統合プラグイン
この分析パイプラインをオーケストレーションするために、さまざまなプラットフォームやサービスにシームレスに接続するControl-M統合プラグインを活用します。
-
- Control-M for SageMaker:
- Amazon SageMakerでMLモデルのトレーニングジョブを実行します。
- SageMakerと統合し、トレーニングジョブをトリガーし、進捗を監視し、出力を取得します。
- Control-M for Kubernetes:
- データ処理と正規化のためにAmazon EKS環境内でPythonスクリプトを実行します。
- データ準備プロセスの一部としてコンテナ化されたジョブを実行するのに最適です。
- Control-M Managed File Transfer:
- Amazon S3バケットと他のストレージサービス間のファイル移動を容易にします。
- 分析の準備のために安全で自動化されたデータ転送を確保します。
- Control-M Databases:
- 複数のデータベースプラットフォーム全体で、SQLスクリプト、ストアドプロシージャ、およびデータベース管理タスクのスケジューリングと実行を合理化し、データベース操作の自動化と一貫性を確保します。
- Control-M for AWS Lambda:
- AWS Lambda関数のスケジューリングと実行をシームレスに行い、サーバーレスワークフローを自動化し、イベント駆動型プロセスをトリガーし、クラウドベースのタスクを効率的に管理します。
- Lambda関数のオーケストレーション、監視、そして自動化を、より広範なエンタープライズワークフロー内で確保し、運用の効率を改善し、手動介入を減らします。
- Control-M for SageMaker:
このアーキテクチャで使用されるAWSサービス
- Amazon S3: Amazon S3は完全に管理されたオブジェクトストレージサービスです。
- Amazon SageMaker: Amazon SageMakerは完全に管理されたMLサービスです。
- Amazon EKS: Amazon Elastic Kubernetes Service(Amazon EKS)は、AWSクラウドとオンプレミスデータセンターの両方でKubernetesをシームレスに実行できる完全に管理されたKubernetesサービスです。
- Amazon Redshift: Amazon Redshiftは、AWSが提供する人気のあるクラウドデータウェアハウスです。
Kubernetes環境の設定
Amazon EKS Kubernetes環境は、パイプラインのデータ前処理ステージの中心です。データをMLモデルに渡す前に、データをクリーンアップ、正規化、構造化するPythonスクリプトを実行します。Kubernetes環境の設定には、以下のステップが含まれます:
- Amazon EKS クラスター設定:
- Terraformを使用してAmazon EKSクラスターを作成するか、任意のクラウドプロバイダーでKubernetes環境を設定します。
- Kubernetesノードがクラスターと通信できることを確認します。
- コンテナ化されたPythonスクリプト:
- 前処理スクリプト用のコンテナイメージをAmazon Elastic Container Registry (ECR)にビルドしてプッシュします。
- スクリプトを実行するためにKubernetesジョブをデプロイします。
同様のワークフローのためのKubernetes環境の設定に関する詳細なガイドは、このブログを参照してください。ここでは、Kubernetes設定プロセスをステップバイステップで説明しています。
同様のパイプラインでSnowflakeを設定するための包括的な手順については、このブログを参照してください。
ワークフローの概要
- Redshift_Unloadジョブ
- アクション: Amazon Redshiftのテーブルからデータを抽出し、Amazon S3に保存するSQLスクリプト(copy_into_s3.sql)を実行します。
- 目的: 生データをアクセス可能なS3バケットに移動し、後続の変換を行うため。
- 次のステップ: S3からS3へのデータ転送をトリガーします。
- S3からS3へのデータ転送ジョブ
- アクション: Control-MのManaged File Transfer (MFT)を使用して、データセットをsam-sagemaker-warehouse-bucketからbf-sagemakerバケットに移動します。
- 目的: データが前処理のために正しい場所にあることを確保し、Synthetic_Financial_datasets_log.csvに名前を変更します。
- 次のステップ: Data_Quality_Checkジョブをトリガーします。
- データ品質チェックジョブ
- アクション: データセットを検証するためにAWS Lambda関数(SM_ML_DQ_Test)を実行します。
- 目的: CSVファイルに5列以上が含まれ、1,000行以上であることを確認し、MLパイプラインに不正確または不完全なデータが入らないようにします。
- 次のステップ: データ変換のためにEKS-Preprocessing-jobをトリガーします。
- EKS-Preprocessing-Job
- アクション: Amazon S3に保存されたデータセットをクリーンアップおよび変換するためにKubernetesジョブを実行します。
- 目的:
- コンテナ内でPythonスクリプト(main.py)を実行して、Synthetic_Financial_datasets_log.csvを処理します。
- クリーンで構造化されたデータセット(processed-data/output.csv)を生成します。
- 構成の詳細:
- イメージ: Amazon ECRに保存されたnew-fd-repo
- 環境変数: S3の入力/出力ファイルの場所を定義します
- リソース割り当て: 2Giメモリ、1 CPUを使用(4Giメモリ、2 CPUsにスケールアップ可能)
- IAM権限: S3アクセス用のKubernetesサービスアカウントを使用します。
- ログ記録とクリーンアップ: ログを取得し、完了後にジョブを削除します。
- 次のステップ: Amazon SageMakerトレーニングジョブをトリガーします。
- Amazon SageMaker_TE_Pipeline
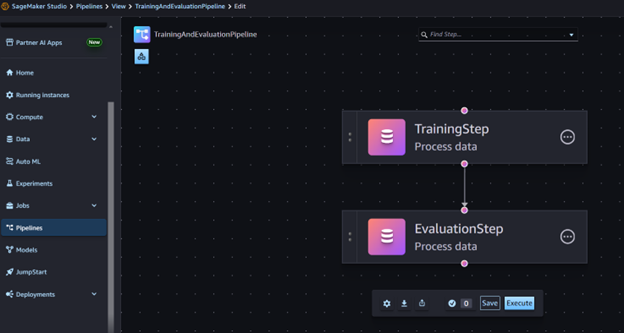
- アクション: Amazon SageMakerでTrainingAndEvaluationPipelineを実行します。
- 目的:
- 前処理されたデータセット(processed-data/output.csv)上で複数のMLモデルをトレーニングおよび評価します。
- トレーニング済みモデルアーティファクトと評価メトリックをS3バケットに保存します。
- 効率的な処理のためにリソースを自動的にスケールします。
- 次のステップ: 結果を視覚化のためにAthenaに保存するLoad_Amazon_Athena_Tableをトリガーします。
- Load_Amazon_Athena_Tableジョブ
- アクション: AWS Lambda関数(athena-query-lambda)を実行して評価メトリックをAmazon Athenaにロードします。
- 目的:
- SQLクエリを実行して、Athenaテーブル(evaluation_metrics)を作成/更新します。
- QuickSightがモデルパフォーマンス結果をクエリして視覚化できるようにします。
ステップの接続方法
- Redshift → S3転送: データがAmazon Redshiftから抽出され、Amazon S3に移動されます。
- データの検証と前処理: データ品質チェックがクリーンな入力を保証し、Kubernetesを使用して変換を行います。
- MLトレーニング: Amazon SageMakerが複数のMLモデルをトレーニングおよび評価します。
- AthenaとQuickSightの統合: モデル評価結果がAthenaを通じてクエリされ、リアルタイムでAmazon QuickSightで視覚化されます。
- 最終結果: トレーニング済みモデルとさらなる意思決定のためのパフォーマンスインサイトを提供するスムーズで自動化されたMLワークフロー。
この詳細なワークフロー概要は、各ステップを結びつけ、Kubernetes前処理ジョブとAmazon SageMakerトレーニングパイプラインの果たす重要な役割を強調します。
S3_to_S3_Transferジョブ
Data_Quality_Checkジョブ
EKS-Preprocessing-Job
Load_Amazon_Athena_Tableジョブ
概要
Control-Mワークフローディフィニション
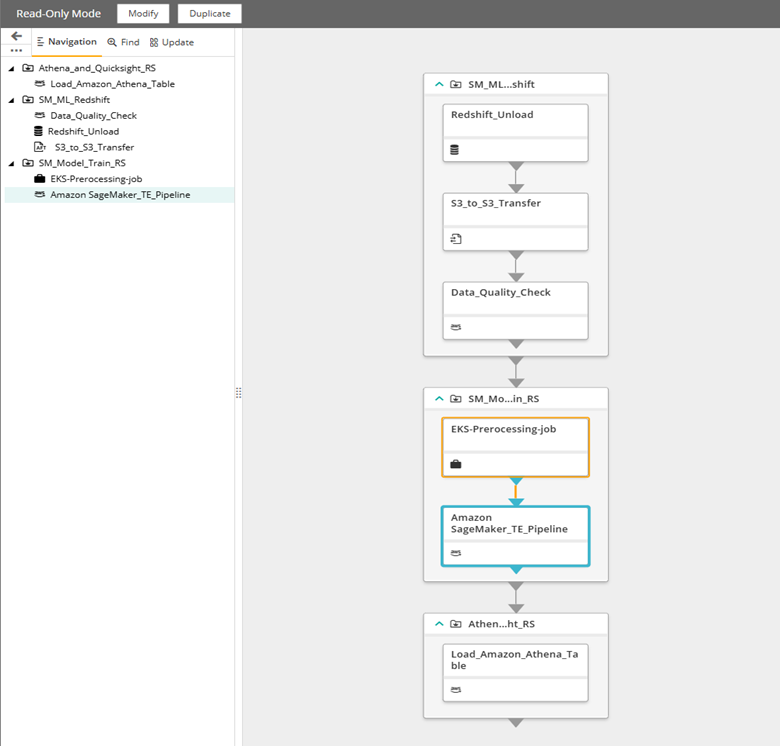
次のセクションでは、これらのジョブの定義について説明します。ジョブはControl-Mの計画ドメインでドラッグアンドドロップのノーコードアプローチを使用して定義することも、JSONでコードとして定義することもできます。このブログの目的のために、コードとしてのアプローチを使用します。
Amazon Redshiftおよびファイル転送ワークフロー
Redshift_Unloadジョブ
タイプ: ジョブ:データベース:SQLスクリプト
アクション: Amazon RedshiftでSQLスクリプトを実行し、RedshiftテーブルからデータをS3バケットにアンロードします。
説明: このジョブは、Control-Mエージェントに保存された事前定義されたSQLスクリプト(copy_into_s3.sql)を実行して、Redshiftから構造化データをAmazon S3にエクスポートします。アンロードされたデータは、MLパイプラインでの後続の処理のために準備されます。
依存関係: このジョブは独立して実行されますが、成功裏に完了した後にCopy_into_bucket-TO-S3_to_S3_MFT-262イベントをトリガーします。
構成の詳細: Redshift SQLスクリプトの実行
SQLスクリプト:
イベントハンドリング
構成の詳細:
構成の詳細:
依存関係: このジョブは独立して実行されますが、完了後にsagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262イベントをトリガーし、処理されたデータがSageMakerでのモデルのトレーニングに準備が整ったことを知らせます。
構成の詳細:
構成の詳細:
構成の詳細:
    UNLOAD ('SELECT * FROM SageTable')
TO 's3://sam-sagemaker-warehouse-bucket/Receiving Folder/Payments_RS.csv'
IAM_ROLE 'arn:aws:iam::xyz:role/jogoldbeRedshiftReadS3'
FORMAT AS csv
HEADER
ALLOWOVERWRITE
PARALLEL OFF
DELIMITER ','
MAXFILESIZE 6GB; -- 1GB max per file
- トリガーするイベント:
- Copy_into_bucket-TO-S3_to_S3_MFT-262 → データが正常にS3にアンロードされ、さらなる処理または転送の準備が整ったことを示します。
以下に例を示します:
以下に例を示します:
以下に例を示します:
以下に例を示します:
以下に例を示します:
以下に例を示します:
    "Redshift_Unload" : {
"Type" : "Job:Database:SQLScript",
"ConnectionProfile" : "ZZZ-REDSHIFT",
"SQLScript" : "/home/ctmagent/redshift_sql/copy_into_s3.sql",
"Host" : "<>",
"CreatedBy" : "<>",
"RunAs" : "ZZZ-REDSHIFT",
"Application" : "SM_ML_RS",
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
}
}
タイプ: ジョブ:ファイル転送
アクション: Control-M Managed File Transfer (MFT)を使用して、1つのS3バケットから別のS3バケットにファイルを転送します。
説明: このジョブは、sam-sagemaker-warehouse-bucketからデータセット(Payments_RS.csv000)をbf-sagemakerに移動し、プロセス中にSynthetic_Financial_datasets_log.csvに名前を変更します。これにより、データがさらなる処理と検証の準備が整います。
依存関係: このジョブは、Redshiftから正常にエクスポートされたデータがS3に保存されたことを確認するために、Copy_into_bucket-TO-S3_to_S3_MFT-262を待機します。
- ソースバケット: sam-sagemaker-warehouse-bucket
- ソースパス: /Receiving Folder/Payments_RS.csv000
- 宛先バケット: bf-sagemaker
- 宛先パス: /temp/
- 宛先での名前変更ファイル: Synthetic_Financial_datasets_log.csv
- 接続プロファイル: ソースおよび宛先S3バケットの両方にMFTS3プロファイルを使用します。
- ファイルウォッチャー: 最小検出サイズが200 MBのソースファイルの準備状況を監視します。
イベントハンドリング
- 待機するイベント:
- Copy_into_bucket-TO-S3_to_S3_MFT-262 → データがRedshiftからS3にエクスポートされてから、他のS3バケットに転送されることを確認します。
- トリガーするイベント:
- S3_to_S3_MFT-TO-Data_Quality_Check → データセットが検証の準備が整ったことを次のステップに通知します。
- SM_ML_Snowflake_copy-TO-SM_Model_Train_copy → 処理されたデータを使用してモデルトレーニングプロセスの開始を通知します。
    "S3_to_S3_Transfer" : {
"Type" : "Job:FileTransfer",
"ConnectionProfileSrc" : "MFTS3",
"ConnectionProfileDest" : "MFTS3",
"S3BucketNameSrc" : "sam-sagemaker-warehouse-bucket",
"S3BucketNameDest" : "bf-sagemaker",
"Host" : : "<>",
"CreatedBy" : : "<>",
"RunAs" : "MFTS3+MFTS3",
"Application" : "SM_ML_RS",
"Variables" : [ {
"FTP-LOSTYPE" : "Unix"
}, {
"FTP-CONNTYPE1" : "S3"
}, {
"FTP-ROSTYPE" : "Unix"
}, {
"FTP-CONNTYPE2" : "S3"
}, {
"FTP-CM_VER" : "9.0.00"
}, {
"FTP-OVERRIDE_WATCH_INTERVAL1" : "0"
}, {
"FTP-DEST_NEWNAME1" : "Synthetic_Financial_datasets_log.csv"
} ],
"FileTransfers" : [ {
"TransferType" : "Binary",
"TransferOption" : "SrcToDestFileWatcher",
"Src" : "/Receiving Folder/Payments_RS.csv000",
"Dest" : "/temp/",
"ABSTIME" : "0",
"TIMELIMIT" : "0",
"UNIQUE" : "0",
"SRCOPT" : "0",
"IF_EXIST" : "0",
"DSTOPT" : "1",
"FailJobOnSourceActionFailure" : false,
"RECURSIVE" : "0",
"EXCLUDE_WILDCARD" : "0",
"TRIM" : "1",
"NULLFLDS" : "0",
"VERNUM" : "0",
"CASEIFS" : "0",
"FileWatcherOptions" : {
"VariableType" : "Global",
"MinDetectedSizeInBytes" : "200000000",
"UnitsOfTimeLimit" : "Minutes"
},
"IncrementalTransfer" : {
"IncrementalTransferEnabled" : false,
"MaxModificationAgeForFirstRunEnabled" : false,
"MaxModificationAgeForFirstRunInHours" : "1"
},
"DestinationFilename" : {
"ModifyCase" : "No"
}
} ],
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"eventsToWaitFor" : {
"Type" : "WaitForEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
} ]
},
"eventsToDelete" : {
"Type" : "DeleteEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
}
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "SM_ML_Snowflake_copy-TO-SM_Model_Train_copy"
} ]
}
}
タイプ: ジョブ:AWS Lambda
アクション: CSVファイルのデータ品質チェックを行うためにAWS Lambda関数を実行します。
説明: このジョブは、データセットの構造と整合性を検証するためにSM_ML_DQ_TestというLambda関数を呼び出します。CSVファイルに少なくとも5列があり、1,000行以上のデータが含まれていることを確認してから、下流の処理を進めます。ジョブは、レビューのために実行詳細をログに記録します。
依存関係: ジョブは、データ検証を実行する前に、S3バケット間のファイル転送が完了していることを確認するためにイベントS3_to_S3_MFT-TO-Data_Quality_Checkを待機します。
- Lambda関数名: SM_ML_DQ_Test
- 実行環境:
- ホスト: ip-172-31-18-169.us-west-2.compute.internalで実行
- 接続プロファイル: JOG-AWS-LAMBDA
- RunAs: JOG-AWS-LAMBDA
- 検証基準:
- ✅ CSVファイルは少なくとも5列を持たなければなりません。
- ✅ CSVファイルは1,000行以上を含む必要があります。
- ログ: デバッグと検証追跡のために有効(出力にログを追加: チェック済み)。
イベントハンドリング:
- 待機するイベント:
- ジョブは、データセットが正常に転送され、検証のために利用可能であることを確認するためにS3_to_S3_MFT-TO-Data_Quality_Checkを待機します。
- 削除するイベント:
- イベントS3_to_S3_MFT-TO-Data_Quality_Checkは、ワークフローの連続性を確保し、再処理を防ぐために処理後に削除されます。
実行環境
依存関係: ジョブは、トレーニングが開始される前に、前処理ジョブが完了し、クリーンなデータセットが利用可能であることを確認するためにイベントsagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262を待機します。
タイプ: ジョブ:AWS Lambda
アクション: 評価結果をAmazon AthenaテーブルにロードするためにAWS Lambda関数を実行します。
依存関係: ジョブは、結果をAthenaにロードする前に、SageMakerのトレーニングおよび評価プロセスが完了していることを確認するためにイベントSM_Model_Train_copy-TO-Athena_and_Quicksight_copyを待機します。
    "Data_Quality_Check" : {
      "Type" : "Job:AWS Lambda",
      "ConnectionProfile" : "JOG-AWS-LAMBDA",
      "Append Log to Output" : "checked",
      "Function Name" : "SM_ML_DQ_Test",
      "Parameters" : "{}",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "Description" : "This job performs a data quality check on CSV file to make sure it has at least 5 columns and more than 1000 rows",
      "RunAs" : "JOG-AWS-LAMBDA",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToWaitFor" : {
        "Type" : "WaitForEvents",
        "Events" : [ {
          "Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
        } ]
      },
      "eventsToDelete" : {
        "Type" : "DeleteEvents",
        "Events" : [ {
          "Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
        } ]
      }
    }
Amazon SageMaker: モデルのトレーニングと評価ワークフロー
タイプ: ジョブ:Kubernetes
アクション: S3バケットに保存された金融データを前処理するためにAmazon EKSクラスターでKubernetesジョブを実行します。
説明: このジョブは、bf-sagemakerに保存された生の金融データセットを処理するコンテナ化されたPythonスクリプトを実行します。入力ファイルSynthetic_Financial_datasets_log.csvを取得し、必要な変換を適用し、クリーンなデータセットをprocessed-data/output.csvとして出力します。Kubernetesジョブは、適切なリソース割り当て、セキュリティ権限、および監視のためのログ記録を確保します。
Kubernetesジョブ仕様
- イメージ: 623469066856.dkr.ecr.us-west-2.amazonaws.com/new-fd-repo
- コマンド実行: コンテナ内で以下のスクリプトを実行します:
bash
CopyEdit
python3 /app/main.py -b bf-sagemaker -i Synthetic_Financial_datasets_log.csv -o processed-data/output.csv
- 環境変数:
- S3_BUCKET: bf-sagemaker
- S3_INPUT_FILE: Synthetic_Financial_datasets_log.csv
- S3_OUTPUT_FILE: processed-data/output.csv
リソース割り当て
- 要求リソース: 2Giメモリ、1 CPU
- 制限: 4Giメモリ、2 CPUs
- ボリュームマウント: /tmpに一時ストレージをマウント
- ホスト: mol-agent-installation-sts-0で実行
- 接続プロファイル: MOL-K8S-CONNECTION-PROFILEをEKSクラスターアクセス用
- ポッドログ: 完了時にログを取得するように構成されている(ポッドログを取得:ログを取得)
- ジョブクリーンアップ: 実行後にKubernetesジョブを削除します(ジョブクリーンアップ:ジョブを削除)
イベントハンドリング:
- トリガーするイベント:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → 前処理されたデータがSageMakerモデルのトレーニングの準備が整ったことを示します。
    "EKS-Prerocessing-job" : {
      "Type" : "Job:Kubernetes",
      "Job Spec Yaml" : "apiVersion: batch/v1\r\nkind: Job\r\nmetadata:\r\n  name: s3-data-processing-job\r\nspec:\r\n  template:\r\n    spec:\r\n      serviceAccountName: default  # Ensure this has S3 access via IAM\r\n      containers:\r\n      - name: data-processing-container\r\n        image: 623469066856.dkr.ecr.us-west-2.amazonaws.com/new-fd-repo\r\n        command: [\"/bin/sh\", \"-c\", \"python3 /app/main.py -b bf-sagemaker -i Synthetic_Financial_datasets_log.csv -o processed-data/output.csv\"]\r\n        env:\r\n        - name: S3_BUCKET\r\n          value: \"bf-sagemaker\"\r\n        - name: S3_INPUT_FILE\r\n          value: \"Synthetic_Financial_datasets_log.csv\"\r\n        - name: S3_OUTPUT_FILE\r\n          value: \"processed-data/output.csv\"\r\n        resources:\r\n          requests:\r\n            memory: \"2Gi\"\r\n            cpu: \"1\"\r\n          limits:\r\n            memory: \"4Gi\"\r\n            cpu: \"2\"\r\n        volumeMounts:\r\n        - name: tmp-storage\r\n          mountPath: /tmp\r\n      restartPolicy: Never\r\n      volumes:\r\n      - name: tmp-storage\r\n        emptyDir: {}\r\n\r\n",
      "ConnectionProfile" : "MOL-K8S-CONNECTION-PROFILE",
      "Get Pod Logs" : "Get Logs",
      "Job Cleanup" : "Delete Job",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "RunAs" : "MOL-K8S-CONNECTION-PROFILE",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToAdd" : {

        "Type" : "AddEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        } ]
      }
    }
Amazon SageMaker_TE_Pipelineジョブ
タイプ: ジョブ:Amazon Sagemaker
アクション: 前処理された金融データを使用してMLモデルをトレーニングおよび評価するためのAmazon Sagemakerトレーニングおよび評価パイプラインを実行します。
説明: このジョブは、TrainingAndEvaluationPipelineを実行し、bf-sagemakerに保存された前処理されたデータセットに基づいてMLモデルをトレーニングおよび評価します。パイプラインは、モデルのトレーニング、ハイパーパラメータのチューニング、評価を自動化し、デプロイ前の最適なパフォーマンスを確保します。
- SageMakerパイプライン名: TrainingAndEvaluationPipeline
- 実行環境:
- ホスト: prodagentsで実行
- 接続プロファイル: SageMakerジョブ実行用のMOL-SAGEMAKER-CP
- RunAs: MOL-SAGEMAKER-CP
- パイプラインパラメータ:
- パラメータを追加: チェックなし(デフォルトが使用されます)
- パイプライン実行を再試行: チェックなし(失敗した実行を自動的に再試行しません)
イベントハンドリング:
- 待機するイベント:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → トレーニングを開始する前に、前処理されたデータセットが利用可能であることを確認します。
- 削除するイベント:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → トレーニングが始まると依存関係を削除します。
- SM_ML_Snowflake-TO-AWS_SageMaker_Job_1 → 以前のイベント依存関係をクリーンアップします。
    "Amazon SageMaker_TE_Pipeline" : {
      "Type" : "Job:AWS SageMaker",
      "ConnectionProfile" : "MOL-SAGEMAKER-CP",
      "Add Parameters" : "unchecked",
      "Retry Pipeline Execution" : "unchecked",
      "Pipeline Name" : "TrainingAndEvaluationPipeline",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "RunAs" : "MOL-SAGEMAKER-CP",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToWaitFor" : {
        "Type" : "WaitForEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        } ]
      },
      "eventsToDelete" : {
        "Type" : "DeleteEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        }, {
          "Event" : "SM_ML_Snowflake-TO-AWS_SageMaker_Job_1"
        } ]
      }
    }
説明: このジョブはLambda関数athena-query-lambdaをトリガーし、ML評価メトリックを含むテーブルを作成または更新するAthena SQLクエリを実行します。テーブルは、データ視覚化およびレポートのためのAmazon QuickSightとのシームレスな統合を可能にします。
- Lambda関数名: athena-query-lambda
- 実行環境:
- ホスト: airflowagentsで実行
- 接続プロファイル: JOG-AWS-LAMBDA
- RunAs: JOG-AWS-LAMBDA
- Athenaテーブルの目的:
- MLモデル評価結果を保存します。精度、再現率、スコアなどを含みます。
- パフォーマンスメトリックのSQLベースの分析を通じて簡単にクエリを実行できるようにします。
- Amazon QuickSightでの視覚化のためのデータを準備します。
イベントハンドリング:
- 待機するイベント:
- SM_Model_Train_copy-TO-Athena_and_Quicksight_copy → SageMakerトレーニングおよび評価プロセスが完了したことを確認して、Athenaを更新します。
- 削除するイベント:
- SM_Model_Train_copy-TO-Athena_and_Quicksight_copy → データを正常にロードした後にイベント依存関係をクリーンアップします。
    "Load_Amazon_Athena_Table" : {
      "Type" : "Job:AWS Lambda",
      "ConnectionProfile" : "JOG-AWS-LAMBDA",
      "Function Name" : "athena-query-lambda",
      "Parameters" : "{}",
      "Append Log to Output" : "unchecked",
      "Host" : "airflowagents",
      "CreatedBy" : "[email protected]",
      "RunAs" : "JOG-AWS-LAMBDA",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      }
    },

    "eventsToWaitFor" : {
      "Type" : "WaitForEvents",
      "Events" : [ {
        "Event" : "SM_Model_Train_copy-TO-Athena_and_Quicksight_copy"
      } ]
    },
    "eventsToDelete" : {
      "Type" : "DeleteEvents",
      "Events" : [ {
        "Event" : "SM_Model_Train_copy-TO-Athena_and_Quicksight_copy"
      } ]
    }
  }
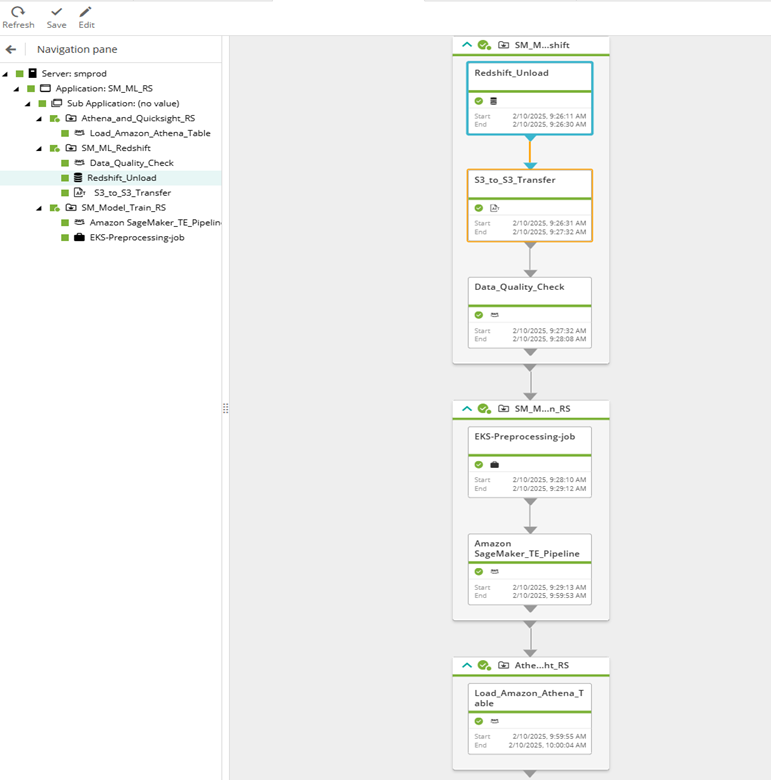
ワークフロー実行:
Amazon SageMakerにおけるトレーニングと評価のステップ
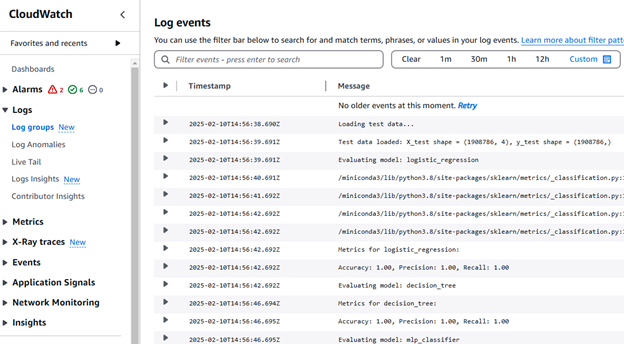
CloudWatchでのパイプライン実行ログ:
Control-Mでのワークフロー実行
Amazon SageMakerの役割:
データセットを分析し、詐欺のパターンを特定するために、Amazon SageMakerで利用可能な3つのMLモデルを通じてデータを実行します: ロジスティック回帰、決定木分類器、およびマルチレイヤパーセプトロン(MLP)。これらのモデルはそれぞれ独自の強みを提供し、パフォーマンスを評価し、詐欺検出の最も効果的なアプローチを選択することを可能にします。
- ロジスティック回帰: ロジスティック回帰は、入力特徴に基づいてイベント(例: 詐欺)の確率を予測する線形モデルです。シンプルで解釈可能であり、二項分類タスクに対して効果的です。
- 決定木分類器: 決定木は、特徴値に基づいてデータセットを分割するルールベースのモデルです。各分岐は意思決定ルールを表し、モデルの解釈が容易で、構造化データにおけるパターンの特定に適しています。
- マルチレイヤパーセプトロン: MLPは、データ内の複雑で非線形の関係を捉えるために設計されたニューラルネットワークの一種です。複数のニューロン層で構成されており、より単純なモデルでは明らかでない微妙なパターンを検出するのに理想的です。
これらのモデルを通じてデータセットを実行することにより、パフォーマンスを比較し、詐欺活動を検出するのに最も効果的なものを特定することを目指します。精度、再現率、正確性といったメトリックが評価を導くでしょう。
Trainmodels.py:
このスクリプトは、詐欺検出のためのMLモデルをトレーニングするためのデータを処理します。最初に入力データセットを検証し、読み込むことでデータの整合性を確保し、欠損または無効な値を処理し、ターゲット列がFraudであることを確認します。その後、データはトレーニングセットとテストセットに分割され、将来の使用のために保存されます。ロジスティック回帰、決定木分類器、およびMLPがデータセット上でトレーニングされ、トレーニング済みモデルがデプロイまたはさらなる評価のために.pklファイルとして保存されます。パイプラインは、包括的なエラーハンドリングとモジュール性を持つ堅牢な実行を保証し、詐欺取引を検出するための効率的なソリューションとなります。
Evaluatemodels.py:
このスクリプトは、テストデータセットを使用して詐欺検出のためのMLモデルを評価します。テストデータと3つの事前トレーニングされたモデルを読み込み、パフォーマンスを評価します。各モデルについて、精度、再現率、分類レポート、混同行列などのメトリックを計算します。結果は、さらなる分析のためにJSONファイルに保存されます。このスクリプトは、利用可能なモデルを反復処理し、欠損ファイルやエラーを堅牢に処理し、モデルのパフォーマンスの包括的な評価パイプラインとなります。
結果と成果
Amazon QuickSightでのモデル評価結果。
Amazon QuickSightでのモデル評価結果
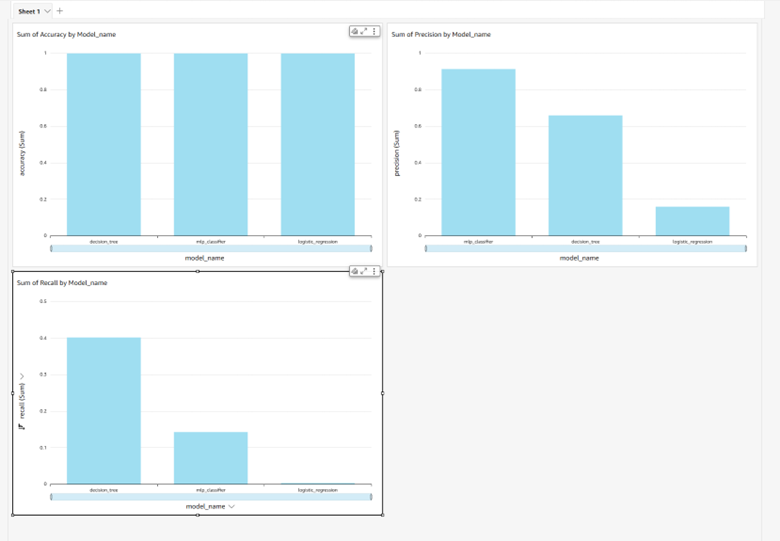
決定木分類器モデルは、精度と再現率に関して最もバランスの取れたパフォーマンスを示し、次いでMLPが続きます。ロジスティック回帰は、高い精度にもかかわらず、正のインスタンスを正しく特定するのに苦労します。
自動化されたスケーラブルで効率的なMLパイプラインの構築は、今日の急速に進化する金融環境における詐欺との戦いに不可欠です。Amazon SageMaker、Redshift、EKS、AthenaなどのAWSサービスを活用し、Control-Mをオーケストレーションに組み合わせることで、この詐欺検出ソリューションはシームレスなデータ処理、リアルタイムモデルのトレーニング、および継続的な監視を確保します。
このワークフローの重要な柱はAmazon SageMakerであり、自動化されたモデルのトレーニング、ハイパーパラメータのチューニング、およびスケーラブルな推論を可能にします。MLモデルのデプロイメントを簡素化し、組織が複数のモデル—ロジスティック回帰、決定木分類器、MLP—をトレーニングおよび評価して、最も効果的な詐欺検出戦略を決定することを可能にします。トレーニング、評価、およびモデル監視のための組み込みの自動化により、詐欺検出モデルは最新の状態を維持し、適応し、実世界のトランザクションに最適化されます。
自動化とオーケストレーションの重要性は過小評価できません。これがなければ、詐欺検出のための生産グレードのMLパイプラインを維持することは、厄介で非効率的で、遅延が発生しやすくなります。Control-Mはエンドツーエンドの自動化を可能にし、データの取り込みからAmazon SageMakerでのモデルのトレーニング、およびAthenaでの評価に至るまで、複雑なワークフローのスムーズな実行を確保します。これにより、手動介入が減り、リソースの割り当てが最適化され、全体的な詐欺検出の効率が向上します。
さらに、モデルのトレーニングと評価は、詐欺検出の成功の中心にあります。Amazon SageMaker内で新しいトランザクションデータに対して継続的にトレーニングし、進化する詐欺パターンに適応し、重要なメトリックを使用してパフォーマンスを厳密に評価することで、組織は高い詐欺検出精度を維持しながら、偽陽性を最小限に抑えることができます。
詐欺者が新しい攻撃戦略を開発し続ける中、金融機関や決済処理業者は、適応型のAI駆動の詐欺検出システムを導入して先手を打たなければなりません。Amazon SageMakerを使用してスケーラブルで自動化されたMLパイプラインを実装することで、組織はセキュリティを強化し、財務損失を減らすだけでなく、顧客の信頼とトランザクション承認率も向上させることができます。
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。