




ポイント: データベース自動化は、プロビジョニング、バックアップ、セキュリティなどのタスクを自動化することにより、データ管理を強化し、データの可用性とコンプライアンスを確保します。パフォーマンスを最適化し、データ損失や規制違反に関連するリスクを低減します。
- データ処理、プロビジョニング、ロードバランシングを自動化し、最適なパフォーマンスを実現します。
- 災害復旧、セキュリティの改善、コンプライアンス管理を通じてリスクを軽減します。
データベースはデータを含むスプレッドシートであり、情報を保存するための便利なツールです。実際、現代の組織の運営に不可欠です。
データベースは、ユーザー、システム、および組織に関する機密性が高く、利益を生む情報資産を含むことがよくあります。この情報は、技術ソリューションを活用するデータベース管理者 (DBA)に割り当てられた複雑な管理操作を通じて維持、処理、更新されます。
しかし、今日ではこれらの操作は予測可能で繰り返し行われ、大規模に実施されるため、手動のDBAスキルでは不十分な場合が多くなっています。だからこそ、ますます多くの企業がデータベース自動化、つまりデータベース管理操作を自動化するプロセスに目を向けています。
この記事では、データベース自動化の考慮事項とベストプラクティスについて説明します。
データベース自動化の仕組み
データベース自動化ツールは、DBMSおよび関連するインフラストラクチャ操作タスクに適用されるさまざまな目的特化型の自動化機能を提供します。以下は、最も一般的なデータベース自動化機能です。
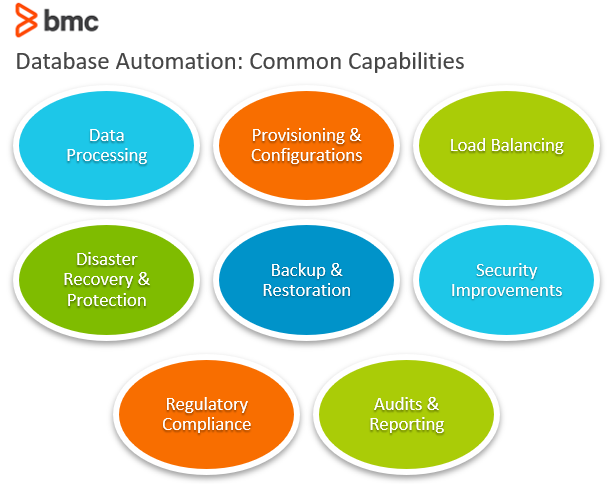
データ処理タスクには、データの収集、複製、クリーンアップ、および移行タスクの自動化が含まれ、データをより意味のある、安全な、信頼性のある、そして必要に応じて即座に処理可能なものにします。
プロビジョニングと構成
ここでは、ソフトウェア開発ライフサイクル (SDLC)のさまざまなタスクや段階のために、データベース環境とリポジトリのセットアップを自動化できます。プロビジョニングされたデータベースクラスターは、開発、品質保証 (QA)、およびIT運用チームの要件に応じて、安全で高性能で信頼性のあるものである必要があります。
ロードバランシングを自動化することで、以下の観点からデータベースのパフォーマンスを最適化します:
- スループット
- レイテンシ
- リソースの利用
ワークロードは、マルチクラウドおよびハイブリッドインフラストラクチャ環境のサーバー間でバランスをとり、全体のシステムパフォーマンス、安全性、およびコストの投資を最適化します。
災害復旧と保護
重要な情報資産を失うことは、組織が規制ガイドラインや顧客の期待に沿って運営する能力を損なう可能性があります。したがって、組織は次のようなリスク緩和戦略を導入する必要があります:
- データベースの冗長性
- 地理的に異なるサーバー地域への分散
- 侵害やサイバー攻撃に対する自動トリガー防御システム
バックアップと復元
システムは、ネットワーク侵入が機密性の高いミッションクリティカルなデータベースの整合性を損なう場合のリスクを減らすために、特定のインスタンスで自動的にバックアップおよび復元するようにプログラムされるべきです。
セキュリティの改善
強力な認証およびアクセス管理プロセスを展開します。特定の組織ポリシーに準拠するために特定のデータベースシステムを登録することは困難であり、適切なセキュリティポリシーが施行されない限り、いくつかのセキュリティの問題が発生する可能性があります。
規制コンプライアンス
ほとんどの組織はさまざまなコンプライアンス要件の対象です。たとえば、GDPR規制は、適切なユーザーの同意なしに外部パートナーと関わる前にユーザーデータの匿名性を要求します。
この場合、すべてのデータベースエントリは、自動化に最適な状態で、第三者ベンダーがデータを処理または利用することが許可される前に匿名化される必要があります。コンプライアンス違反は次のような結果をもたらす可能性があります:
- 高額な罰金
- 法的問題
- プライバシーを意識するユーザーマーケットにおける信頼の喪失
自動化を使用して、データベースおよびその中に含まれる情報がどのように変化するかを監視および追跡します。データベースの監査は、組織がどのように運営、システム、およびデータ資産が組織および規制ポリシーに準拠しているかを理解するのに役立ちます。
あらゆる不一致は追跡され、ビジネスに影響を与える前に即時の是正措置を引き起こす可能性があります。
データベースを自動化する方法
自動化がないと、組織はデータベース管理に対して反応的なアプローチを取ることになりますが、DBAおよびエンジニアリングチームは、データベース自動化に戦略的にアプローチする必要があります。
たとえば、自動化のルートを取る前に、次の要素を考慮してください:
- 無駄なプロセス。無駄なプロセスを自動化すると、新たなバグ、ボトルネック、および連鎖する無駄なプロセスが導入されるだけです。
- データの不整合。自動化は情報資産のルールを一般化します。データが不整合であったり、期待される構造から逸脱したりすると、自動化はデータベースに追加の不整合をもたらします。
- データベースのチューニング。動的環境に関連するパラメータは、データベースに適用する前に慎重に理解し、調査し、テストし、ベンチマークする必要があります。このプロセスは、高可用性クラスターをマルチクラウドおよびハイブリッドインフラストラクチャ環境にプロビジョニングする必要がある場合、特に困難です。
- 単純なタスク。単純なデータベース管理タスクのために自動化スクリプトを書くよりも、手動プロセスを実行する方が効率的な場合があります。
- スキーマの変更。依存関係を含むデータベースの更新プロセスは、自動化の過程で、競合、構成、権限、および広範なシステムとの接続が適切に管理されない場合、劇的に変わる可能性があります。
異常や不整合を含むデータベースを自動化するリスクを減らすためには、自動化技術やスクリプトの広範なテストを考案して実行することが重要です。早期かつ頻繁にテストを行い、範囲の制限を特定し、新たな自動化候補を見つけてください。
データベース自動化においてもう一つ重要な考慮事項は、データベースおよび基盤となるインフラストラクチャに関連する依存関係を追跡し、対処することです。すべての依存関係を考慮しない自動化スクリプトは、単一故障点となり、パフォーマンスの問題、セキュリティの抜け穴、およびコンプライアンス違反を引き起こす可能性があります。
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。