




ポイント: データOpsは、アジャイルな実践を統合することでAIのためのデータ管理を強化し、運用上の成功のために信頼できるデータを確保します。Control-Mはオーケストレーションを促進し、効果的なAIシステムに不可欠なイベント駆動のワークフローと継続的なデータ検証を可能にします。
- Control-Mはエラー検出を自動化し、エンドツーエンドの可視性を提供します。
- データOpsは信頼できるデータの提供、コラボレーションの改善、コンプライアンスの確保に焦点を当てています。
AIがデータOpsに求めるもの—オーケストレーションがそれを提供する方法
データOpsは、データパイプライン管理にアジャイルおよびDevOpsの原則を適用する実践であり、企業全体でデータワークフローを自動化、スケール、運用化します。AIに投資している組織にとって、データOpsは基盤となるものです:AIシステムには、単に素早く動くデータだけでなく、信頼でき、検証され、消費の準備が整ったデータが必要です。パイプラインの実行と信頼できる成果の間のギャップを埋めることは、現代のデータOpsの定義的な課題となっています。
なぜ多くのデータとAIイニシアチブが生産前に停滞するのか?
ほとんどの組織は、有望な概念実証を構築できます。より難しい問題は、それを生産に持ち込むことです。Forbesによると、生成AIのパイロットの大多数は生産に移行しません—それはアイデアが健全でないからではなく、それらのイニシアチブをスケールするには、パイロット環境が要求しない信頼性、統合、データ品質が必要だからです。
これは、AIだけに限らないより広い課題を反映しています。データプラットフォームやクラウド技術への継続的な投資にもかかわらず、組織は依然としてデータやAIイニシアチブをスケールで運用化するのに苦労しています。努力はパイプラインの構築やモデルのトレーニングに集中しています。より難しい問題—それらのシステムが生産で一貫して動作し、ビジネス上の重要な意思決定を支えるために必要な調整やデータ品質を確保すること—が進捗を停滞させるのです。
データOpsが組織のデータパイプライン管理の方法をどのように変えたか
データOpsは、スケールでデータイニシアチブを運用化するという根本的な課題に対処するためのフレームワークとして浮上しました。データ量が増加し、パイプラインが複雑になるにつれて、従来のアプローチは追いつくのに苦労しました。データOpsは、データ管理にアジャイルエンジニアリングとDevOpsのベストプラクティスを適用し、明確な目標を持っていました:新しい洞察を生産準備が整ったデータパイプラインに変えて、ビジネス価値を提供することです。
採用は急速に加速し、データOpsは認知された市場カテゴリに進化しました。Gartner®は、データOpsをデータマネージャー、データ消費者、および組織全体のチーム間のデータフローのコミュニケーション、継続的な統合、自動化、可視性、運用の改善に焦点を当てた協力的なデータ管理の実践として定義しています。その定義の中心にはオーケストレーションがあります:複雑なデータワークフローを管理可能にする調整、自動化、および制御です。
AIが求めるデータとは実際に何か
データOpsは組織がデータパイプラインを自動化し、スケールさせるのを助けましたが、AIシステムは基準を引き上げました。スピードだけではもはや十分ではありません。
Gartnerレポートで見る限り、AI-readyデータは以下の3つの要件を必要とします:
- 整合性—特定のユースケースに関連性があること
- 資格—生産環境向けの継続的な検証
- ガバナンス—ポリシー、コンプライアンス、トレーサビリティ
これは、データOpsが提供しなければならないものの根本的な変化を示しています。データOpsはもはや効率的にデータを移動させるだけのものではなく、インテリジェントシステムがアクションを起こすためにデータが準備されていることを確保することが重要になっています。
なぜデータ品質がオーケストレーションの問題になったのか
多くの組織がオーケストレーションを自動化していますが、データの準備と認証の実践を実装した組織ははるかに少ないです。そのギャップがAIイニシアチブが失敗する原因です。
パイプラインが準備よりもスピードを優先すると、未検証のデータがAIシステムに到達し、ビジネスの意思決定を駆動します。その結果は、パイプラインの失敗だけでなく、規模での不正確な成果です。データ品質は別々の下流チェックとして扱うことはできません。それは、ワークフロー自体に埋め込まれ、文脈でデータを検証し、準備に基づいて実行をゲートし、下流の影響を防ぎ、自動的に修正をトリガーする必要があります。そのレベルの調整がなければ、パイプラインは動作するかもしれませんが、その出力は信頼できません。
現代のデータパイプラインの複雑さ
現代のデータパイプラインは、シームレスに連携する必要がある複数のアプリケーション、データソース、インフラ技術にまたがります。組織は現在、分析パイプライン、機械学習パイプライン、RAGパイプライン、リアルタイム推論パイプラインのミックスを運用しています。各パイプラインは異なる目的に役立ちますが、すべては同じ基盤に依存しています:取り込み、ストレージ、処理、配信。
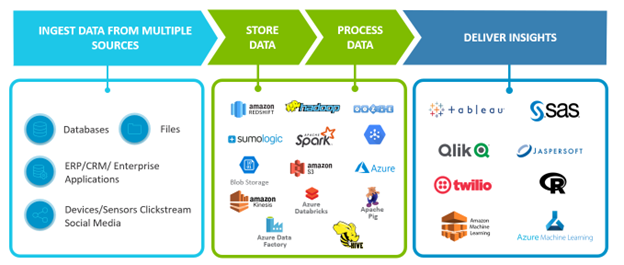
取り込みは、企業システム、デバイス、およびデジタルチャネルからデータを引き出します。ストレージは、コスト、スケール、およびアクセスの最適化された多様なプラットフォームにまたがります。処理は、バッチ、リアルタイム、およびイベント駆動のワークロードを含み、現在は特徴エンジニアリング、モデルのトレーニング、および推論にまで拡張されています。配信は、ダッシュボードだけでなく、アプリケーション、API、および自動化された意思決定を駆動するAIモデルとエージェントにデータを供給します。
パイプラインが相互接続されるにつれて、データ品質はもはや単一のステージに孤立したものではありません。上流で導入された問題は、静かに下流に伝播する可能性があり、分析、モデル性能、ビジネス決定に影響を与えます。パイプラインは動作し、SLAが満たされるかもしれませんが、それでも成果は誤っている可能性があります。AI駆動のシステムでは、これが規模での不正確な自動化された意思決定につながります。
これが、オーケストレーションがスケジューリングレイヤーから制御レイヤーに進化する必要がある理由です—ワークフローが実行されるだけでなく、実行すべきかどうかをデータの準備と品質に基づいて判断します。
Control-Mを使用してAI時代のデータOpsを運用化する
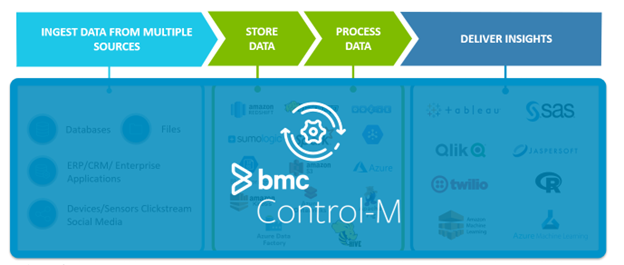
データOpsはデータパイプラインを管理するための基盤を提供します。しかし、AI駆動の環境での成功は、データ、AI、およびアプリケーションワークフローを統一システムとして運用化する能力に依存しています—信頼性とスケールで。上記で特定されたギャップ—データの準備、実行ゲーティング、イベント駆動の調整、クロスプラットフォームの可視性—は、個々のパイプラインの上で機能する制御レイヤーを必要とします。Control-MとControl-M SaaSは、そのレイヤーを提供します。
現代の環境の複雑さを抽象化することにより、Control-Mはデータプラットフォーム、AIシステム、およびビジネスアプリケーション全体のワークフローをオーケストレーションし、エンドツーエンドの可視性、予測可能なSLA、ハイブリッドおよびマルチクラウド環境全体での調整された実行を提供します。
現代のデータおよびAIエコシステムにわたるオーケストレーション
現代のワークフローは急速に拡大する技術のエコシステムにまたがります。Control-Mは、Snowflake、Databricks、BigQueryなどのデータプラットフォームに対する深い標準統合を提供し、SageMaker、Bedrock、Vertex AIなどのAIプラットフォーム、Kafka、SQS、RabbitMQなどのストリーミングシステム、ERP、CRM、現代のSaaSプラットフォーム全体の企業アプリケーションとの統合を提供します。この幅広さにより、組織はカスタムスクリプトや断片的なツールに依存せずに、データとAIスタック全体にわたるエンドツーエンドのワークフローをオーケストレーションできます。
イベント駆動およびリアルタイムワークフローの有効化
AI駆動のシステムはますますリアルタイムで動作しています—スケジュールではなくイベントによってトリガーされます。Control-Mはイベント駆動のオーケストレーションをサポートし、データの変更、アプリケーションのイベント、およびビジネストリガーに基づいてワークフローを開始できます。これにより、推論パイプライン、エージェント駆動の意思決定、およびタイムセンシティブなプロセスのためのより迅速な実行が可能になります。
Control-Mデータ保証によるデータの準備の組み込み
AI駆動の環境では、検証なしの実行はリスクを伴います。Control-Mデータ保証は、ワークフローに直接継続的データ検証を埋め込み、実行の前後にデータが検証されることを保証します。ワークフローはデータの準備に基づいてゲートされ、不良データが下流のプロセスをトリガーするのを防ぎ、AIモデルやエージェントが信頼できる入力でのみ動作することを保証します。これにより、データOpsはパイプラインの実行から信頼できる実行へと移行します。
SLA駆動の成果意識のあるオーケストレーション
Control-Mはワークフローの実行をビジネス成果に結びつけます—SLAを追跡し、遅延を予測し、影響を浮き彫りにします—そのため、ワークフローはビジネスクリティカルなタイムラインに合わせて調整されます。
スケールでの自動化、修正、および可視性
Control-Mは、エラー検出、通知、修正、クロスプラットフォーム調整を自動化し、オペレーションチーム、開発者、ビジネスユーザーのためにワークフロー全体のエンドツーエンドの可視性を提供します。
データへの需要は引き続き増加していますが—そのデータが効果的に運用化されるときにのみ価値が実現されます。データOpsの実践をControl-Mのような制御レイヤーと組み合わせることで、組織はデータ、AI、アプリケーションのワークフローをエンドツーエンドでオーケストレーションし、進化するエコシステム全体に統合し、イベントにリアルタイムで応答し、実行前にデータの準備を確保し、信頼性のある、SLA駆動の成果をスケールで提供できます。
AI時代の成功は、パイプラインがどれだけ早く実行されるかではなく、どれだけ信頼性高く信頼できる、行動可能な成果を生み出すかによって定義されます。
データOpsとAIオーケストレーションに関するよくある質問
データOpsと従来のデータ管理の違いは何ですか?
従来のデータ管理は、データの保存とアクセスに焦点を当てています。データOpsは、データパイプラインのライフサイクル全体にアジャイルエンジニアリングとDevOpsの原則を適用し、配信を自動化し、チーム間のコラボレーションを改善し、データワークフローのより迅速で信頼性の高い生産展開を可能にします。
生成AIパイロットが生産に到達することがよく失敗するのはなぜですか?
ほとんどの生成AIパイロットは、生産に到達することができませんが、根本的な技術に欠陥があるからではなく、AIをスケールするには、継続的に検証され、信頼性を持って提供され、コンプライアンスのためにガバナンスされているデータが必要だからです—これらの条件は、パイロット環境ではほとんどテストされません。生産グレードのデータOpsの実践が整っていないと、AIシステムは、規模での失敗や不正確な成果を引き起こすデータ品質の問題に直面します。
AI-readyデータとは何ですか?
AI-readyデータは、Gartnerレポートで見る3つの基準を満たします:整合性(特定のユースケースに関連性があること)、資格(生産環境向けの継続的な検証)、ガバナンス(ポリシー、コンプライアンス、トレーサビリティ)。迅速に移動するがこれらの基準を満たさないデータは、AIシステムが消費したときに不正確な結果を生む可能性があります。
データOpsにおけるオーケストレーションの役割は何ですか?
オーケストレーションは、データワークフローが実行されるタイミング、方法、および実行されるべきかどうかを管理する調整レイヤーです。現代のデータOpsでは、オーケストレーションはスケジューリングを超え、データの準備ゲーティング、イベント駆動のトリガー、SLA追跡、自動修正を含むように拡大しました—パイプラインが単に動作するだけでなく、信頼できる成果を生み出すことを保証します。
Control-MはAIのためのデータOpsをどのようにサポートしますか?
Control-Mは、データ、AI、およびアプリケーションワークフローのための制御レイヤーとして機能し、Snowflake、Databricks、SageMaker、Kafkaなどのプラットフォーム全体で実行をオーケストレーションします。Control-Mデータ保証は、ワークフローに直接データ検証を埋め込み、準備に基づいて実行をゲートし、AIモデルやエージェントが信頼できる入力でのみ動作することを保証します。
パイプラインオーケストレーションと制御レイヤーの違いは何ですか?
パイプラインオーケストレーションは、ワークフロー内のタスク実行を調整します。制御レイヤーは、より高いレベルで機能します—データ品質と準備に基づいてワークフローが実行されるべきかどうかを判断し、複数のシステムやパイプラインタイプ全体を調整し、SLA追跡と予測監視を通じて実行をビジネス成果に結びつけます。
必要な帰属と免責事項を追加してください —
Gartner, DataOpsツールの市場ガイド, Michael Simone, Sharat Menon, Robert Thanaraj, 2025年10月24日。
GARTNERは、Gartner, Inc.およびその関連会社の商標です。
Gartnerは、その研究出版物に描かれたベンダー、製品、またはサービスをいかなる形でも支持せず、技術ユーザーに最高の評価やその他の指定を持つベンダーのみを選択するよう助言しません。Gartnerの研究出版物は、Gartnerの研究組織の意見で構成されており、事実の声明と解釈されるべきではありません。Gartnerは、この研究に関して明示的または暗黙的なすべての保証を否認し、商品性や特定の目的への適合性に関する保証も含まれます。
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。