




ポイント: Apache Cassandraのストレステストとパフォーマンスチューニングは、データを生成し、クエリを実行してパフォーマンスメトリックを分析することを含みます。主なステップには、キー・スペースの作成、YAMLでのストレステストの構成、およびパフォーマンスを評価するためのコマンドの実行が含まれます。
- Cassandraのキー・スペースとテーブルを作成するための指示が提供されています。
- ストレステストのためのYAML構成ファイルが概説されています。
ここでは、cassandra-stressツールを使用してCassandraクラスタをストレステストする方法を示します。
このツールは、自己生成したテーブルまたは既存のテーブルに対して挿入とクエリを実行します。
基本フロー
テストは次のように機能します:
- ランダムデータを挿入します。テキストフィールドの長さやランダムな数値を固定値または正規、均一、または他の分布などの統計分布を選択して指定します。正規分布は、平均と標準偏差から引き出された値、すなわちお馴染みのベルカーブを意味します。均一分布は、1、2、3などの範囲から引き出されたランダムな数字です。
- 生成された値を使用してselect文を実行します。
- 各操作を実行するのにかかる時間をミリ秒単位で計算します。
- 各反復の平均時間、標準偏差、ガーベジコレクションの数などを計算します。これにより、平均とベルカーブが得られ、操作の分散具合を視覚化できます。操作が平均から大きく外れると、高い分散レベルを示す可能性があります。これは、インデックス、パーティションの調整、メモリの追加などのチューニングが必要な項目を指摘する可能性があります。
テストセットアップ
Cassandraクラスタが必要です。まだ持っていない場合は、これらの手順に従ってください。
キー・スペース、テーブル、インデックスを作成し、YAML形式のストレステスト構成ファイルを作成する必要があります。
次に、Python 2.7の仮想環境を無効にし、cqlshを実行します。次のCassandra SQLを貼り付けます。
    CREATE KEYSPACE Library
WITH REPLICATION = { 'class' : 'SimpleStrategy', 'replication_factor' : 3 };

CREATE TABLE Library.book (
ISBN text,
copy int,
title text,
PRIMARY KEY (ISBN, copy)
);

create index on library.book (title);
次に、stress-books.yamlという名前のテキストファイルを作成し、以下を貼り付けます。これはYAML形式ですので、インデントを乱さないでください。
以下にフィールドを説明します。
    keyspace: library

table: book

columnspec:
  - name: text
    size: uniform(5..10)
    population: uniform(1..10)
  - name: copy
    cluster: uniform(20..500)
  - name: title
    size: uniform(5..10)

insert:
  partitions: fixed(1)
  select: fixed(1)/500
  batchtype: UNLOGGED

queries:
   books:
      cql: select *  from book where title = ?
      fields: samerow
フィールド名は次のとおりです:
| キー・スペース | 既存のキー・スペースの名前。存在しない場合は、ここにSQLを入力して作成することもできます。 |
| テーブル | 既存のテーブルの名前。存在しない場合は、ここにSQLを入力して作成することもできます。 |
| insert, queries | これらは私たちが呼び出す関数です。insertは挿入を行い、queries/booksはそこに入れたクエリを実行します。それは、実行したバッチに挿入された値に対してクエリを実行します。 |
| columnspec: - name: text size: uniform(5..10) | 私たちが埋めたいそれぞれの値に対して1つのcolumnspecがあります。sizeはフィールドの長さです。uniform(5..10)は、5から10文字のテキスト文字列を生成することを意味します。数値フィールドの場合は、その範囲内のランダムな数字を生成します。 |
| insert: partitions: fixed(1) select: fixed(1)/500 batchtype: UNLOGGED | これは、各バッチの各パーティションに固定数の行を挿入することを意味します。バッチ操作についてはこちらで説明しています。 |
ストレステストを実行
テストを開始するには、以下のコマンドを実行します。引数は次のとおりです:
cassandra-stress user profile=stress-books.yaml ops\(insert=1,books=1\) n=10000 -graph file=stress.html
| user profile=stress-books.yaml | stress-books.yamlを指示に使用することを意味します。 |
| n=10000 ops\(insert=1,books=1\) | ここでは、10,000バッチを実行し、各実行で挿入コードを1回、書籍コードを1回実行することを示します。これを省略すると、誤差の標準偏差が<0.2になるまで実行されます。 |
| -graph file=stress.html | stress.htmlという名前のHTMLファイルを作成し、異なるメトリックの結果をグラフ化します。 |
出力は非常に長いです。ここに切り取られた部分があります。
    ******************** Stress Settings ********************
Command:
Type: user
Count: 10,000


…

Connected to cluster: Walker Cluster, max pending requests per connection 128, max connections per host 8
Datatacenter: datacenter1; Host: localhost/127.0.0.1; Rack: rack1
Generating batches with [1..1] partitions and [0..1] rows (of [20..500] total rows in the partitions)

Sleeping 2s...
Warming up insert with 500 iterations...
Warming up books with 500 iterations...
Thread count was not specified
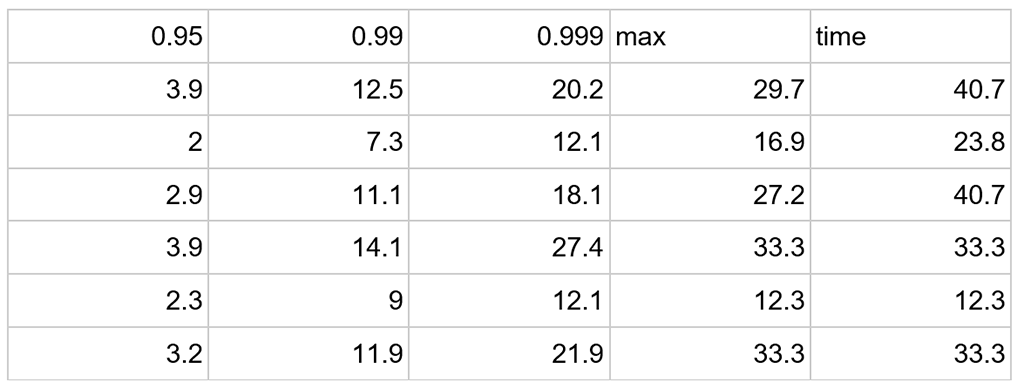
各バッチの反復ごとのメトリックをエコーします。このテストをコピーして貼り付け、ExcelまたはGoogle Sheetsにインポートすると、読みやすくなります。
    type       total ops,    op/s,    pk/s,   row/s,    mean,     med,     .95,     .99,    .999,     max,   time,   stderr, errors,  gc: #,  max ms,  sum ms,  sdv ms,      mb
books,          1003,    1003,     383,     387,     5.0,     3.9,    12.5,    20.2,    29.7,    40.7,    1.0,  0.00000,      0,      2,      10,      18,       1,     319
insert,          825,     825,     825,     934,     2.7,     2.0,     7.3,    12.1,    16.9,    23.8,    1.0,  0.00000,      0,      2,      10,      18,       1,     319
total,          1828,    1828,    1208,    1321,     4.0,     2.9,    11.1,    18.1,    27.2,    40.7,    1.0,  0.00000,      0,      2,      10,      18,       1,     319
books,          1096,     930,     350,     360,     5.8,     3.9,    14.1,    27.4,    33.3,    33.3,    1.1,  0.11339,      0,      0,       0,       0,       0,       0
insert,          904,     790,     790,     910,     3.0,     2.3,     9.0,    12.1,    12.3,    12.3,    1.1,  0.11339,      0,      0,       0,       0,       0,       0
total,          2000,    1720,    1140,    1270,     4.5,     3.2,    11.9,    21.9,    33.3,    33.3,    1.1,  0.11339,      0,      0,       0,       0,       0,       0
そうすれば、スプレッドシートが読みやすくなります。
これは、挿入と選択の合計数を示しています(「書籍」と名付けたもの)と、それを行うのに必要なミリ秒の平均(平均)を示しています。この例では、以前に2000回実行されました。
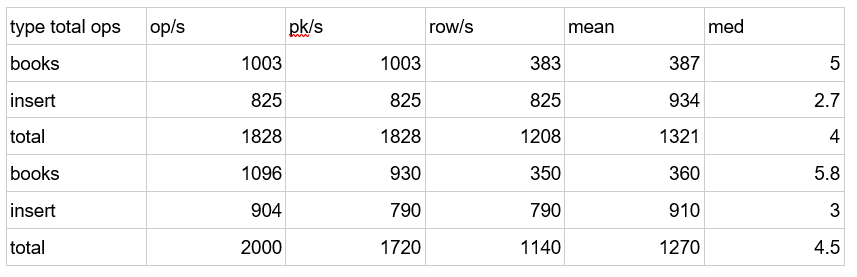
このデータを見る統計学者は、平均からの2、3、および4標準偏差を知りたいでしょう。それは取引の95%、99%、99.9%に対応します。言い換えれば、それは平均から遠く離れています。
以下は、スプレッドシートの右側です。すべてのメトリックがこの画面に収まるわけではなく、ガーベジコレクションの数(Java仮想マシンがキャッシュをクリアしなければならなかった回数。そうするとすべての操作が一時停止します)が含まれます。しかし、HTMLファイルが全体像を示すので、これは重要ではありません。
ブラウザでstress.htmlファイルを開いてください。
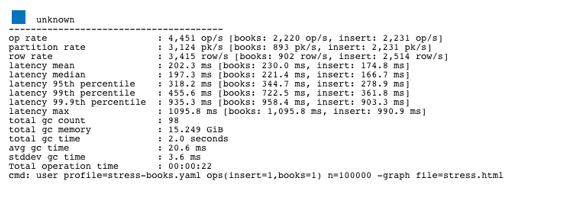
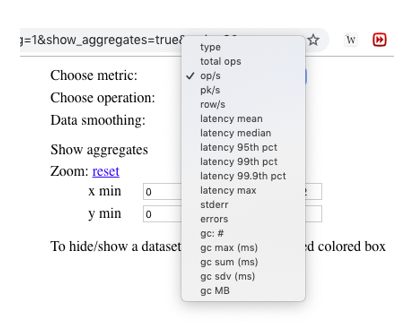
このテストが、私の2つのクラスタt2.largeのAmazon Ubuntuマシンで22秒かかったことがわかります。操作時間のスパイクは、ガーベジコレクションと一致します。グラフタイプのドロップダウンでgc#オプションを選択すると、それを確認できます。
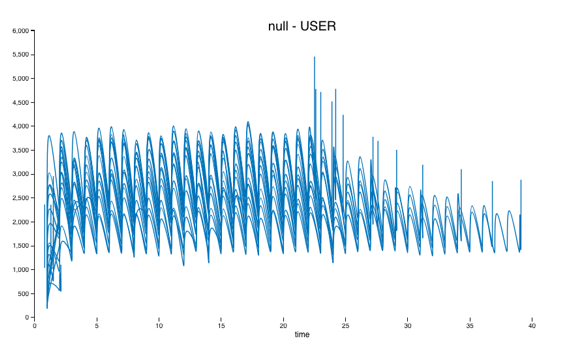
統計は、平均スループットが2,231挿入/秒であったことを示しています。
チャートの右上のドロップダウンから異なるメトリックをプロットすることができます。
Cassandraガイド
これらの投稿は私自身のものであり、BMCの立場、戦略、または意見を必ずしも表すものではありません。