




ポイント: Snowflake ストリームの作成と使用により、データ管理のためのテーブル変更の効率的な追跡が可能になります。このガイドでは、ストリームのセットアップ、テーブルの作成、在庫の更新の自動化を扱います。
- ストリームはトリガーのように機能し、処理のためにデータ変更をキャプチャします。
- 使用法を示すために在庫補充シナリオを含みます。
このチュートリアルでは、Snowflake でストリームを作成および使用する方法を示します。
Snowflake ストリームの説明
Snowflake ストリーム(テーブルストリームの略)は、テーブルへの変更を追跡します。Snowflake ストリームを使用して:
- トリガーをエミュレートする(トリガーとは異なり、ストリームは即座に発火しません)
- 変更をステージングテーブルに集め、一定の頻度でそれに基づいて他のテーブルを更新します
ここでは、サンプルシナリオを作成します: 在庫補充システム。補充注文を受け取ったときは、手持ちの在庫を増やす必要があります。
このタスクは手動で実行します。実際の使用では、何らかの固定スケジュールで Snowflake タスクとして実行したいでしょう。
データ、ストリーム、およびテーブルを作成
進めるために、注文と製品のテーブルを作成します:
チュートリアルユースケース
- 注文は在庫の移動です。
- 製品は手持ちの在庫数量を保持します。
25 アイテムから始めて、25、25、25 の 3 回の補充注文を行うと、最後には 100 アイテムが手元にあります。これら 3 回の注文を合計し、25 の初期残高に 75 を加えると 100 になります。
これらの 2 つのテーブルを作成します:
    CREATE TABLE orders
  (
     customernumber     varchar(100) PRIMARY KEY,
    ordernumber varchar(100),
    comments varchar(200),
    orderdate date,
    ordertype varchar(10),
    shipdate date,
discount number,
quantity int,
    productnumber varchar(50)
)
    create table products (
      productnumber varchar(50) primary key,
      movementdate datetime,
      quantity number,
      movementtype varchar(10));
今、製品テーブルに製品を追加し、初期の手持ち在庫を 100 ユニットに設定します。
insert into products(productnumber, quantity) values ('EE333', 100);
今、注文テーブルにストリームを作成します。Snowflake はそのテーブルへの変更を追跡し始めます。
CREATE OR REPLACE STREAM orders_STREAM on table orders;
今、注文を作成します。
insert into orders (customernumber,ordernumber,comments,orderdate,ordertype,shipdate,discount,quantity,productnumber) values ('855','533','jqplygemaq','2020-10-08','sale','2020-10-18','0.10503143596496034','65','EE333')
次に、orders_stream テーブルをクエリします:
select * from orders_stream
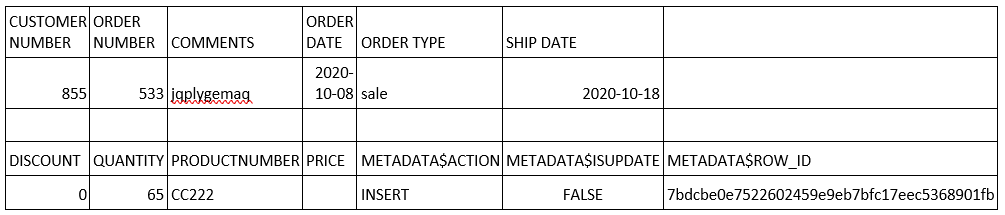
結果は次のとおりです。1 件のレコードを追加したことがわかります。
手持ち在庫の更新
在庫に 65 アイテムが追加されたので、在庫残高を更新する必要があります。手順は次のとおりです。
begin ステートメントを使用してトランザクションを開始します。
begin;
次に、この更新ステートメントを実行します。基本的には:
- 各製品の注文を合計します。
- 注文数量の合計を元の在庫残高に加えます。
この更新ステートメントは、orders_stream テーブルから製品番号を取得します。それが Snowflake にどの製品の在庫を更新する必要があるかを示すテーブルです。
    update products
     set quantity = onhand
     from
      (select distinct p.productnumber,
            p.quantity as dquantity,
            o.quantity ,
            p.quantity + o.quantity as onhand
       from products p
       inner join orders o on
              p.productnumber = o.productnumber)  as z
        where z.productnumber = (select productnumber from orders_stream)
commit:
この時点で orders_stream テーブルは空になります。これは、それを読み取る操作を実行したときに発生します。
(注: Begin と commit はトランザクションを作成します。これは論理的に関連する一連の SQL ステートメントです。これらは関与するテーブルをロックします。それがないと、一方のトランザクションが機能し、もう一方が機能しないため、不整合な状況が発生する可能性があります。)
今、orders_stream をクエリすると、そのテーブルは空であることがわかります。
追加リソース
このようなチュートリアルをさらに探すには、これらのリソースを参照してください:
Snowflake ガイド
- Snowflake 101: Snowflake データクラウドの紹介
- Amazon S3 データを Snowflake にインポートする方法
- Snowflake で JSON データをクエリする方法
- S3 から Snowflake に CSV ファイルを読み込む
- Snowflake: 分析および統計関数の使用
- Snowflake ウィンドウ関数: Partition By および Order By
- Snowflake ラグ関数と移動平均
- Snowflake SQL 集約関数とテーブル結合
- Snowflake のユーザー定義関数 (UDF)
- Snowflake ストリームの作成と使用
- Snowflake のストアドプロシージャを使用する
- Snowflake vs Redshift: 違いと選び方
これらの投稿は私のものであり、必ずしも BMC の立場、戦略、または意見を表すものではありません。