




ポイント: SnowflakeでのJSONデータのクエリは、構造化データの効果的な管理と分析を促進します。このチュートリアルでは、JSON列を持つテーブルの作成、さまざまなJSONタイプの挿入、さまざまな方法を使用したデータのクエリをカバーします。
- JSON列を持つテーブルを作成し、データを挿入する手順。
- ネストされた属性へのアクセスやフラット関数の使用を含むJSONデータのクエリ方法。
すでにSnowflakeテーブルにバリアント列を作成する方法を見せました。ここでvariantはJSONを意味します。このチュートリアルでは、それらのJSON列をクエリする方法を示します。
JSON列を持つテーブルを作成する
まずデータベースを作成するか、前回の投稿で作成したinventoryを使用し、次にvariant型の列を持つテーブルを作成します。
    use database inventory;
create table jsonRecord(jsonRecord variant);
SnowflakeにJSONデータを追加する
次に、いくつかのデータを追加します。シンプルなJSON、ネストされたJSON、およびJSON配列(つまり、角括弧[]内のJSONオブジェクト)を追加して、それぞれのタイプをクエリする方法を示します。parse_json()関数に注意してください。
    INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON('{"customer": "Walker"}');
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON('{"customer": "Stephen"}');
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON('{"customer": "Aphrodite", "age": 32}');
これらのレコードにはJSON配列ordersが含まれています。
    i
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON(' {
            "customer": "Aphrodite",
            "age": 32,
            "orders": [{
                                    "product": "socks",
                                    "quantity": 4
                        },
                        {
                                    "product": "shoes",
                                    "quantity": 3
                        }
            ]
 }');
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON(' {
            "customer": "Nina",
            "age": 52,
            "orders": [{
                                    "product": "socks",
                                    "quantity": 3
                        },
                        {
                                    "product": "shirt",
                                    "quantity": 2
                        }
            ]
 }');
このレコードにはネストされたJSONが含まれており、属性addressの値が別のJSONオブジェクトです。
    INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON(' {
            "customer": "Maria",
            "age": 22,
     "address" : { "city": "Paphos", "country": "Cyprus"},
            "orders": [{
                                    "product": "socks",
                                    "quantity": 3
                        },
                        {
                                    "product": "shirt",
                                    "quantity": 2
                        }
            ]
 }');
今、キーselect * from JSONRECORDを押して、すべてのレコードを表示します。これらは大文字と小文字が区別されることに注意してください:
- 関数
- 列
- テーブル名
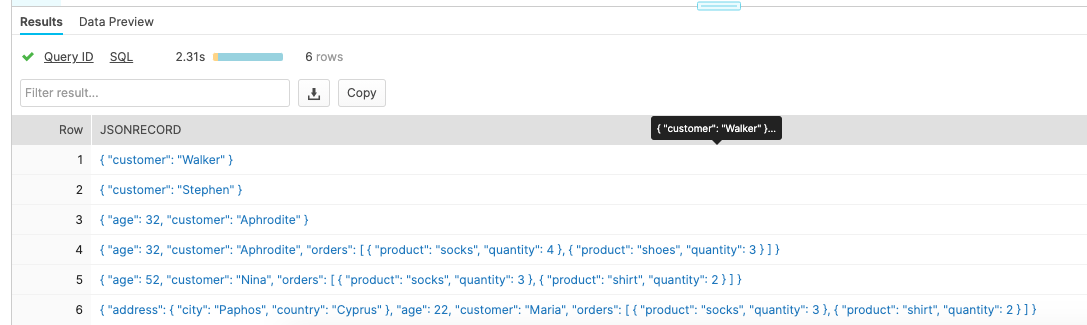
SnowflakeでJSONデータを選択する方法
データを選択するためのフォーマットには、以下すべてが含まれます:
- テーブル名:属性
- テーブル名.属性.JsonKey
- テーブル名.属性.JsonKey[arrayIndex]
- テーブル名.属性['JsonKey']
- get_path(tableName, attribute)
ここでは、JSONレコードから顧客キーを選択します。JSONでは、項目をキーと値のペアと呼びます。例えば:{"key": "value"}.
select jsonrecord:customer from JSONRECORD;
このように見えます:
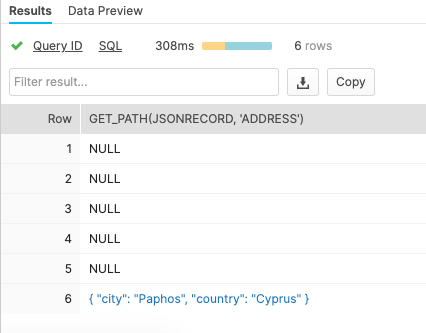
get_path()関数を使用することもできます:
select get_path(jsonrecord, 'address') from JSONRECORD;
ここでは、where句を追加し、他の選択ステートメントの側と同じコロン(:)とドット(.)表記を使用しています。
select jsonrecord:address.city from JSONRECORD where jsonrecord:customer = 'Maria';
別のアプローチを使用します。キーを角括弧[]に入れることでネストされたJSONオブジェクトを取得します。
select jsonrecord['address']['city'] from JSONRECORD where jsonrecord:customer = 'Maria';
存在しない値はNULLとして表示されます。
ここでは、配列から最初の要素を取得します。配列インデックス(0から始まります)を使用しています。
select jsonrecord['orders'][0] from JSONRECORD where jsonrecord:customer = 'Maria';
ここでは、コロン(:)を使用して同じ列を取得します。
select jsonrecord:orders[0] from JSONRECORD where jsonrecord:customer = 'Maria';
結果:
{ "product": "socks", "quantity": 3 }
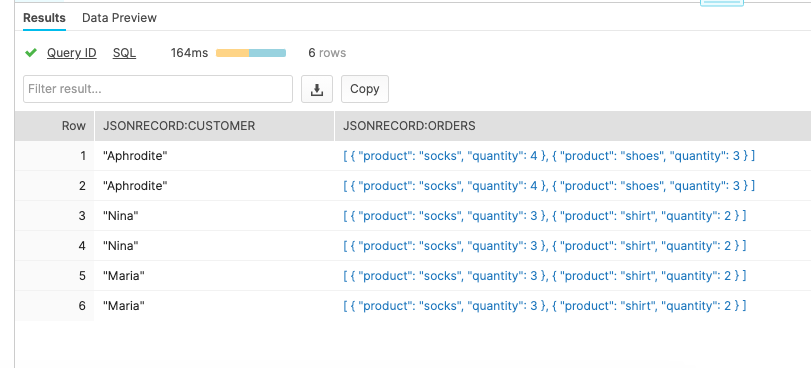
ここでは、配列をフラット化します。このレコードには2つのオーダーJSONレコードがあります。したがって、結果には2行が表示され、それぞれのレコードが他の属性に付随しています。言い換えれば、array_size行に展開され、選択ステートメント内の非配列列で他の列が埋められます。顧客が行ったすべての注文を表示する簡単な方法と考えてください。注文データと顧客データが繰り返され、見やすくなります。:
    select jsonrecord:customer, jsonrecord:orders  from JSONRECORD ,
   lateral flatten(input => jsonrecord:orders) prod ;
BMC、Control-MがSnowflakeをサポート
BMCはSnowflakeテクノロジーアライアンスパートナープログラムのメンバーです。Snowflakeのクラウドデータプラットフォームは、Snowflakeの市場をリードするクラウド専用データウェアハウスとControl-Mを使用して、データ駆動型企業の加速を支援します。
追加リソース
このようなチュートリアルをさらに探すには、これらのリソースを探ってください:
- BMC機械学習とビッグデータブログ
- AWSガイド、15の記事とチュートリアル付き
- Amazon Braket量子コンピューティング: 始め方
Snowflakeガイド
- Snowflake 101: Snowflakeデータクラウドの入門
- Amazon S3データをSnowflakeにインポートする方法
- SnowflakeでJSONデータをクエリする方法
- S3からSnowflakeへのCSVファイルの読み込み
- Snowflake: 分析および統計関数の使用
- Snowflakeウィンドウ関数: Partition ByおよびOrder By
- Snowflakeラグ関数と移動平均
- Snowflake SQL集約関数とテーブル結合
- Snowflakeのユーザー定義関数(UDF)
- Snowflakeストリームの作成と使用
- Snowflakeでのストアドプロシージャの使用
- Snowflake vs Redshift: 違いと選択方法
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。