




ポイント: 小売業者は、Azure DatabricksとControl-Mを使用して売上予測と在庫管理のための機械学習ワークフローを実装できます。このガイドは、MLモデルの統合、データ取り込み、および効率的なワークフロー管理の概要を示しています。
- 予測のためにランダムフォレストや線形回帰などのML技術が適用されます。
- Control-Mは、効果的なワークフロー管理のためにデータ処理とスケジューリングを調整します。
店舗間の販売予測(POS)は、在庫およびサプライチェーンデータと連携して、リテイラーにとって必須です。このブログでは、Control-Mを用いてPOSを予測し、在庫アイテムを予測するためにPySparkを活用したこのユースケースを説明します。このブログは2つの主要部分に分かれています。最初のセクションでは、小売予測ユースケースの詳細とAzure Databricksで定義されたMLパイプラインについて説明します。第二のセクションでは、Control-MとDatabricksの統合について説明します。
Azure Databricksでのユースケースの開発
注:このブログで使用されるすべてのコードは、githubリポで入手可能です。
実際には、データはセンサーやモバイルデバイスから取り込まれ、店舗間でのリアルタイムに近い在庫測定とPOSデータが収集されます。データおよびMLパイプラインは、Control-Mと連携して異なるコンポーネントを統合し、常に更新されるダッシュボードで結果を可視化します。
データはDatabricks Intelligent Data Platformに到着し、PySparkジョブによって組み合わされ、強化され、集約されます。生成されたデータは、販売および需要を予測するための異なる予測アルゴリズムに供給され、結果は以下に可視化されます:
- グラフィカルダッシュボード
- オフライン消費のためにデータリポジトリにデルタファイルとして書き込まれる
この記事では、この予測システムのアーキテクチャとコンポーネントについても説明します。
データセットとスキーマ
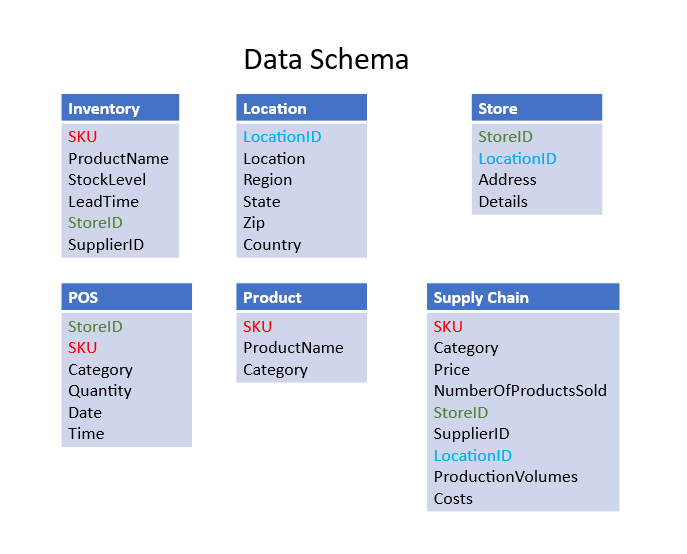
このプロジェクトでは、現実のデータを使用し、シンプルに保つためにサイズと幅を短縮しています。スキーマの簡略化されたバージョンは、図1に示されています。ロケーションテーブルは、公開データセットから取得した参照テーブルです。フィールドの色分けは、テーブル間の依存関係を示しています。データは部分的にKaggleやその他の公開ソースから取得されました。
プラットフォームとコンポーネント
ユースケースを実装するために以下のコンポーネントが使用されます:
- Azure上のDatabricks Intelligent Data Platform
- PySpark
- Python Pandasライブラリ
- データ可視化のためのPython Seabornライブラリ
- Databricks上のJupyterノートブック
- ParquetおよびDeltaファイル形式
プロジェクトの成果物
- Azure上の作業環境
- データの取り込み、処理、MLトレーニング、予測結果をDatabricks Lakehouseにデルタ形式で保存するコード
- Control-Mとのワークフローおよびオーケストレーションのためのコード、すべての活動とタスクを調整し、失敗シナリオを処理
高レベルのアーキテクチャとデータフロー
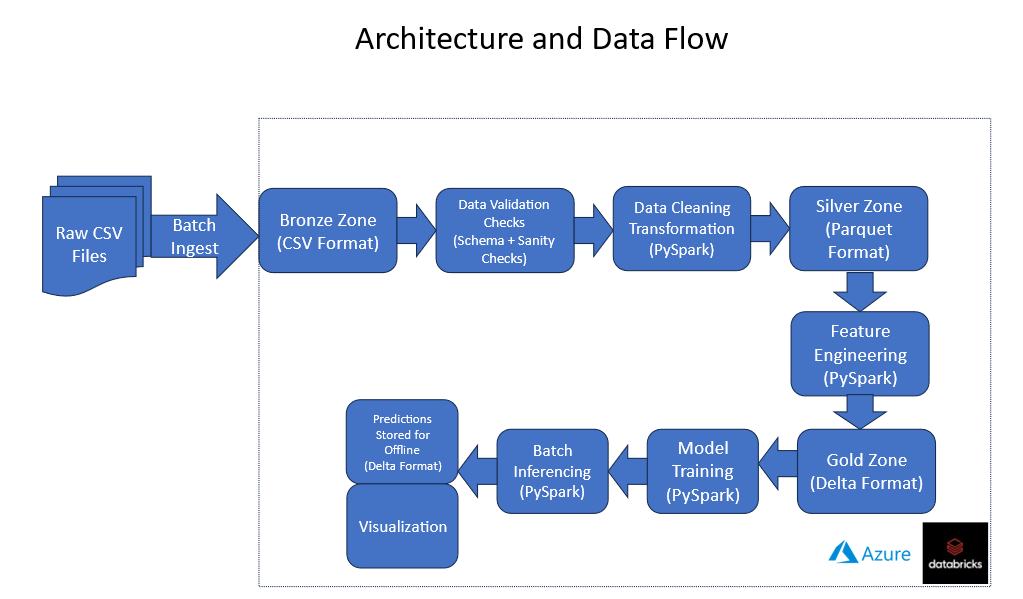
現在のアーキテクチャは、データがバッチとしてプリ定義されたスキーマを持つcsvファイルとしてデータレイクハウスの生データゾーンに到着することを想定しています。データフローと関連プロセスの高レベルの概要は、図2に示されています。
データと特徴エンジニアリング
現在、データとMLパイプラインはバッチ処理としてモデル化されています。初期の探索的データ分析(EDA)が実施され、在庫レベルとPOS売上を予測するために寄与するデータセットと関連属性を理解しました。初期EDAでは、最良の予測結果を得るために日付を「曜日」および「時間」のカテゴリに変換することが有用であることが示されました。データパイプラインには、時間を含むデータセットのための特徴エンジニアリング機能が含まれていました。
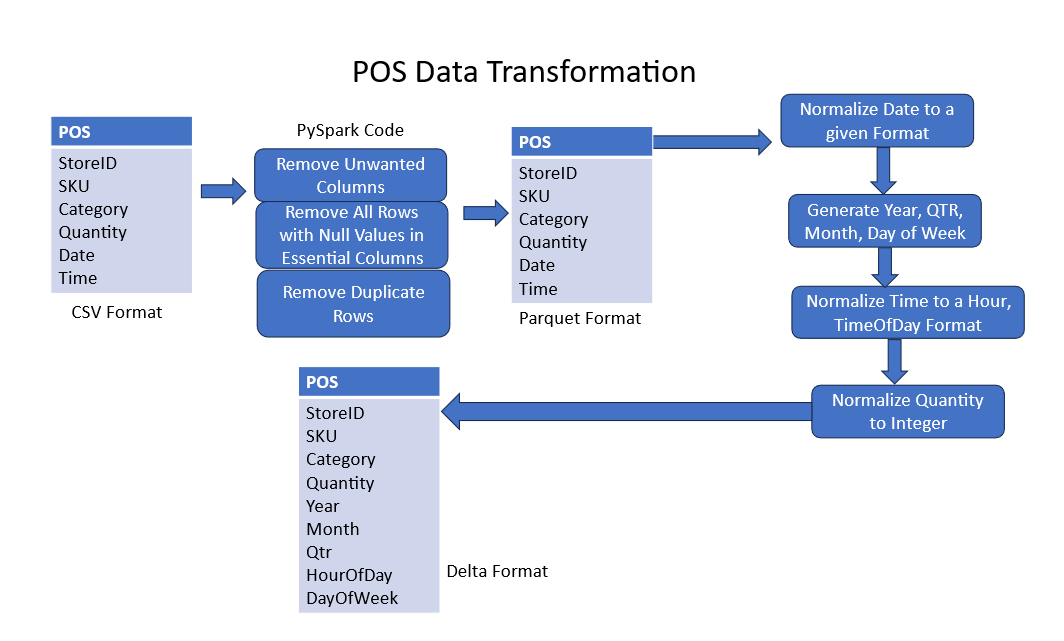
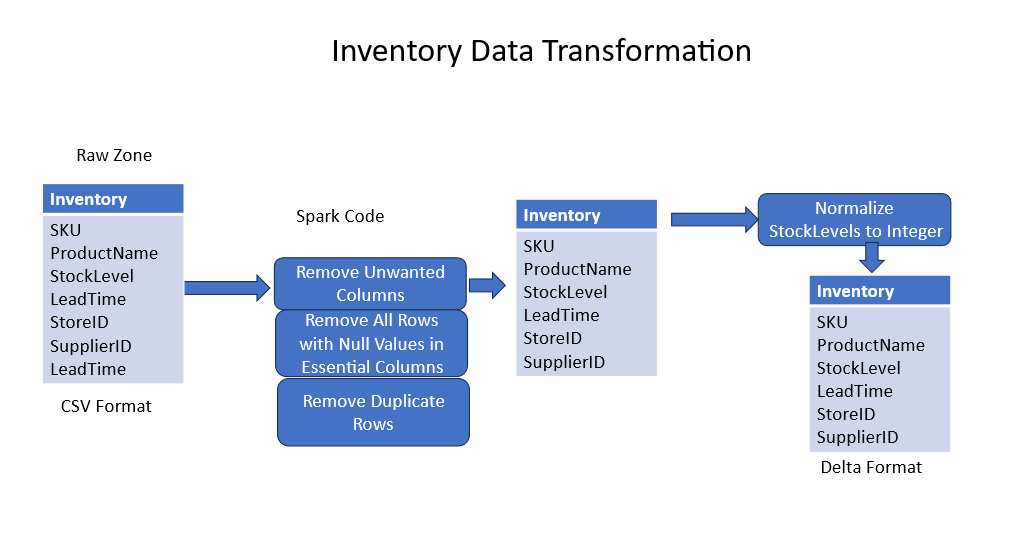
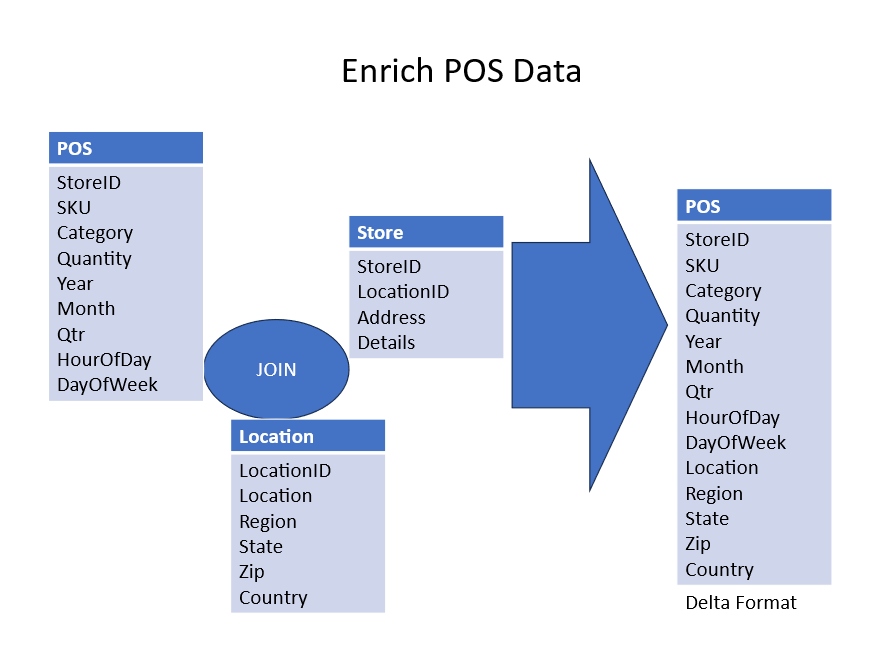
図3はPOSデータセットのサンプルデータパイプラインを示しています。図4は、在庫データセットの別の類似データパイプラインを示しています。データ変換後、変換されたテーブルが結合され、モデルのトレーニングのための非正規化テーブルが形成されました。これは、POSと在庫データを豊かにするための図5に示されています。
モデルトレーニング
MLトレーニングパイプラインは、売上と在庫レベルを予測するためにランダムフォレストと線形回帰を使用しました。以下のモジュールがPySparkから使用され、MLパイプラインを作成し、カテゴリ変数に対してワンホットエンコーディングを実行しました。
- pyspark.ml.Pipeline
- pyspark.ml.feature.StringIndexer, OneHotEncoder
- pyspark.ml.feature.VectorAssembler
- pyspark.ml.feature.StandardScaler
- pyspark.ml.regression.RandomForestRegressor
- pyspark.ml.evaluation.RegressionEvaluator
- pyspark.ml.regression.LinearRegression
豊かにされたデータはパイプラインに渡され、さまざまな回帰モデルがデータに適用されて予測が生成されました。
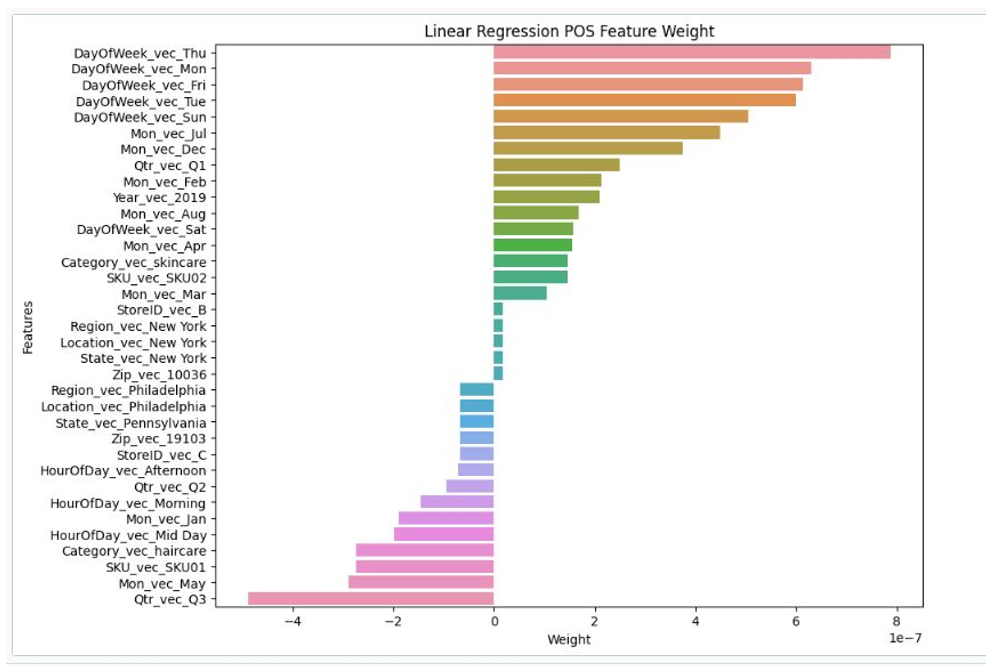
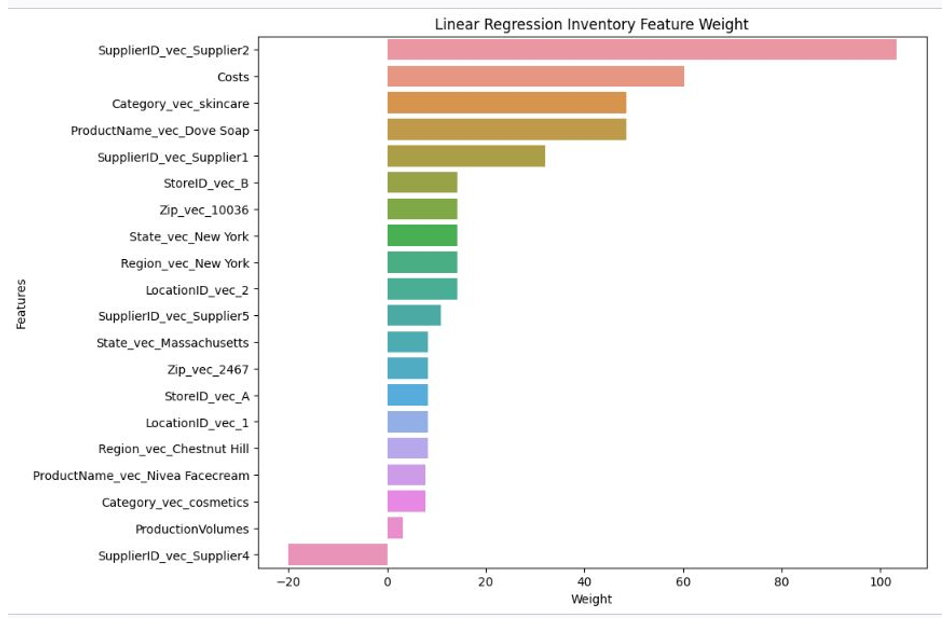
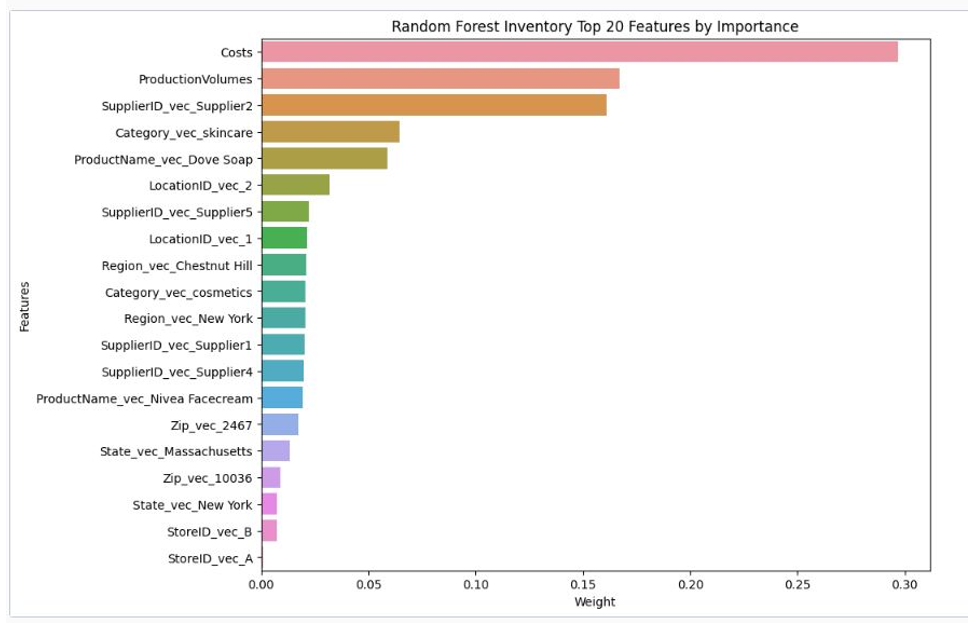
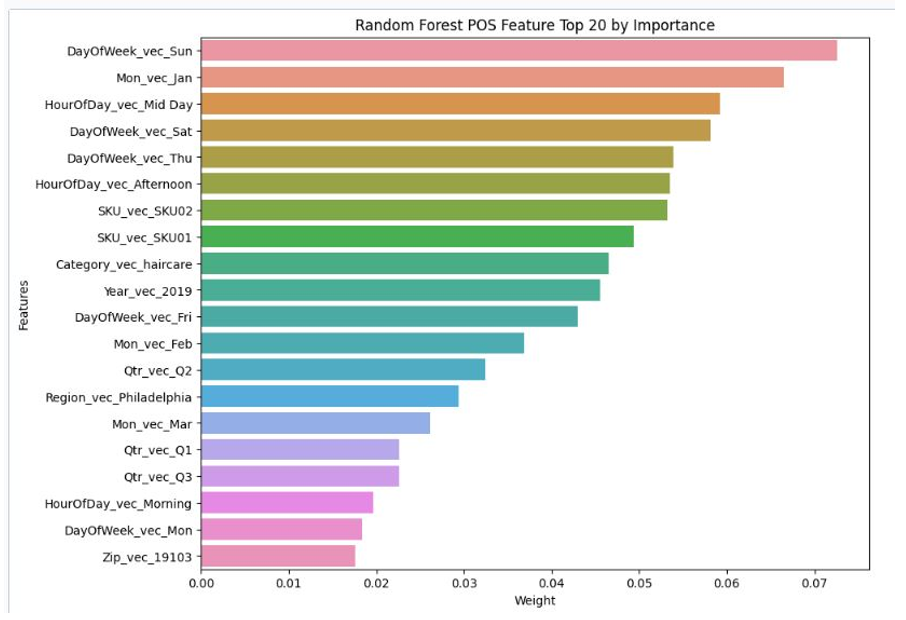
RegressionEvaluatorモジュールは結果を評価するために使用され、中央値絶対誤差(MAE)、二乗平均平方根誤差(RMSE)、およびR二乗の指標が生成されて予測結果を評価しました。特徴の重みが使用され、予測に対する各特徴の寄与の重みを理解するために使用されました。
エンドツーエンドの予測のオーケストレーション
PySparkノートブックのデータオーケストレーションは、開発のためにDatabricksワークフローを使用し、製品小売ワークフローオーケストレーションはControl-MによってそのDatabricksプラグインを通じて管理されます - 企業スケジューリング、依存関係管理、SLA可視性を提供します。このアプローチにより、DatabricksワークフローをControl-Mによって既に管理されているより大きなサプライチェーンと在庫ビジネスワークフローに組み込むことができ、関連するすべての処理の完全に自動化されたエンドツーエンドのオーケストレーションが可能になります。さらに、Azureサブスクリプション内の制約された共有リソース、たとえば公衆IPアドレスへのアクセスを必要とする複数のDatabricksワークフローの同時実行を管理する能力など、高度なスケジューリング機能にアクセスできます。
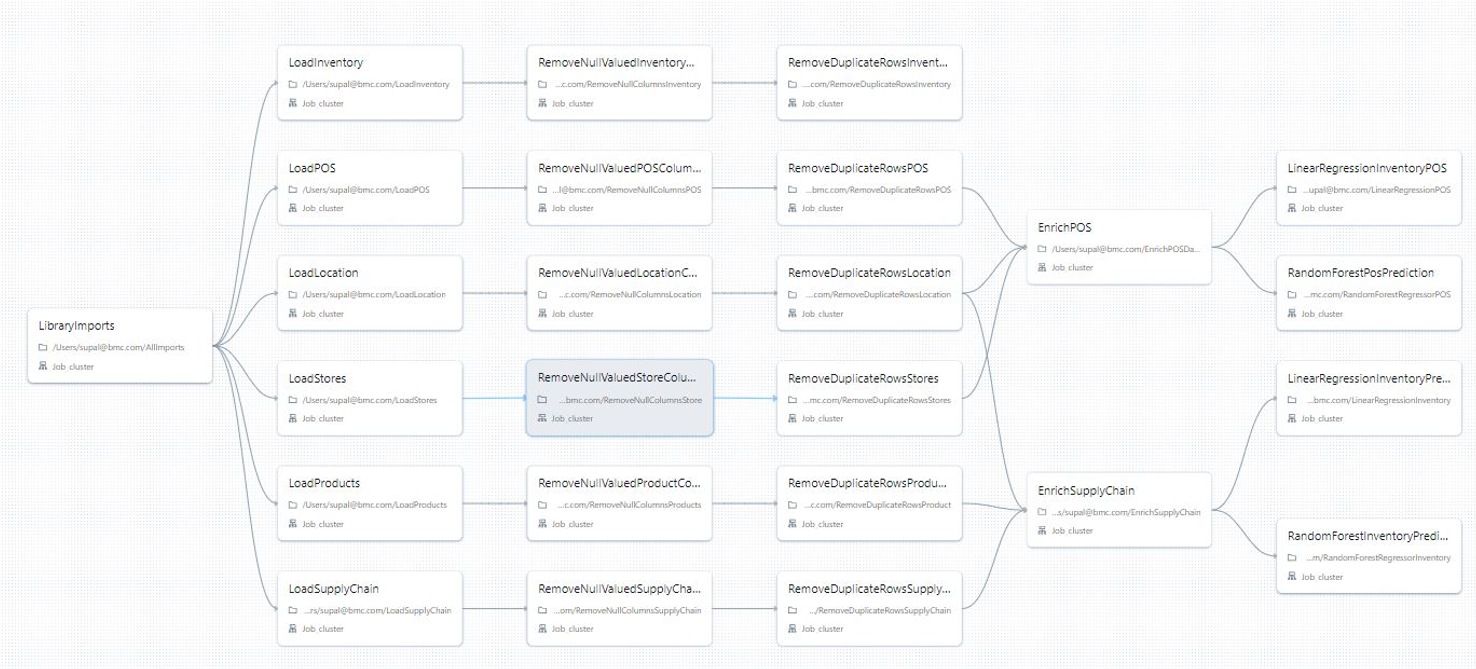
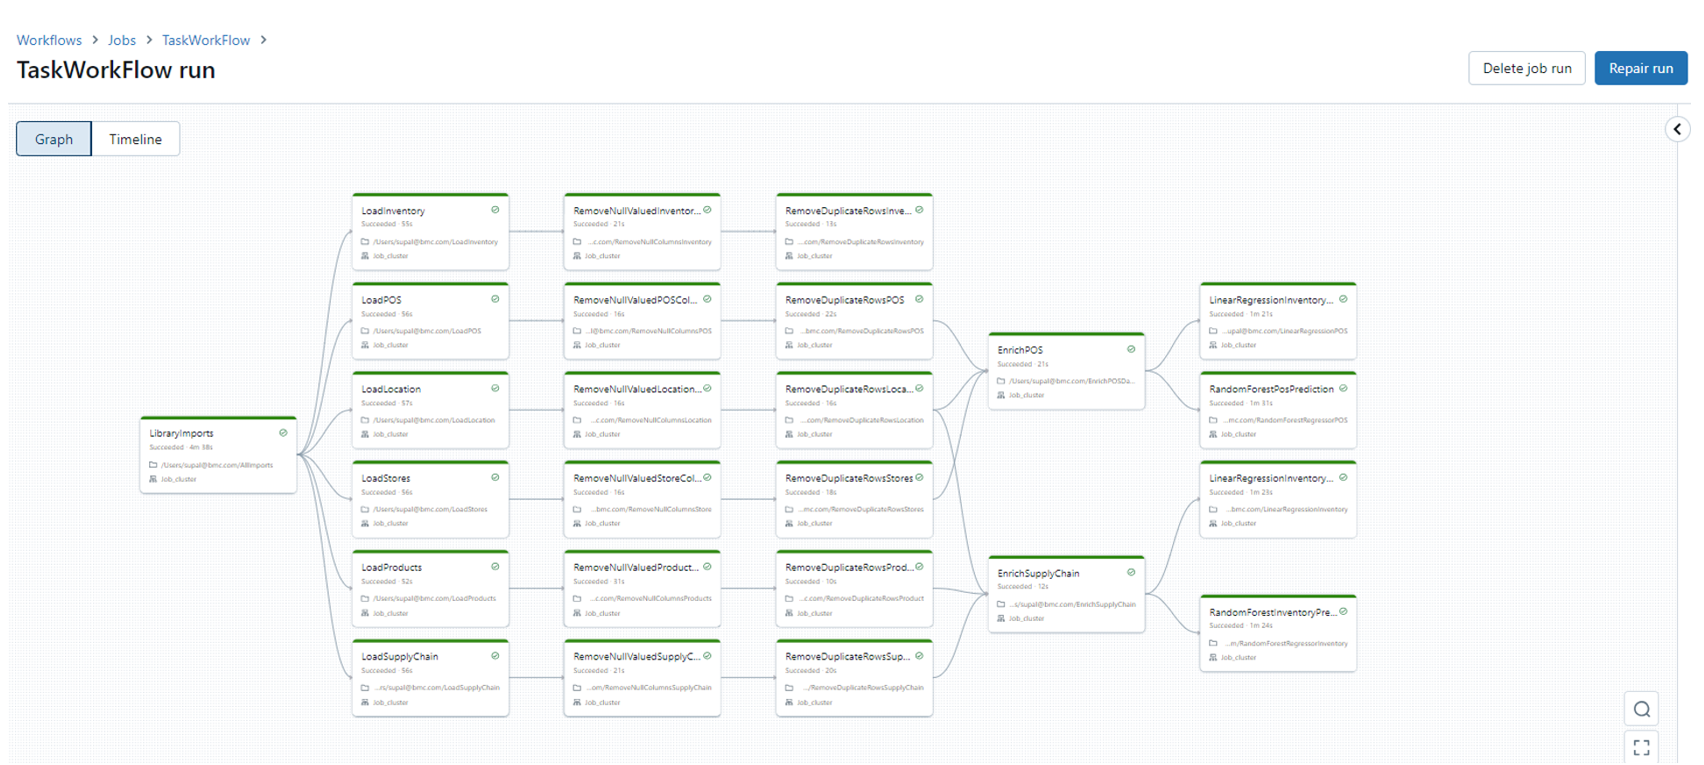
図6は、オフライン予測とダッシュボードを生成するためのさまざまなオーケストレーションタスクを示しています。オーケストレーションはシンプルに保たれ、すべてのエラーパスとエラーハンドリングパスは表示されていません。
Control-MとDatabricksの統合
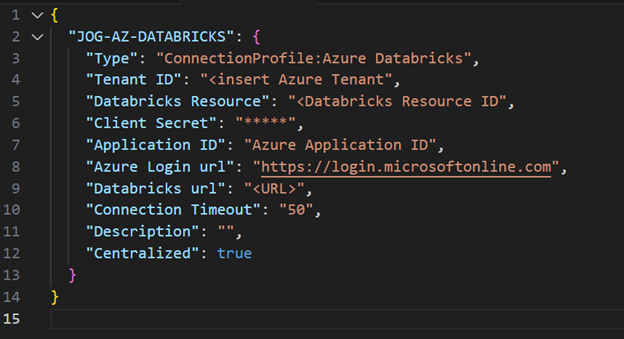
Databricksワークフローを実行できるControl-Mでジョブを作成する前に、接続プロファイルを作成する必要があります。接続プロファイルには、ユーザー名、パスワード、その他のプラグイン特有のパラメータなどの認証情報が含まれ、接続プロファイル名だけでアプリケーションサーバーに接続できるようになります。接続プロファイルはWebインターフェースを使用して作成でき、その後Control-MのAutomation APIを使用してjson形式で取得できます。以下に、json形式でのAzure Databricksの接続プロファイルのサンプルを示します。ジョブを実行する前に直接jsonで接続プロファイルを作成する場合は、Control-M Automation API CLIを使用してデプロイする必要があります。
Databricksジョブの作成
Databricksワークフローを実行するControl-M内のジョブは、以下のようにjson形式で定義されます:
    {
"jog-databricks" : {
"Type" : "Folder",
"ControlmServer" : "smprod",
"OrderMethod" : "Manual",
"SiteStandard" : "jog",
"SubApplication" : "Databricks",
"CreatedBy" : "[email protected]",
"Application" : "jog",
"DaysKeepActiveIfNotOk" : "1",
"When" : {
"RuleBasedCalendars" : {
"Included" : [ "EVERYDAY" ],
"EVERYDAY" : {
"Type" : "Calendar:RuleBased",
"When" : {
"DaysRelation" : "OR",
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ]
}
}
}
},
"jog-azure-databricks-workflow" : {
"Type" : "Job:Azure Databricks",
"ConnectionProfile" : "JOG-AZ-DATABRICKS",
"Databricks Job ID" : "674653552173981",
"Parameters" : "\"params\" : {}",
"SubApplication" : "Databricks",
"Host" : "azureagents",
"CreatedBy" : "[email protected]",
"RunAs" : "JOG-AZ-DATABRICKS",
"Application" : "jog",
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"AzEastPublicIPs" : {
"Type" : "Resource:Pool",
"Quantity" : "8"
}
}
}
}
Databricksワークフローの実行
ジョブを実行するには、Automation API内の実行サービスを使用します。

ワークフローの可視化

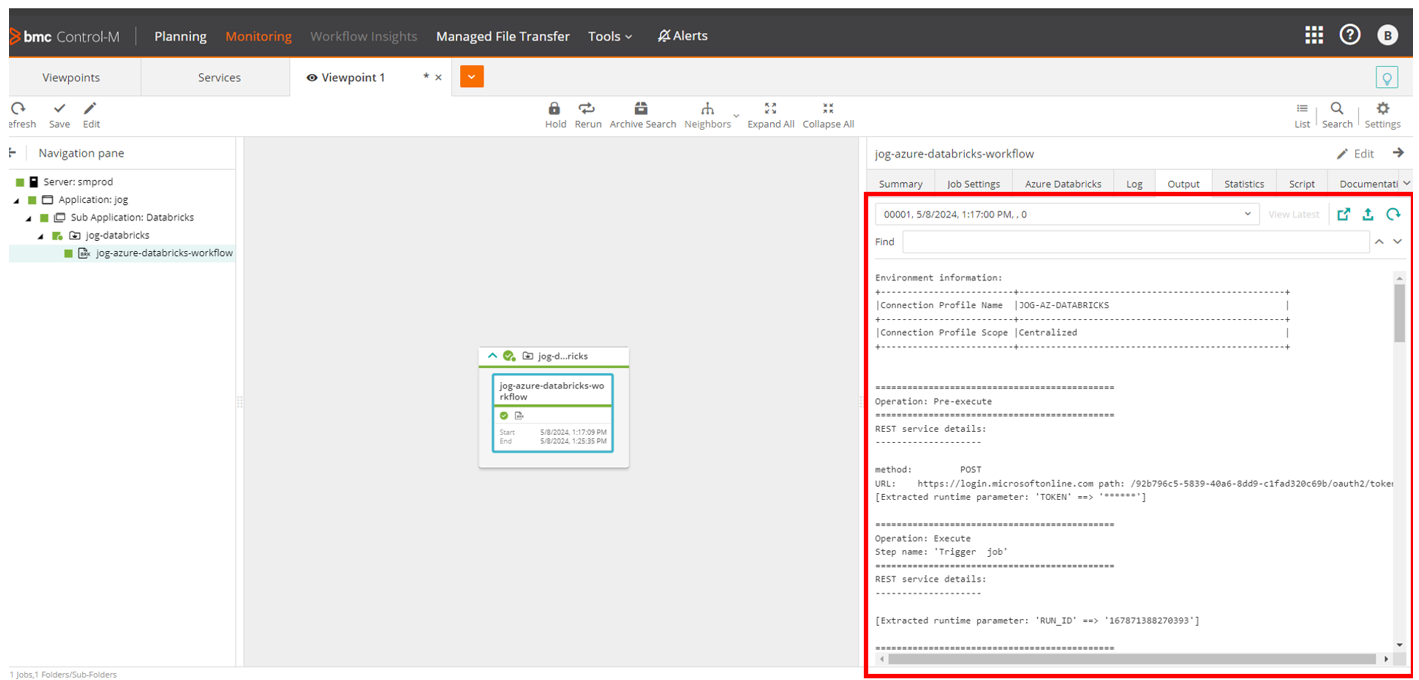
Control-Mで完了したDatabricksジョブの出力
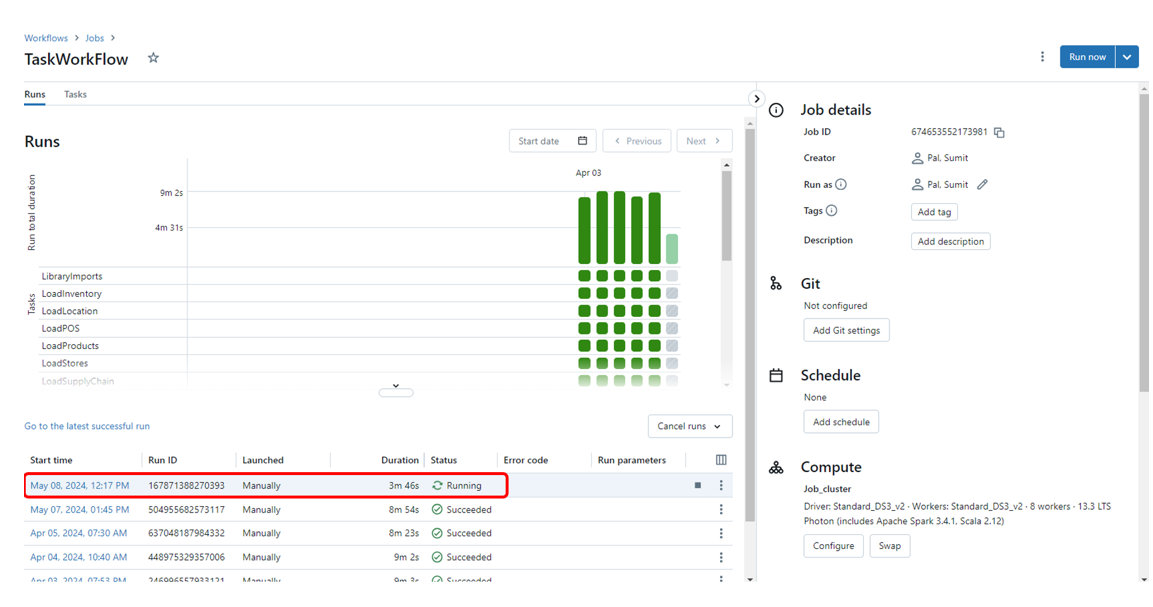
Azure Databricksのタスクワークフロー
Azure Databricksにおけるタスクワークフローのグラフビュー
出力と可視化
プロジェクト中に生成された出力は2つの形式でした。
- 需要に基づくPOS販売および在庫予測のためのモデルからの予測結果 - これらはオフラインでの表示と分析のためにレイクハウスにデルタ形式ファイルとして保存されました。
- ランダムフォレストおよび線形回帰アルゴリズムの両方のPOSおよび在庫データの予測に寄与する特徴重みの可視化。
以下の4つの図は、特徴エンジニアリングされた属性からのPOSおよび在庫予測のための各アルゴリズムの特徴重みを示しています。
結論
このブログは、売上と在庫の予測におけるMLのユースケースを示しています。MLワークフローは、POS、在庫管理、分析を1つの統制されたパイプラインに統合する製造業者向けのサプライチェーンオーケストレーションのような、より大きなControl-Mオーケストレーションワークフローの一部である可能性があります。しかし、このブログでは、DatabricksにおけるMLワークフローとControl-Mを通じたその統合と実行に焦点を当てています。
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。