




ポイント: BMCのControl-Mは、Cloud Storage、Dataflow、BigQueryなどのサービスを統合することにより、Google Cloud上でのデータパイプラインのオーケストレーションを促進します。チームが視覚的またはAPIを通じてワークフローを定義、スケジュール、監視することを可能にし、効率性とエラーハンドリングを向上させます。
- Control-Mは、スムーズなワークフロー管理のためにGoogle Cloudサービスを統合します。
- 視覚的およびAPIベースのワークフロー定義をサポートします。
BMCのControl-Mは、Cloud Storage、Dataflow、BigQueryなどのサービスを通じてワークフローを定義、スケジュール、モニタリングすることにより、Google Cloud上でデータパイプラインをオーケストレーションするチームを可能にします。このアーティクルでは、5つの主要なオーケストレーションの課題、関与するGoogle Cloudサービス、そしてControl-Mを実行に移す実際のクレジットカード詐欺検出の例について説明します。
Google Cloud Platform は、さまざまなクラウドサービスの旅の途中にある組織を受け入れるために特別に設計されています。大規模な機械学習(ML)やデータ分析から、中小企業向けのサービス、複数のクラウドプロバイダーのサービスを使用したい顧客向けのハイブリッドクラウドソリューションまで多岐にわたります。BMCがControl-Mアプリケーションをこのクラウドエコシステムに移行しているとき、私たちはこの変更をどのように管理するかについて非常に慎重でなければなりませんでした。SADAのエンジニアリングチームはBMCチームと連携し、顧客にシームレスな統合を提供することを保証しました。
SADAはこのプロジェクトをサポートし、データプラットフォーム基盤の展開を可能にするためのGoogle Cloudの設定オプション、決定、および推奨事項のインベントリを提供し、BMCとの実装計画を共同で行い、自動化テンプレートを提供し、Google Cloud Platform上の関連するマネージドサービスのためにGoogle Cloudアーキテクチャを設計しました。
この記事では、この作業の最終結果について議論し、Control-Mを使用してGoogle Cloudでデータパイプラインをシームレスにオーケストレーションする方法を示すためにクレジットカード詐欺検出プロセスを使用した例を見ていきます。
MLデータパイプラインのオーケストレーションにおける5つの課題は何ですか?
Google Cloud上で機械学習データパイプラインをオーケストレーションするには、ワークフローがスケールで信頼性を持って実行できるようにするために、チームが対処すべき5つの主要な課題があります。
ワークフローを理解する
すべての依存関係と決定ツリーを調べます。たとえば、データ取り込みが成功した場合はこのパスを進み、成功しなかった場合はあのパスを進むというように。
チームを理解する
ワークフローに複数のチームが関与している場合、それぞれが標準インターフェースを使用してワークフローを定義する方法を持ち、パイプラインを構成するために自分たちのワークフローを統合できる必要があります。
標準に従う
チームはワークフローを構築する際に再利用可能な標準と慣例を使用すべきです。これにより、同一の名前を持つ複数のジョブを避けることができます。また、各ステップには失敗した場合の目的を明確にするために意味のある説明が必要です。
必要なツールの数を最小限に抑える
パイプライン(および依存関係)との視覚化とインタラクションのために単一のツールを使用します。視覚化は定義段階で重要です。なぜなら、見えないものを管理するのは困難だからです。パイプラインが実行されるときは、さらに重要です。
組み込みのエラーハンドリング機能を含む
エラーがワークフロー内の下流のジョブやビジネスサービスレベル契約(SLA)にどのように影響するかを理解することが重要です。ジョブの失敗はパイプライン全体を停止させるべきではなく、人間の介入を必要としないようにする必要があります。失敗したジョブを自動的に再起動できるかどうか、または人間が失敗を評価するために連絡する必要があるかどうかを判断する基準を使用できます。たとえば、同じエラーに関する特定の数の失敗が発生した場合です。
BMCとSADAはどのようにこれらのオーケストレーションの課題に対処しましたか?
これらの課題に対処するには、堅固な基盤が必要であり、コラボレーションの機会を提供しました。BMCとSADAは、データプラットフォーム基盤を確立するためにSADA POWERサービスラインを使用して調整しました。この技術的な調整における注目すべき要素には、SADAによる次のような作業が含まれていました。
- 業界の専門知識を適用してBMCの開発努力を迅速化する。
- データパイプラインおよびそれをオーケストレーションするためのツールに関するベストプラクティスのベースラインを確立する。
- BMCの技術的ニーズを理解し、BMCチームが統合できる解決策を提供するための共同セッションを実施する。
SADAのデータプラットフォーム基盤は、Control-Mのようなアプリケーションに必要な複雑な分析を実現するためにGoogle Cloudサービスを活用する機会を提供しました。BMCとSADAのチームは、次のような強固な基盤を確立するために協力しました。
- Google Cloud Storageにおけるデータおよびストレージの場所を選択する。
- Pub/Subが提供する利点を活用して、分析およびデータ統合パイプラインを合理化する。
- データの抽出、変換、ロード(ETL)プロセスについて徹底的な議論を行い、データの最終状態を真に理解する。
- BigQueryを使用し、分析クエリを書く。
- 自動化、プロセスの再現性、パフォーマンスの監視の重要性を理解し、スケーラブルで柔軟なシステムを確立する。
- Data Studioを使用して必要なビジネスインサイトを提供するための視覚化ダッシュボードを作成する。
詐欺検出はGoogle Cloud上でのデータパイプラインオーケストレーションをどのように示していますか?
クレジットカード詐欺検出は、Control-MがGoogle Cloud上で複雑なMLデータパイプラインをオーケストレーションできる実用的な実例です。リアルタイムおよびバッチプロセスを複数のサービスにまたがって組み合わせています。
デジタル取引は数年間着実に増加しており、ビジネスや消費者によるデジタル決済の加速的な採用は、詐欺や運用リスクの増加をもたらしました。詐欺師が手法を改善する中で、企業はMLに依存して、堅牢で効率的な詐欺検出システムを構築しています。詐欺は常に進化するため、検出システムは新しいタイプの詐欺を特定できる必要があります。これは、初めて見られる異常を検出することによって行われます。詐欺検出は常に注意と革新を要する永続的なタスクです。
このアプリケーションを使用して顧客が防ごうとする一般的な金融詐欺の種類には、次のようなものがあります。
- 盗まれた/偽のクレジットカード詐欺: 偽のカードまたは他人のカードを使用して行われた取引。
- ATM詐欺: 他人のカードを使用しての現金引き出し。
詐欺検出は、リアルタイムおよびバッチプロセスの両方で構成されています。リアルタイムプロセスは、取引を拒否し、アカウントやクレジットカードにホールドをかけることによって詐欺を防ぐ役割を担っています。迅速に対応する必要があり、時には正確性が犠牲になることもあります。
誤検知を最小限に抑えるため、バッチフェーズを使用して検出モデルを継続的に微調整します。取引が有効または詐欺として確認された後、すべての最近のイベントが定期的にバッチプロセスに入力されます。このバッチプロセスは、リアルタイムモデルのトレーニングとスコアリングを更新し、リアルタイム検出をピーク精度で運用できるようにします。このバッチプロセスがこの記事の焦点です。
デモシステムを試すにはどうすればよいですか?
SADAとBMCは、このソリューションのデモ版を作成しましたので、Google Cloud上で実験できます。すべてのコードとサンプルデータは、 GitHubで見つけることができます。
含まれているリソースは以下の通りです。
- 取引データ、詐欺ステータス、人口統計のKaggleデータセット
- クエリ
- スキーマ
- ユーザー定義関数(UDF)
パイプラインはどのように機能しますか?
組織が運営する各地域で、取引データは毎日収集されます。収集される詳細には(必ずしもこれに限られません):
- 取引の詳細: 各取引を説明し、金額、アイテムコード、場所、支払い方法などを含みます。
- 個人情報: 購入者の名前、住所、年齢、およびその他の詳細を説明します。
この情報は、クレジットカード情報に基づく企業データと、どの取引が詐欺としてフラグされているかを特定するリアルタイムの詐欺検出から取得されます。
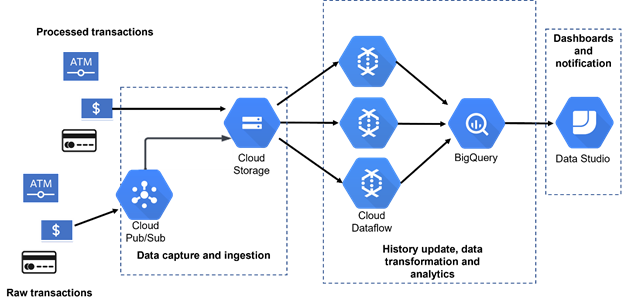
新しいデータは、バッチフィードまたはPub/SubによってCloud Storageにドロップされます。この新しいデータは、DataflowジョブによってBigQueryにロードされます。ロードプロセス中にUDFによって正規化および一部のデータの強化が行われます。
すべてのデータ準備が完了すると、分析が新しいデータと過去のデータを組み合わせて実行され、詐欺検出のパフォーマンスがテストおよびランク付けされます。結果はData Studioダッシュボードに表示されます。
依存関係
Dataflow
パイプラインを支えるGoogle Cloudサービスはどれですか?
Control-Mは、Cloud Storage、Dataflow、BigQuery、Data Studioの各Google Cloudサービスを調整して、データパイプラインの各ステージを扱います。
Cloud Storageは、すべての入力データの共通着陸ゾーンを提供し、下流処理のための一貫した入力を提供します。Dataflowは、Google Cloudの主要なデータ統合ツールです。
BMCとSADAは、データ処理のためにBigQueryを選択しました。このアプリケーションの以前のバージョンはHadoopを使用していましたが、SADAのチームと作業を進める中で、これは洗練されたデータウェアハウスやデータレイクアプリケーションに対するGoogleの推奨戦略であるため、BigQueryに移行しました。この選択は、Cloud Dataflowとの統合を簡素化しました。UDFは、ロードプロセス中にデータを操作するためのシンプルなメカニズムを提供します。
Control-Mでパイプラインワークフローを定義する2つの方法は何ですか?
Control-Mは、チームが視覚的またはプログラム的に作業する柔軟性を持たせるために、パイプラインワークフローを定義する2つのアプローチをサポートしています。
グラフィカルエディタを使用する
これにより、ワークフローステップをワークスペースにドラッグ&ドロップし、接続するオプションが提供されます。
RESTful APIを使用する
ジョブをコードとして定義し、CI/CDツールチェーンに統合するためにJSONを使用します。この方法は、ジョブを自動化されたビルディング、テスト、リリースのパイプラインを通して流すことによって、ワークフロー管理を改善します。Google Cloudは、Cloud BuildやCloud Deployなど、CI/CD用の多くの開発者ツールを提供しています。
Control-Mでジョブはどのように定義されますか?
基本的なControl-M実行単位はジョブと呼ばれます。各ジョブには、JSONで定義された多数の属性があります。
オプションには、スクリプト、コマンド、ファイル転送、Dataflow、またはBigQueryが含まれます。
実行場所
たとえば、どのホストがジョブを実行しているか?
アイデンティティ
たとえば、ジョブが「...として実行される」または接続プロファイルを使用して実行されるか?
ジョブを実行するタイミングを決定し、関連するスケジューリング基準を識別します。
これは、ジョブが特定の時間までに終了する必要があるか、出力が特定の時間または日付までに到着する必要があるかどうかなどの要素を含む可能性があります。
ジョブはフォルダに保存され、上記で説明した属性とその他の指示がそのフォルダ内のすべてのジョブに適用されます。
以下は、詐欺検出モデルランキングアプリケーションで使用されるワークフローを説明するJSONコードの例です。完全なJSONコードは、 Control-M Automation API Community Solutions GitHubリポジトリで見つけることができます。そこでは、ソリューション、Control-M Automation APIガイド、およびその他のコードサンプルも見つけることができます。
    {
"Defaults" : {
},
"jog-mc-gcp-fraud-detection": {"Type": "Folder",
"Comment" : "Update fraud history, run, train and score models",
"jog-gcs-download" : {"Type" : "Job:FileTransfer",…},
"jog-dflow-gcs-to-bq-fraud": {"Type": "Job:Google DataFlow",…},
"jog-dflow-gcs-to-bq-transactions": {"Type": “Job:Google DataFlow",…},
"jog-dflow-gcs-to-bq-personal": {"Type": "Job:Google DataFlow",…},
"jog-mc-bq-query": {"Type": "Job:Database:EmbeddedQuery", …},
"jog-mc-fm-service": {"Type": "Job:SLAManagement",…},
},
"flow00": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-fraud",
"jog-mc-bq-query",
"jog-mc-fm-service"]},
"flow01": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-transactions",
"jog-mc-bq-query", "jog-mc-fm-service"]},
"flow02": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-personal",
"jog-mc-bq-query",
"jog-mc-fm-service"]}

}
}
このワークフローに示されているジョブは、前に図1で示されたステップに直接対応しています。
ワークフローには、3つの基本的なセクションが含まれています。
デフォルト。これはワークフローに適用される関数です。これには、ジョブの失敗時に誰に連絡するか、ジョブの命名や構造に関する基準などの詳細が含まれる可能性があります。
    {  "Defaults" : {"RunAs" : "ctmagent", "OrderMethod": "Manual", "Application" :
       "multicloud", "SubApplication" : "jog-mc-fraud-modeling",
      "Job" : {"SemQR": { "Type": "Resource:Semaphore", Quantity": "1"},
      "actionIfError" : {"Type": "If", "CompletionStatus":"NOTOK", "mailTeam":
          {"Type": "Mail", "Message": "Job %%JOBNAME failed", "Subject":
                 "Error occurred", "To": [email protected]}}}
    },
ジョブ定義。ここでは、個々のジョブが指定され、リストされます。流れの各ジョブについての説明は以下にあります。
フローステートメント。これらは、ジョブの関係を定義します。上流および下流の両方です。
    "flow00": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-fraud", "jog-mc-bq-query",
           "jog-mc-fm-service"]},
"flow01": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-transactions",
           "jog-mc-bq-query", "jog-mc-fm-service"]},
"flow02": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-personal", "jog-mc-bq-query",
           "jog-mc-fm-service"]}
ジョブタイプ
スケジュール
Control-Mはどのようにパイプラインワークフローをスケジュールしますか?
Control-Mは、サーバーとエージェントのモデルを使用してスケジュールを管理します。サーバーは、ワークフローのスケジューリングとエージェントへの提出を管理する中央エンジンです。この記事で説明されているデモでは、Control-Mサーバーとエージェントの両方がGoogle Compute Engine VMインスタンスで実行されています。
ワークフローは、データの到着などのさまざまなイベントに応じて最も一般的に起動されますが、事前に定義されたスケジュールに基づいて自動的に実行されることもあります。スケジュールは非常に柔軟で、ビジネスカレンダーを参照したり、週、月、四半期の異なる日を指定したり、間欠的にまたは「n」時間または分ごとにワークフローを実行する定義を行ったりできます。
Control-Mはどのようにデータを処理しますか?
Control-Mは、File Transfer、Dataflow、およびSLA管理というジョブタイプのシーケンスを通じてデータを処理します。各ジョブタイプは、パイプラインの異なるステージにマッピングされています。
ファイル転送ジョブタイプ
最初のジョブは、ジョブ:FileTransferタイプのjog-gcs-downloadと呼ばれます。このジョブは、ConnectionProfileSrcで説明された従来のファイルシステムから、ConnectionProfileDestで説明されたGoogle Cloud Storageにファイルを転送します。
ファイル転送ジョブタイプは、データ関連イベント(ファイル監視)をデータ転送の前提条件として監視することができ、成功した転送後のソースの削除、名前の変更、ソースと宛先の比較、または中断の際の失敗点からの再起動などの前後処理を実行できます。この例では、このジョブはLinux®ホストからいくつかのファイルを移動し、Google Cloud Storageバケットにドロップします。
SLA管理
    "jog-gcs-download" : {"Type" : "Job:FileTransfer",
        "Host" : "ftpagents",
        "ConnectionProfileSrc" : "smprodMFT",
        "ConnectionProfileDest" : "joggcp",
        "S3BucketName" : "prj1968-bmc-data-platform-foundation",
        "Description" : "First data ingest that triggers downstream applications",
        "FileTransfers" : [
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_personal_details.csv",
            "Dest" : "/bmc_personal_details.csv"
          },
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_fraud_details.csv",
            "Dest" : "/bmc_fraud_details.csv"
          },
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_transaction_details.csv",
            "Dest" : "/bmc_transaction_details.csv"
          }
        ]
      },
Dataflowジョブは、新たに到着したデータをBigQueryにプッシュするために実行されます。ジョブは複雑に見えますが、Google Cloudは定義を簡単にするための使いやすいプロセスを提供しています。
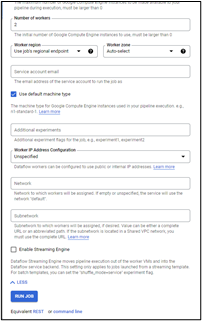
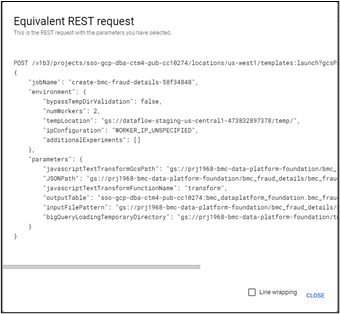
Dataflowジョブページ(図2)に移動します。既存のジョブがある場合は、それをクローンするか、テンプレートからジョブを作成するオプションを選択します。必要なパラメータを提供したら、下部のEquivalent RESTをクリックしてこの情報を取得します(図3)。これをジョブのパラメータセクションに直接カット&ペーストできます。
    "jog-dflow-gcs-to-bq-fraud": {"Type": "Job:ApplicationIntegrator:AI Google DataFlow",
        "AI-Location": "us-central1",
        "AI-Parameters (JSON Format)": "{"jobName": "jog-dflow-gcs-to-bq-fraud",
        "environment": {        "bypassTempDirValidation": false,
        "tempLocation": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/temp",
        "ipConfiguration": "WORKER_IP_UNSPECIFIED",
        "additionalExperiments": []    },
        "parameters": {
        "javascriptTextTransformGcsPath": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details_transform.js",
        "JSONPath": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details_schema.json",
        "javascriptTextTransformFunctionName": "transform",
        "outputTable": "sso-gcp-dba-ctm4-pub-cc10274:bmc_dataplatform_foundation.bmc_fraud_details_V2",
        "inputFilePattern": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details.csv",
        "bigQueryLoadingTemporaryDirectory": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/tmpbq"    }}",
        "AI-Log Level": "INFO",
        "AI-Template Location (gs://)": "gs://dataflow-templates-us-central1/latest/GCS_Text_to_BigQuery",
        "AI-Project ID": "sso-gcp-dba-ctm4-pub-cc10274",
        "AI-Template Type": "Classic Template",
        "ConnectionProfile": "JOG-DFLOW-MIDENTITY",
        "Host": "gcpagents"
      },
このジョブはSLAの完了基準を定義し、Control-Mにワークフロー全体を単一のビジネスエンティティとして監視させる指示を出します。
    "jog-mc-fm-service": {"Type": "Job:SLAManagement",
	 "ServiceName": "Model testing and scoring for fraud detection",
	 "ServicePriority": "3",
	 "JobRunsDeviationsTolerance": "3",
	 "CompleteIn": {
	    "Time": "20:00"
	  }
	},
ServiceName は、通知やサービスインシデントに表示されるビジネス関連の名前を指定し、技術者でないユーザーに対してもどのビジネスサービスが影響を受ける可能性があるかを明確にします。重要なのは、Control-Mは以前の実行から収集された統計を使用して、期待される完了を自動的に計算し、逸脱が最も早く検出され報告されるようにします。これにより、監視チームはビジネスサービスに影響が出る前に、早期にコースを修正する最大の機会を得ることができます。
Control-Mではパイプラインの状態をどのように監視しますか?
Control-Mは、パイプライン内のすべてのジョブのステータスを表示するリアルタイムのモニタリングインターフェースを提供し、失敗を特定し、ツール間を切り替えずにアクションを取ることを容易にします。
Control-Mはワークフローを監視するためのユーザーインターフェースを提供します(図4)。以下のスクリーンショットでは、最初のジョブは成功裏に完了し、緑色で表示され、次の3つのジョブは実行中で黄色で表示されています。実行を待っているジョブは灰色で表示されます。
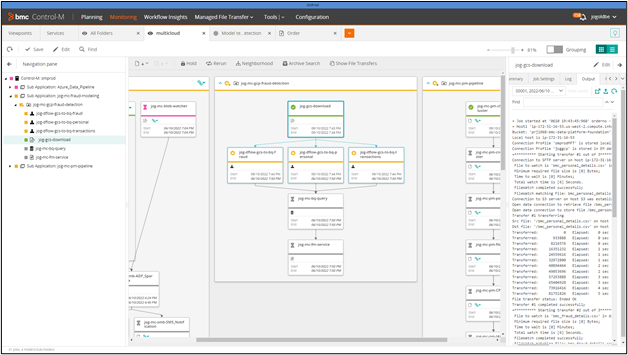
右側のペインから、すべてのジョブの出力とログにアクセスできます。この機能は、日常業務の際に重要です。これらの操作をより簡単に監視するために、Control-Mは、各アプリケーションのコンソールに接続することなく、異なるシステムで実行されているジョブの出力を表示するための単一のペインを提供します。
Control-Mはまた、ホールド、再実行、停止など、パイプライン内のジョブに対していくつかのアクションを実行することを許可します。たとえば、失敗をトラブルシューティングする場合や、ジョブをスキップする場合にこれらのアクションを実行する必要があります。
ここで説明したすべての機能は、RESTベースのAPIまたはCLIからも利用可能です。
結論
MLパイプライン全体にわたるワークフローの調整と監視は、Google Cloudが提供する豊富なMLツールセットがあっても、複雑なタスクであり続けます。ファイル転送、アプリケーション、データソース、またはインフラストラクチャを組み合わせたGoogle Cloud上でデータパイプラインをオーケストレーションする必要があるとき、Control-Mはワークフローオーケストレーションを簡素化できます。Control-Mは、オンプレミス、Google Cloud、またはハイブリッド環境のいずれにおいても、アプリケーションワークフローを統合、自動化、およびオーケストレーションします。
よくある質問
Google Cloudでデータパイプラインをオーケストレーションするための最良のツールは何ですか?
BMCのControl-Mは、クラウドおよびハイブリッド環境全体でデータパイプラインをオーケストレーションするために特別に設計されています。Google Cloud上では、Control-MはCloud Storage、Dataflow、BigQuery、Pub/Subとネイティブに統合され、チームは単一のインターフェースを介してワークフローを定義、スケジュール、および監視できます。視覚的エディタまたはRESTful APIを使用できます。
DataflowとControl-Mの違いは何ですか?
Google Cloud Dataflowは、ソースと宛先間でデータを移動および変換するマネージドデータ統合サービスです。Control-Mは、Dataflowジョブを含む複数のツールの実行を調整および監視するワークフローオーケストレーションエンジンです。Dataflowはデータ移動を処理し、Control-Mは全体のワークフローのシーケンス、スケジュール、およびエラーハンドリングを管理します。
Control-MはGoogle Cloudでジョブをコードとして実行できますか?
はい。Control-MはJSONおよびRESTful APIを使用したコードとしてのジョブアプローチをサポートしており、CI/CDツールチェーンに統合できます。Google Cloudの開発者ツールには、Cloud BuildやCloud Deployなどがあり、この方法と互換性があります。
Control-Mデータパイプラインで使用されるGoogle Cloudサービスは何ですか?
Google Cloud上でControl-Mがオーケストレーションする典型的なパイプラインは、データ着陸ゾーンとしてCloud Storageを使用し、ストリーミングデータ取り込み用にPub/Sub、ETL処理用にDataflow、分析およびクエリ用にBigQuery、視覚化用にData Studioを使用します。Control-Mは、これらすべてのサービスのシーケンスと監視を調整します。
Control-MはGoogle Cloudでパイプラインの失敗をどのように処理しますか?
Control-Mは、組み込みのエラーハンドリングおよびSLA管理機能を備えています。ジョブが失敗した場合、Control-Mは事前定義された基準に基づいて自動的に再起動したり、人間にエスカレーションしたりできます。SLA管理ジョブタイプは、ワークフロー全体を単一のビジネスエンティティとして監視し、過去の実行データを使用して完了時間を予測し、ビジネスSLAが違反される前に逸脱を監視チームに警告します。
この投稿に表現された見解や意見は著者のものであり、必ずしもBMCの公式な立場を反映しているわけではありません。
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。