




ポイント: Neo4jは、データをノード、エッジ、およびプロパティとして整理し、ビッグデータ分析に最適なリーディンググラフデータベースです。無料のコミュニティエディションとエンタープライズ版の試用版を提供しており、ユーザーはCypherクエリ言語を使用して複雑な関係を管理できます。
- Neo4jのようなグラフデータベースは、ソーシャルコネクションなどの関係を示すのに優れています。
- その強力な機能とグラフアルゴリズムのサポートがその人気に寄与しています。
Neo4jはグラフデータベースです。グラフデータベースは、行と列の代わりにノード、エッジ、およびプロパティを持っています。これは、特定のビッグデータおよび分析アプリケーションにおいて、行と列のデータベースや自由形式のJSONドキュメントデータベースよりも適しています。
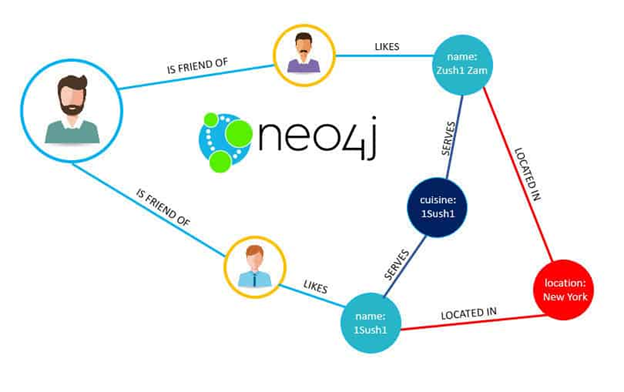
グラフデータベースは、関係を表現するために使用されます。その最も一般的な例は、Facebookの友人関係やいいねの関係です。以下のNeo4jのグラフィックでいくつか見ることができます。
円はノードです。線はエッジと呼ばれ、関係を示します。円の中のコメントは、そのノードのプロパティです。
Neo4jについて書くのは、マーケットシェアが最も大きいためです。この市場には他のプレーヤーもいます。そして、Neo4Jによると、Apache Spark 3.0は、DataFramesを基にしたプロパティグラフをSparkに追加して簡単にするために、Neo4j Cypherクエリ言語を追加します。SparkはすでにGraphXをサポートしており、これはRDDの拡張でグラフをサポートします。それについては別のブログ記事で説明します。
別の記事では、グラフアルゴリズムについても説明します。その中で最も有名なのはGoogle Page Rankインデックスです。アルゴリズムはノードやエッジをナビゲートする方法です。
コストは?
Neo4Jは無料ですか?それはかなり複雑です。コミュニティエディションは無料です。学習に適したデスクトップ版も無料です。エンタープライズエディションは無料ではありません。これは他のオープンソース製品と一致します。Neo4Jに長期間製品を使用するためのライセンスを求めたところ、デスクトップ版を使用することを勧められました。エンタープライズ版には30日間の試用期間があります。
市場には他の代替品もあります。重要なのは、ビジネスが倒産しないように十分なユーザーがいるものを選ぶことです。どれを使用すべきですか?それを理解するために調査が必要です。
Neo4Jをインストール
デスクトップ版またはtar版を使用できます。ここではtar版を使用しています。ダウンロードしてから、以下に示すようにシェルを起動します。そのためにはJava JDKが必要です。
export JAVA_HOME='/Library/Java/JavaVirtualMachines/jdk1.8.0_201.jdk/Contents/Home'
サーバーを起動し、初期パスワードを設定してからcypher-shellを開きます。デフォルトのURLは少し奇妙なbolt://localhost:7687です。
    cd neo4j bin folder

neo4j-admin set-initial-password xxxxxx

./cypher-shell   -a bolt://localhost:7687  -u neo4j  -p xxxxx
単一ノードを作成
ノードを円やオブジェクトとして考えてください、上の画像のように。プロパティやラベルを持つことができます。
以下は、ノードを作成する最も簡単な方法です。(各cypherコマンドはセミコロンで終了する必要があります。)このノードには何も付いていません、つまりプロパティやラベルはありません。変数nだけがあり、他の操作で使用できます。このすべての意味は、次のステップで明確になります。
    create (n);

0 rows available after 13 ms, consumed after another 0 ms
Added 1 nodes
Cyper SQLは、Neo4jが呼ぶコマンド言語です。コマンドを実行すると、returnキーワードを追加しない限り、値は返されません。この例では、以前と同様に、何も入っていないノードを作成します。Neo4jは、このオブジェクトを表す変数xを作成します。それを使用して、returnステートメントでそれを表示させたり、後続の操作で使用したりできます。
    create(x) return x ;

+----+
| x  |
+----+
| () |
+----+
複数ノードを作成
一度に複数のノードを作成できます:
    create (o),(p);
0 rows available after 13 ms, consumed after another 0 ms
Added 2 nodes
ラベル付きノードを作成
ラベルはノード名のようなもので、タイプとして考えることができます。以下はStudentというラベルのあるノードです。ラベルの前にはコロン(:)があります。前と同様に、sは単なる変数です。そのスコープはシェルの生存期間です。シェルを閉じると、変数は消えます。
    create (s:Student);
0 rows available after 16 ms, consumed after another 0 ms
Added 1 nodes, Added 1 labels
複数のラベルでノードを作成できます:
create (s:Student:Biology) return s;
ラベルに加えて、ノードにはプロパティがあり、JSONとして指定されます:
    CREATE (x:Employees { name: 'Walker', title: 'Tech Writer' })
CREATE (y:Employees { name: 'Stephen', title: 'Manager' })
return x,y;
関係を作成
関係を作成するための構文は奇妙に見えます。以下の例の関係はBOSSと呼ばれます。その前のrは単なる変数です。そして矢印は方向を示します。->、<-、または-を使用して方向を示すことができます。方向を覚えるのが複雑なので、方向が重要でない場合は、本当に複雑なモデルで-(ダッシュ)を使用することをお勧めします。それは設計の決定です。
以下は関係を作成する方法です。この例では、スティーブンがウォーカーのBOSSであると言います。MATCHステートメントはSQLの選択のようなもので、どの二つの要素が互いに接続されるべきかの選択基準を示します。
そして、ここではxとyを一時変数として使用します。これにより、後続のステートメントで、: labelの代わりに変数名を使用するショートハンド表記を使用できます。
    MATCH (x:Employees),(y:Employees)
WHERE y.name = "Stephen" AND x.name = "Walker"
CREATE (x)-[r:BOSS]->(y)
RETURN type(r);
さて、論理を逆方向に進めます。スティーブンがウォーカーの上司であれば、ウォーカーはスティーブンのために働いています。したがって、ウォーカーはEMPLOYEEOFスティーブンになります。任意の説明的な名前を使用できます、例えばEMPLOYEEOFです。
    MATCH (x:Employees),(y:Employees)
WHERE y.name = "Stephen" AND x.name = "Walker"
CREATE (y)-[r:EMPLOYEEOF]->(x)
RETURN type(r);
複数の関係を作成
ここでは別の例を示します。ここには薬物のモデルがあり、それらが何に使用され、誰が作っているかがあります。
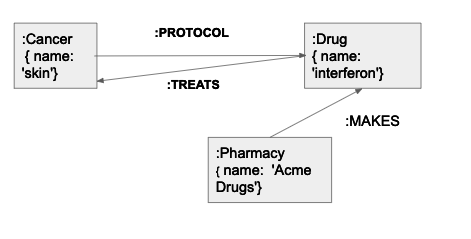
データを作成してから、関係を作成します。間違いを犯した場合、MATCHステートメントがデータを見つけられないと、関係にもデータがないことに注意してください。言い換えれば、nノードを作成またはn関係を作成と表示されるべきです。ここでnは0より大きいです。
    CREATE (x:Cancers { name: 'skin'});
CREATE (x:Drugs { name: 'interferon'});
CREATE (x:Pharmacy { name:  'Acme Drugs'});

MATCH (a:Cancers),(b:Drugs)
WHERE a.name = 'skin' AND b.name = 'interferon'
CREATE (a)-[rp:PROTOCOL]->(b), (b)-[rt:TREATS]->(a);

MATCH (a:Pharmacy),(b:Drugs)
WHERE a.name = 'Acme Drugs' AND b.name = 'interferon'
CREATE (a)-[r:MAKES]->(b);
ここでは両方向に関係を作成し、同時に二つの関係を作成します。bとaが位置を入れ替えて、どちらがどちらに属するかを示します。矢印を逆方向に指すこともできます。
    MATCH (a:Cancers),(b:Drugs)
       WHERE a.name = 'skin' AND b.name = 'interferon'
       CREATE (a)-[rp:PROTOCOL]->(b), (b)-[rt:TREATS]->(a);
クエリ
ここではMATCHがどのように機能するかをさらに説明します。まず、Pharmacyラベルを持つすべてのノードをリストします。
    MATCH (p:Pharmacy) return p;
+----------------------------------+
| p                                |
+----------------------------------+
| (:Pharmacy {name: "Acme Drugs"}) |
+----------------------------------+
次に、薬を作る薬局のすべての関係を示します。
    MATCH (p:Pharmacy)-[r:MAKES]->(b:Drugs) return p,b;
+------------------------------------------------------------------+
| p                                | b                             |
+------------------------------------------------------------------+
| (:Pharmacy {name: "Acme Drugs"}) | (:Drugs {name: "interferon"}) |
+------------------------------------------------------------------+
データビジュアライゼーションガイド
これらの投稿は私自身の意見であり、BMCの立場、戦略、または意見を必ずしも代表するものではありません。