




ポイント: Matplotlibの対数スケールは、広範な範囲にわたって値を効果的に表示することにより、データビジュアライゼーションを強化します。これにより、小さな数と大きな数を解釈可能にします。10の冪を使用することで、小さな値の圧縮を回避します。
- 対数スケールは、広範なデータ範囲を視覚化するために不可欠です。
- コードの例は、Matplotlibプロットでの対数スケールの実装方法を示しています。
この記事では、Matplotlibで対数スケールを使用する方法を説明します。
対数スケールは、非常に小さい数と非常に大きい数を含むデータをプロットするのに便利です。なぜなら、スケールはデータをプロットし、すべての数を簡単に見ることができるからです。小さい数が近くに押しつぶされることはありません。
対数
まず、高校の数学を少し復習しましょう。対数は、大きな数を小さく見せる方法で、10の冪として見ることができます。数学で使用される自然対数のように、10以外の対数の基底もあります。これは定数e=2.718....で与えられます。しかし、私たちの目的では、基底10の対数を使用します。
要するに:
log10x = yは、10をyの冪に上げるとxになることを意味します。すなわち、10 ** y = xです。したがって、log10100=2です。なぜなら、10**2 = 100だからです。
Matplotlibの対数スケール
Matplotlibの2次元チャートにはyscaleとxscaleがあります。スケールは軸に沿った目盛りを意味します。彼らは次のいずれかです:
- matplotlib.scale.LinearScale - これは単に数値、例えば1、2、3です。
- matplotlib.scale.LogScale - これは10の冪です。基底2や自然対数の値など、任意の基底を使用できます。異なる基底を使用すると、プロットされた要素の間隔が狭くなったり広くなったりし、視認性が向上します。
- matplotlib.scale.SymmetricalLogScaleおよびmatplotlib.scale.LogitScale - これは、特に非常に小さい数の対数が非常に大きな負の数である場合、1未満の数に使用されます。
対数スケールの使用
いくつかの大企業といくつかの小企業の収益をプロットしてみましょう。
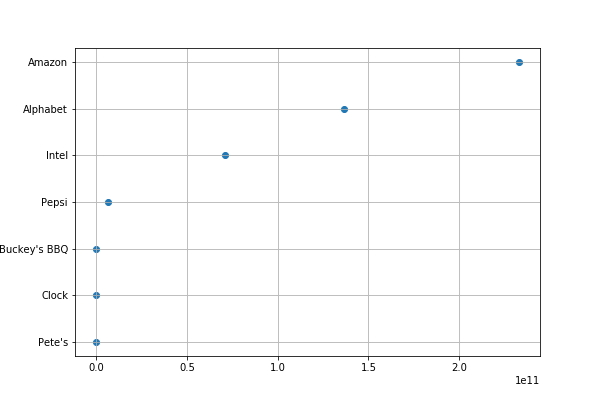
Amazon、Alphabet(Google)、およびIntelは、小企業のPete's、Clock、Buckey's BBQ(私たちが作ったもの)よりも何倍も大きいです。彼らの相対的な違いは巨大であり、各小企業のプロットは線形スケールの同じ垂直線0に位置します。
Matplotlibは、明示的に設定しない場合、軸のスケールを選択します。ここでは設定していません。下部のle11表記は、x軸が科学的表記であることを意味します。この場合、収益は10**11の倍数(1000億ドル)として表示されます。Amazonの収益は$232,887,000,000で、2.325*(10**11)です。一方、Pete'sの$600,000は、11の冪では0.000006*(10**11)です。これにより、非常に大きな企業であるPepsiでさえも、以下のチャートでは0に近いことが説明されます。
したがって、次のグラフで対数スケールを使用することでこの問題を修正します。以下にコードの説明があります。
    import matplotlib.pyplot as plt
import numpy as np
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = {
        "Pete's":           600000,
        "Clock":           1600000,
        "Buckey's BBQ":    2600000,
        "Pepsi":        6466000000,
        "Intel" :      70848000000,
        "Alphabet":    136819000000,
        "Amazon":      232887000000
        }

df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
dg =pd.to_numeric(df['Revenue'])
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
dat = df.assign(Company=dc.values)

data = dat.sort_values(by=['Revenue'])

plt.scatter(data['Revenue'],data['Company'])
plt.grid()
plt.show()
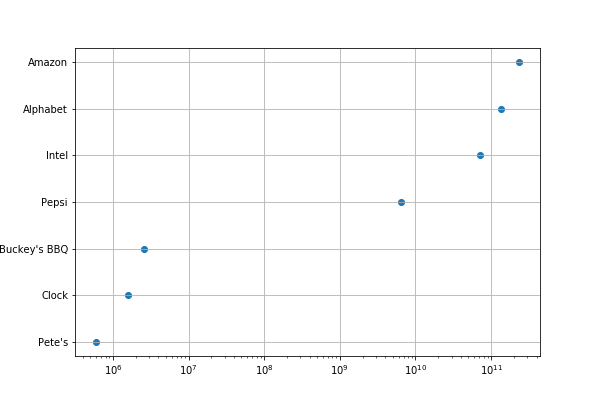
ここでは、すべてが同じですが、plt.xscale("log")を含めました。これにより、値をより簡単に見ることができるようになります。なぜなら、それらは10の冪だからです。したがって、Pete'sの小さな$600,000の収益は、6*(10**6)として簡単に見ることができます。そして、Amazonの収益は約100,000 (10**5)倍大きいです。
    import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = {
        "Pete's":           600000,
        "Clock":           1600000,
        "Buckey's BBQ":    2600000,
        "Pepsi":        6466000000,
        "Intel" :      70848000000,
        "Alphabet":    136819000000,
        "Amazon":      232887000000
        }

df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
dg =pd.to_numeric(df['Revenue'])
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
dat = df.assign(Company=dc.values)

data = dat.sort_values(by=['Revenue'])

plt.scatter(data['Revenue'],data['Company'])
plt.grid()
plt.xscale("log")
plt.show()
今、各企業の規模を収益によってより明確に見ることができます
コードの説明
このコードの一部は、データサイエンスに精通していないと理解しにくいかもしれません。なぜなら、PandasとNumPyを使用しているからです。これは皮肉なことに、Pandasは特にテーブル型データの作業を容易にするために作成されました。
最初のステップは、辞書として作成したデータをPandasのdataframeに変換することです。このデータのインデックスは企業名になります。最初のエントリをインデックス値として取得することを意味するorient='index'と言いました。その後、columns=['Revenue']で列名を指定します。企業名には列名がありません。なぜなら、それは列ではなく行のインデックスだからです。
df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
次に、収益の文字列を数値に変換する必要があります。そうしないと、matplotlibは文字としてソートします。
dg =pd.to_numeric(df['Revenue'])
今、私たちはseriesを作成したいと思います。これは、1つの列のみを持つdataframeです。値は前のdataframeのインデックスになります。これが、企業をデータの列としてリストする方法です。Companyという名前が付けられます。
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
次に、先ほど作成したseriesの値をdatdataframeの別の列として追加します。
dat = df.assign(Company=dc.values)
その後、x値とy値のdataframeを使って散布図をプロットします。それぞれの形状は同じで、(7,)です。これはdata['Revenue'].shapeで確認できます。Shapeは、時には難しいNumPyの概念です。基本的には配列の次元を意味します。xyプロットでは、同じでなければなりません。
plt.scatter(data['Revenue'],data['Company'])
残りは自明です:
    plt.grid()
plt.xscale("log")
plt.show()
データビジュアライゼーションガイド
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。