




ポイント: Hadoop Analyticsは、MapReduce、統計、機械学習アルゴリズムに関する知識に基づいて分析モデルを構築するためのフレームワークを提供します。データ操作のためのプラットフォームとして機能し、Sparkはそのネイティブな機械学習機能のおかげで、より高速な代替手段として認識されています。
- Hadoopは、データ構造の操作を通じて分析モデルの作成を容易にします。
- 効果的な分析のためには、統計と機械学習の熟練が重要です。
Hadoop分析101
Apache Hadoop自体は分析を行いません。しかし、分析モデルを構築するためのプラットフォームとデータ構造を提供します。そのためには、MapReduce関数を理解し、分析アルゴリズムに必要な形式で入力データを作成する必要があります。ここでそれを説明し、いくつかの分析関数を探ります。
Hadoopは最初の、そして最も人気のあるビッグデータベースです。後に登場した製品は、Hadoopの成功を活用しようとして、それに対応するように製品を構築しました。これにはSpark、Hadoop、Hbase、Flink、Cassandraが含まれます。しかし、Sparkは実際にはHadoopの代替品と見なされています。Hadoopにはないもの、すなわちネイティブな機械学習ライブラリであるSpark MLを持っており、メモリ内データベースであるため、Hadoopよりもはるかに速く動作します。
Hadoopとネイティブに動作する分析パッケージに関しては、FrinkとMahoutに限定されます。Mahoutは廃れているので、それを使用しない方が良いでしょう。したがって、最良の選択肢は、HadoopまたはFlinkテーブルでFlinkを使用するか、Hadoopまたは他の場所に格納されたデータと共にSpark ML(機械学習)ライブラリを使用し、結果をSparkまたはHadoopに保存することです。

(この記事は、私たちのHadoopガイドの一部です。右側のメニューを使用してナビゲートしてください。)
分析の定義
分析を理解するには、基本的な記述統計(以下で説明します)や線形代数、行列、ベクトル、および多項式を理解する必要があります。これは大学で学ぶもので、少なくとも科学の学位を追求した人はそうです。それを理解せずに、K-Means分類モデルや線形回帰が何を意味するのかを理解することは決してできません。これが、通常のプログラマーが常にデータサイエンスを行うことができない理由の一つです。分析はデータサイエンスです。
分析は、大規模データに数学、統計、および人工知能を適用することです。人工知能は機械学習とも呼ばれます。これらは数学関数です。各アルゴリズムの背後にある論理的推論を理解することが重要です。そうしないと、誤った結論を導く可能性があります。
分析には、行列と線形代数を使用するための分散スケーラブルアーキテクチャが必要です。非常に大きな行列の乗算は、単一のマシンのすべてのメモリを消費する可能性があります。そのため、そのタスクは小さなタスクに分割する必要があります。
行列は次のような構造です:
    [a11, a12, a13,...,a1n
A21, a22, a23, … a2n
…
A i1, ai2, ai3, …, ain]
これらの行列は、アナリストがいくつかのビジネスまたは科学の問題を解決することを期待している式の係数です。たとえば、製品pの最適価格はp = ax + by + cであるかもしれません。ここで、xとyは製造と販売へのいくつかの入力で、cは定数です。
しかし、それは小さな例です。アナリストが扱う変数のセットは通常はるかに大きいです。さらに、アナリストは同時にこのような複数の方程式を解決しなければならないことがよくあります。これが、行列を使用する理由です。
行列は、Scala、Python、R、Java、Pythonなどのプログラミング言語を使用してMLアルゴリズムに供給されます。これらのオブジェクトは何でも構いません。たとえば、構造を混ぜ合わせることができます:
    Tuple(a,b,a)

Tuple(int, float, complex number, class Object)

Array (“employees:” “Fred”, “Joe”, “John”, “William)
したがって、Hadoopを使用して分析を行うには、Hadoop内のデータを異なるデータ構造に変換する方法を知っている必要があります。それにはMapReduceを理解する必要があります。
MapReduce
MapReduceは2つのステップに分かれています:mapとreduce。(一部の人はcombineが3番目のステップだと言いますが、実際にはreduceステップの一部です。)
両方のmapとreduceを常に行う必要はありません。特に、1つの入力データセットをMLアルゴリズムに適した形式に変換したいだけの場合はそうです。Mapは、供給された値を繰り返し、新しい出力形式に変更します。reduce操作は1つの値を返すように設計されています。これはある意味単純化ですが、ほとんどの場合は正しいです。(Reduceは1つ以上の出力を返すことができます。たとえば、以下に示すサンプルプログラムではそうします。)
MapReduce例プログラム
ここでは、Apache Hadoopのウェブサイトから直接コピーしたWord Countプログラムを示します。以下に実行方法を示し、各セクションの意味を説明します。
最初にテキストファイルを作成し、それをHadoopにコピーする必要があります。以下にその内容を示します:
    hadoop fs -cat /analytics/input.txt

Hello World Bye World
プログラムは、その行の各単語を取得し、これらのキー->値のマップを作成します:
    (Hello, 1)
(World, 1)
(Bye, 1)
(World, 1)
それをキーごとにグループ化して各値を合計することによって、これらのキー->値マップを生成します:
    (Hello, 1)
(World, 2)
(Bye, 1)
ここにJavaコードがあります。
    package com.bmc.hadoop.tutorials;

import java.io.IOException;
import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
public class WordCount {
public static class TokenizerMapper
extends Mapper<object , Text, Text, IntWritable>{
private final static IntWritable one = new IntWritable(1);
// テキストは通常のテキストフィールドですが、Hadoopによってシリアライズ可能です。
private Text word = new Text();
// Hadoopは入力ファイルの各行に対してmap操作を呼び出します。このファイルには1行しかありませんが、最初のステップとしてStringTokenizerを使用して単語を分割し、キー->値ペアを作成します。
    public void map(Object key, Text value, Context context
 ) throws IOException, InterruptedException {
 StringTokenizer itr = new StringTokenizer(value.toString());
 while (itr.hasMoreTokens()) {
word.set(itr.nextToken());
// これにより、出力をキー->値マップ(単語、1)として書き込みます。
    context.write(word, one);
      }
    }
  }
// この削減コードはHadoopソースコードから直接コピーされています。ここにコピーされているのは、ここで読むことができるようにするためです。このreduceは出力をキー->値ペア(キー、結果)として書き込みます。
    public static class IntSumReducer
       extends Reducer {
    private IntWritable result = new IntWritable();

    public void reduce(Text key, Iterable values,
                       Context context
                       ) throws IOException, InterruptedException {
      int sum = 0;
      for (IntWritable val : values) {
        sum += val.get();
      }
      result.set(sum);
      context.write(key, result);
    }
  }

  public static void main(String[] args) throws Exception {
    Configuration conf = new Configuration();
    Job job = Job.getInstance(conf, "word count");
    job.setJarByClass(WordCount.class);
// ここでは、マッピング、結合、および削減関数に使用するクラスを指定します。
    job.setMapperClass(TokenizerMapper.class);
job.setCombinerClass(IntSumReducer.class);
job.setReducerClass(IntSumReducer.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
FileInputFormat.addInputPath(job, new Path(args[0]));
FileOutputFormat.setOutputPath(job, new Path(args[1]));
System.exit(job.waitForCompletion(true) ? 0 : 1);
  }
}
これを実行するには、最初にHadoop内に/analyticsフォルダーを作成する必要があります:
hadoop fs -mkdir /analytics
次のようにコードを実行します:
yarn jar /tmp/WordCount.jar com.bmc.hadoop.tutorials.WordCount /analytics/input.txt /analytics/out.txt
その後、出力を確認します。最初にhadoop fs -ls /analytics/out.txtを使用して、結果がoutput.txtフォルダーに保存されるファイル名を取得します
hadoop fs -cat /analytics/out.txt/part-r-00000
これが結果のカウントです。
    Bye	1
Hello	1
World	2
記述統計
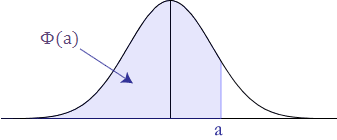
これらのモデル分析を理解するためには、記述統計を理解する必要があります。これは、大学や高校で教えられる平均、平均(μ)、分散(σ2)、および標準偏差(□)です。統計学では、正規分布を使用してイベントの確率を計算します。曲線が高く、点が近いほど、分散が小さく、したがって標準偏差も小さくなります。
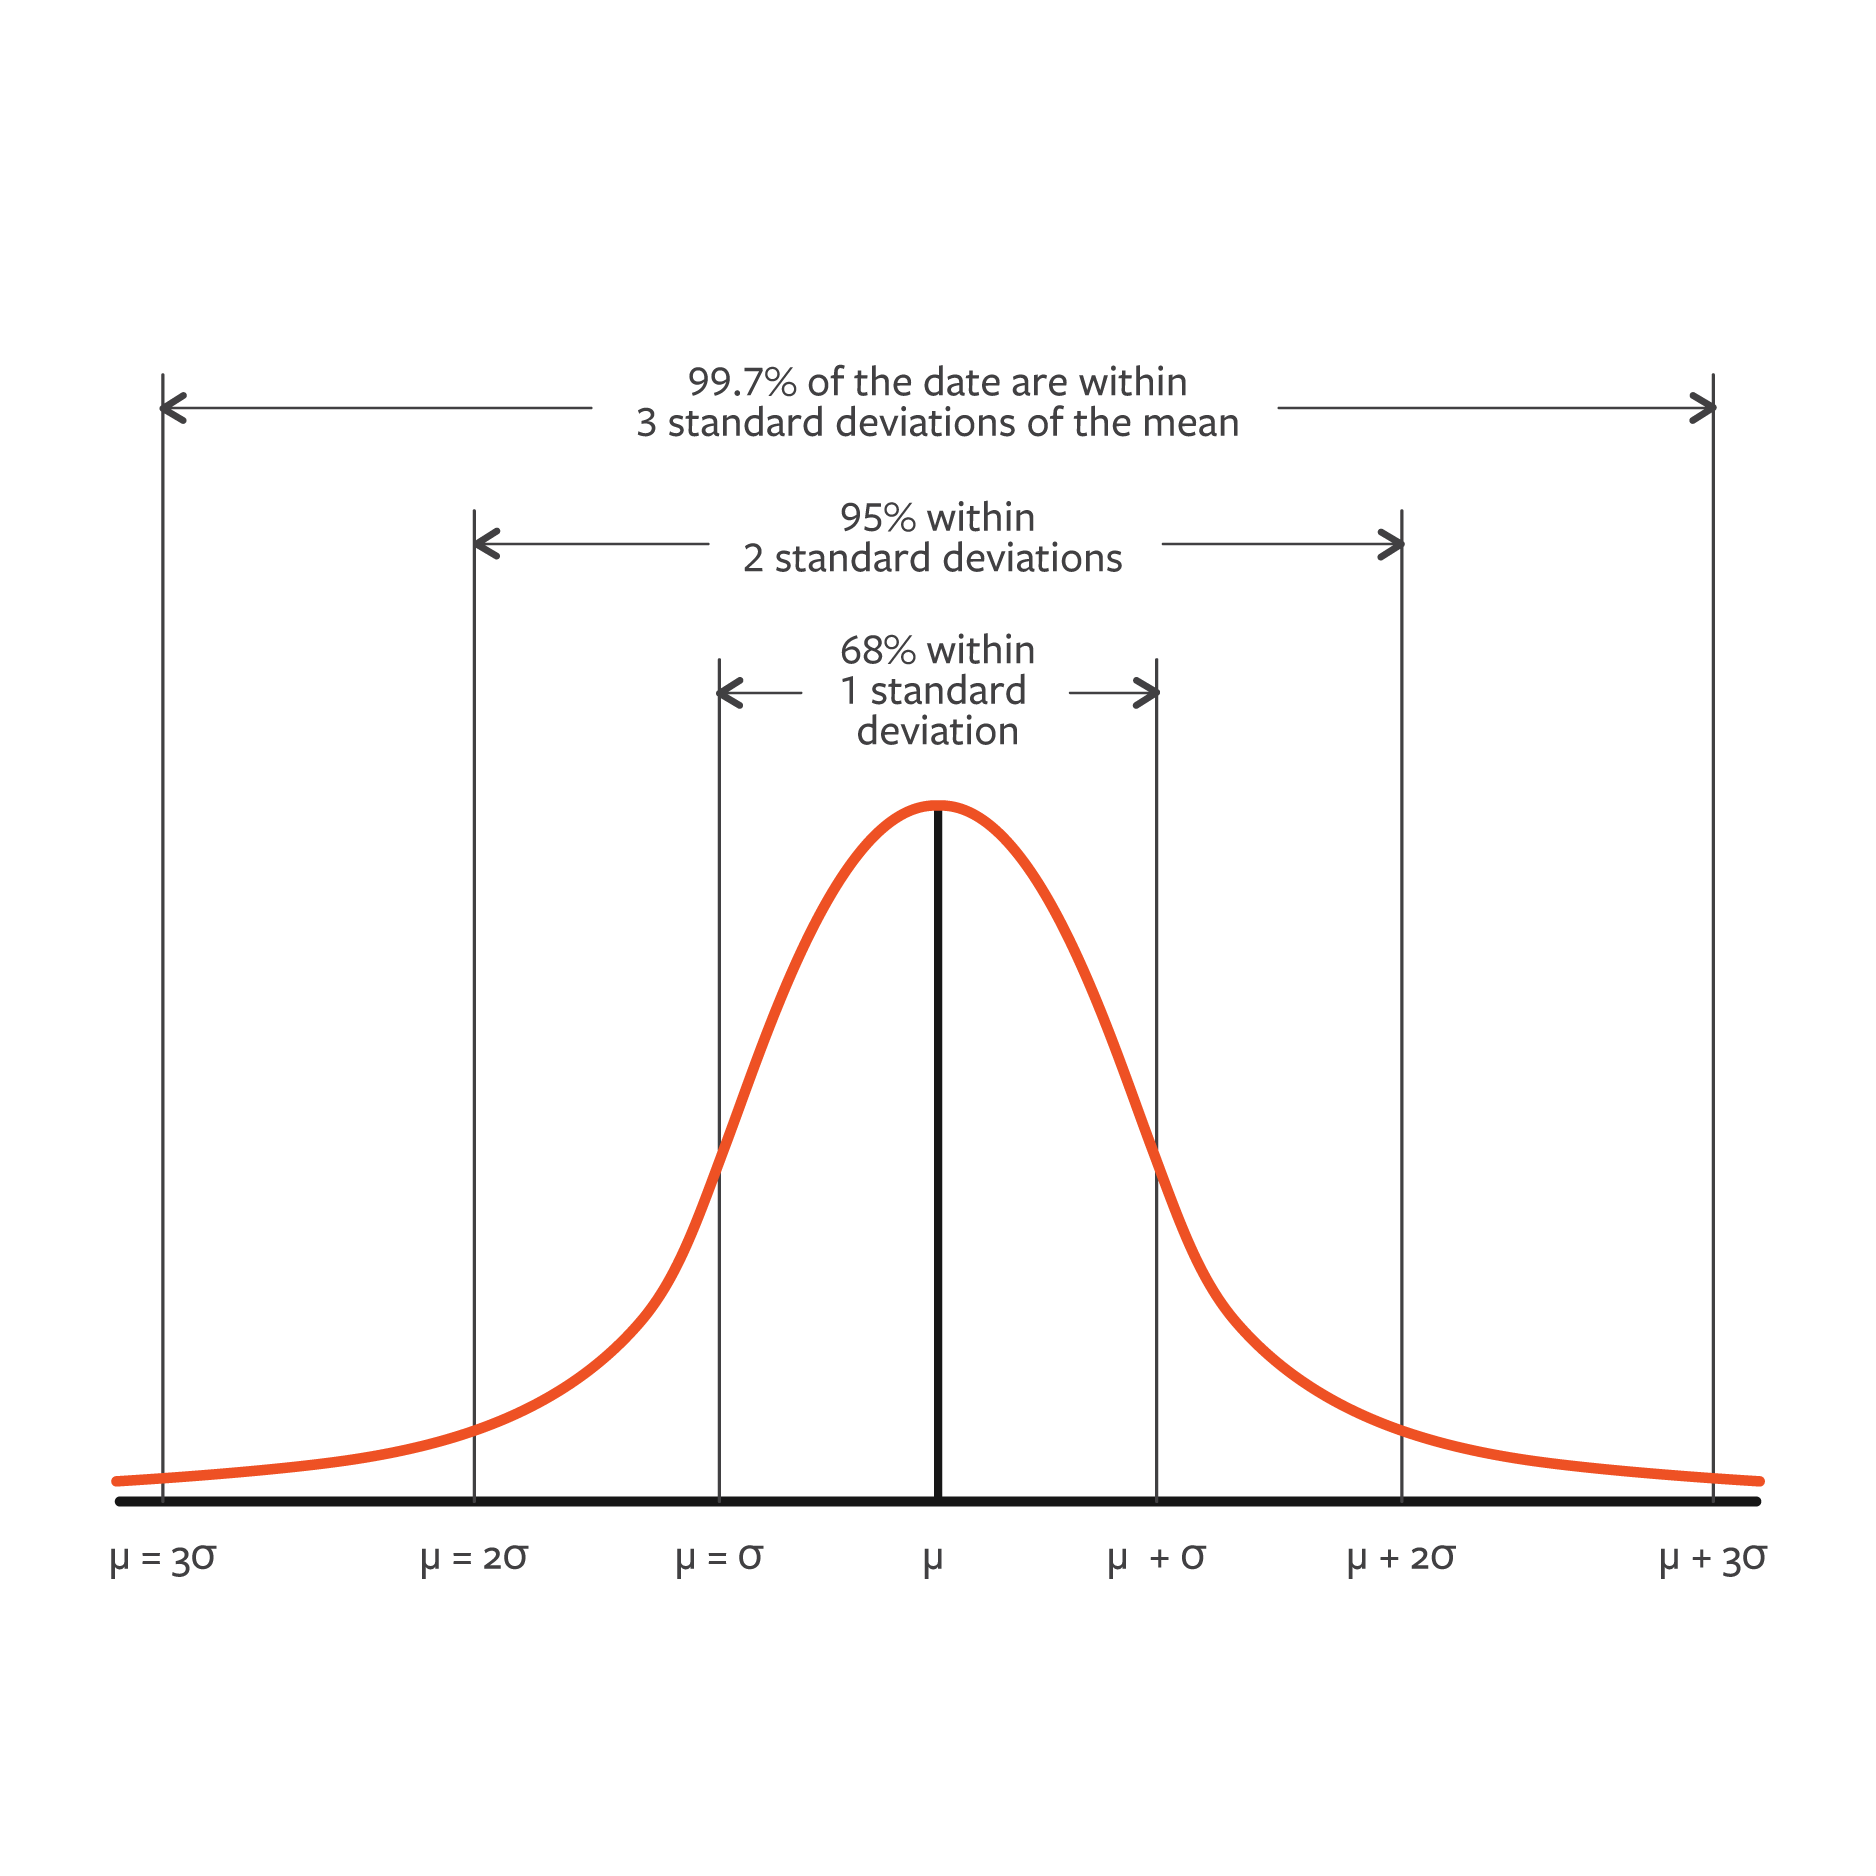
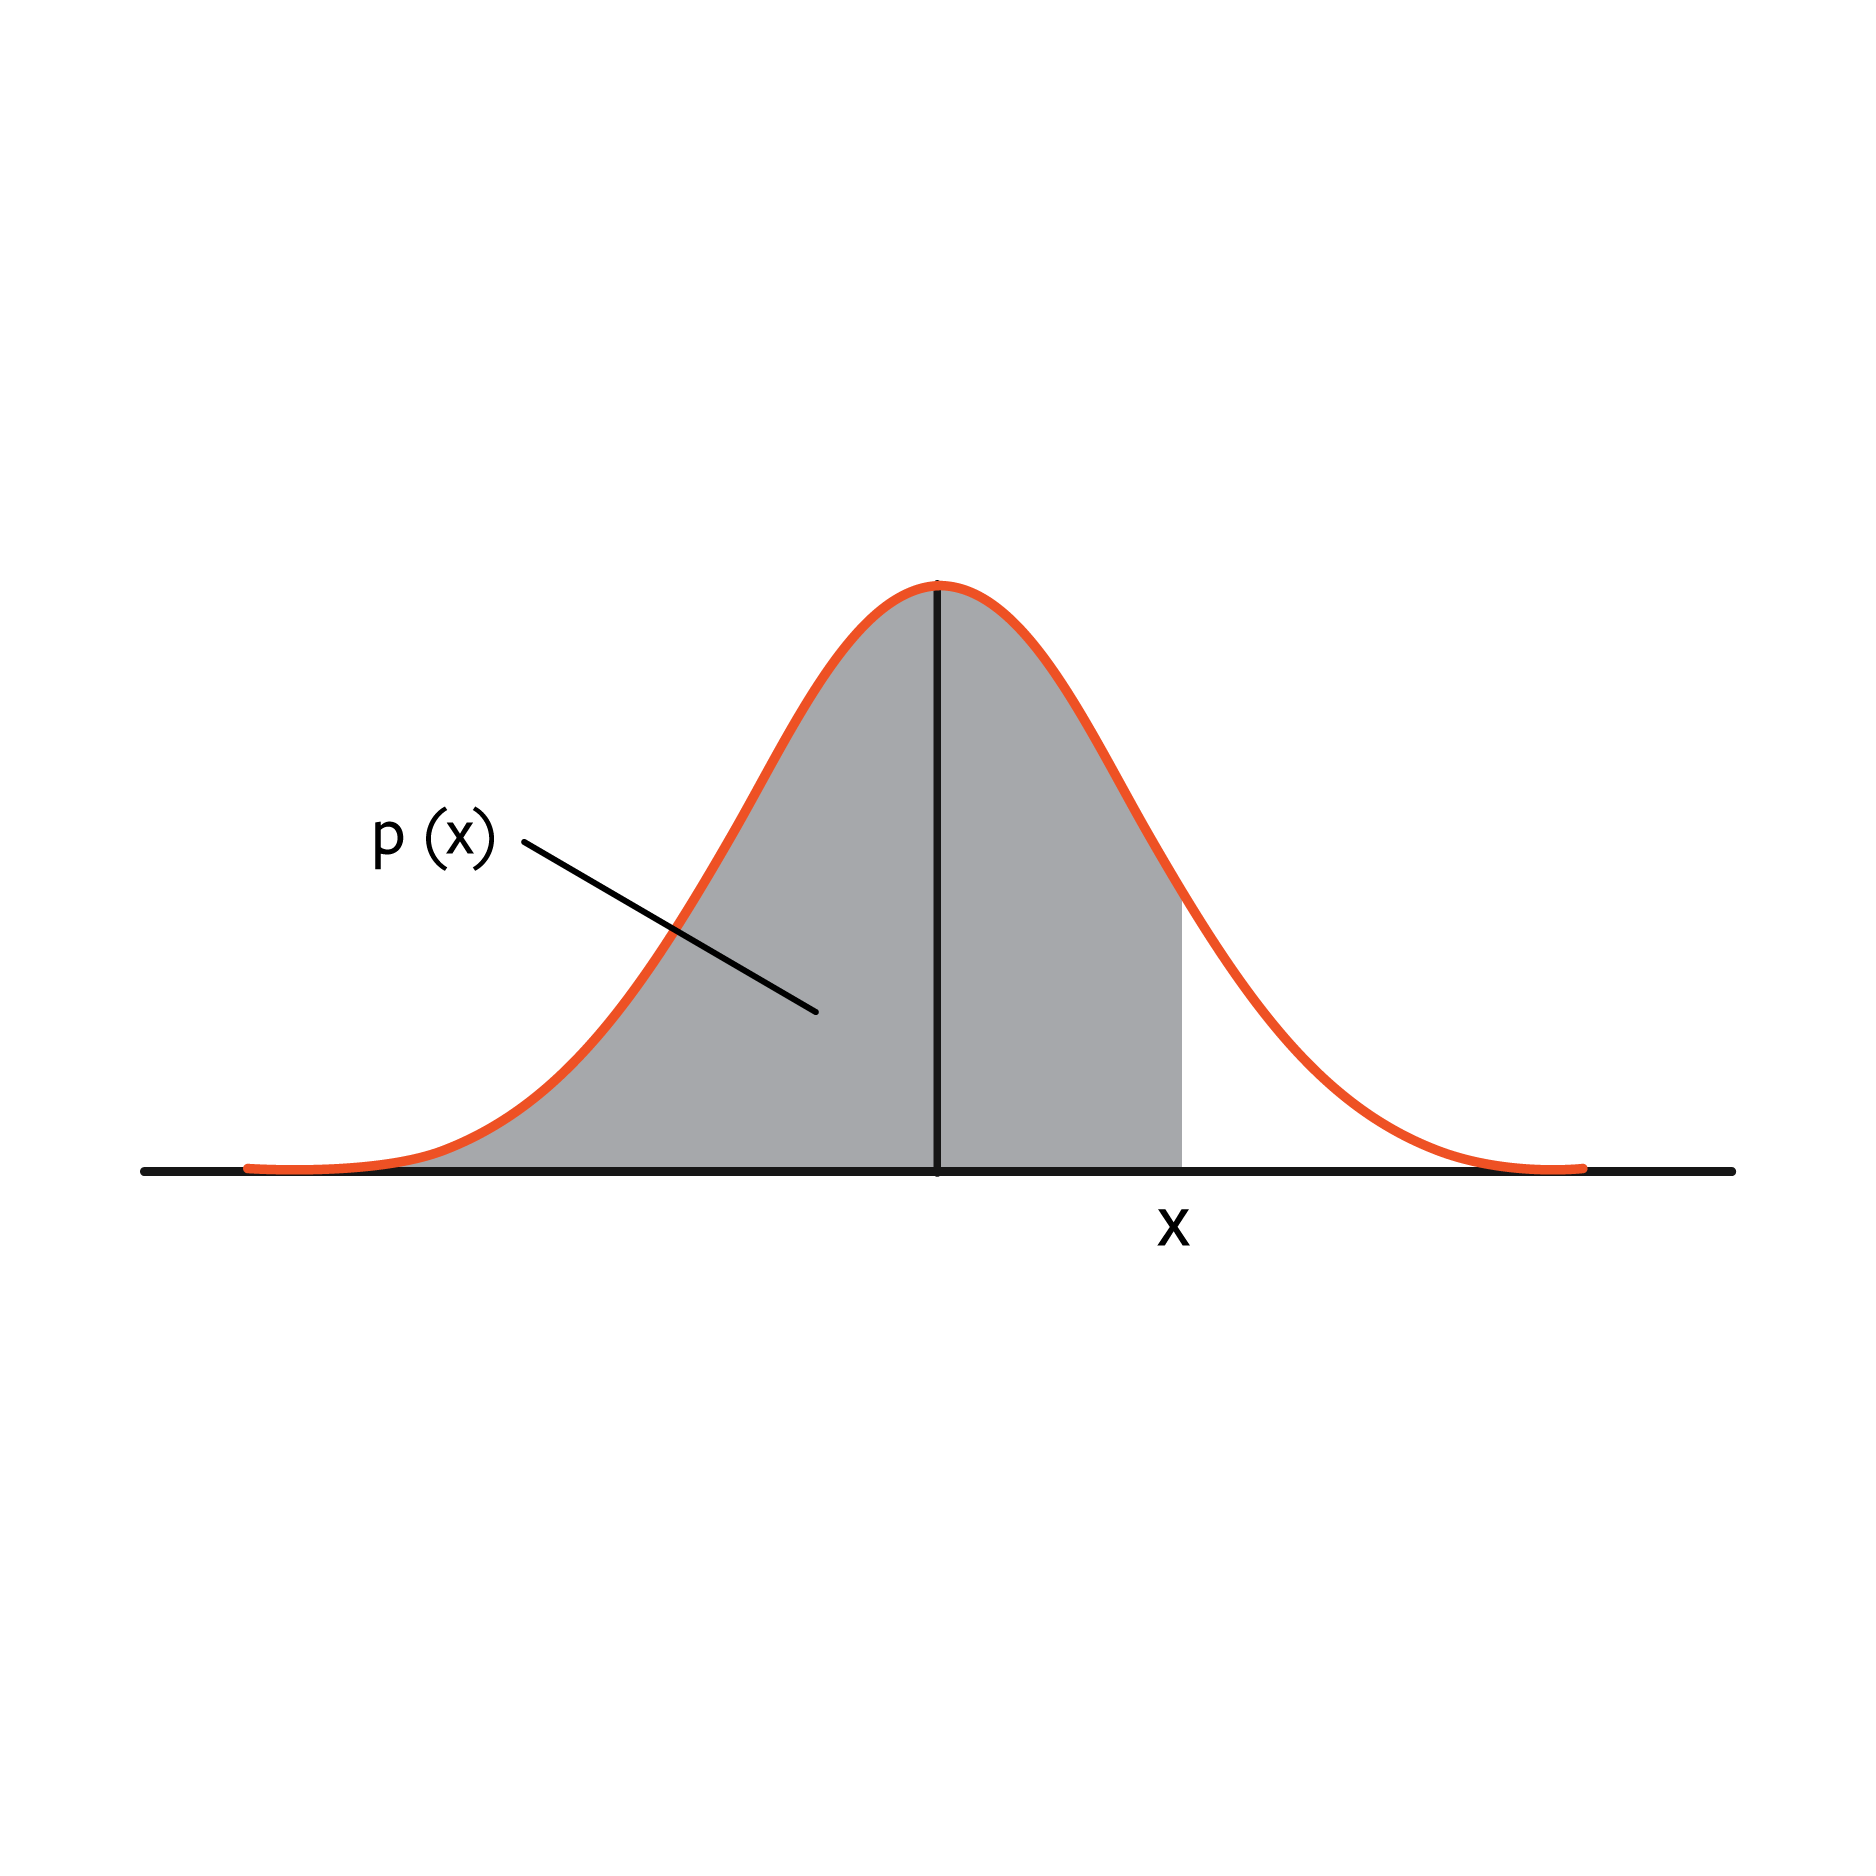
正規曲線は確率のグラフィカルな表現です:p(x)。たとえば、上記のx以下の値の確率はp(x)です。
線形回帰
ここでは、いくつかの分析アルゴリズムがどのように機能するかについて一般的に話します。
線形回帰は予測モデルです。機械学習の観点から見ると、最も単純です。最初に学ぶのは良いアイデアです。なぜなら、その基本的な形式と線形関係は、より複雑なMLアルゴリズムでも同じであるからです。
最も単純な形では、線形回帰には1つの独立変数xと1つの従属変数y=mx +bがあります。
これを次のようにグラフ化できます:
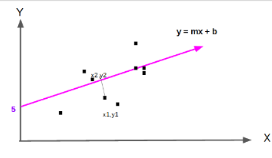
y = mx +bの直線は、データポイントから紫色の線への距離が最も短いものです。
Apache Sparkで直線を計算するアルゴリズムは次のとおりです:
org.apache.spark.ml.regression.LinearRegression
ロジスティック回帰
線形回帰では、データポイントに最も近い直線を見ます。ロジスティック回帰では、それを確率に変換します。ロジスティック回帰の出力logitは2つの値のいずれか(0、1)です。これは確率関数p(x)に関連しています。慣例として、p(x) > 0.5の場合、logit(p(x))=1、そうでなければ0です。
ロジスティック回帰は、以下に示す累積分布関数で、ここでeは定数e、sはスケールパラメータです。
1 / (1 + e**-((x -□) /s))
それが奇妙に見える場合は心配しないでください。さらに下に移動すれば、私たちが使用しているおなじみの線形関数が見えてきます。
ロジスティック回帰が正規曲線の下の累積分布を表すことを理解するには、正規曲線のx=□の点を考えてください。その点でx - □ = 0なので、1 / (1 + e**-((x - □) /s))=1 / (1 + e**((1 - 1 )/s)) = 1/ ( 1 + e**0) = 1/ ( 1 +1) = 1/2 = 0.5。つまり、x = □でy軸の左側の陰影部分は、その平均よりも小さくなる確率は50%です。これを示すグラフは再度ここに示されています:
ロジスティック回帰アルゴリズムでは、Spark MLにおけるLabeledPoint構造が必要です。
(labels, points)
これをLogisticRegressionWithLBFGSアルゴリズムにプラグインしました。ラベルは1または0でなければなりません。ポイント(特徴)は、以下に示すように、任意の値のコレクションであることができます。
    (1: {2,3,4})
(0:{4,5,6})
供給するデータはトレーニングセットと呼ばれます。言い換えれば、実際のデータのサンプリングです。これらは過去の歴史から取得されます。これにより、コンピュータはデータに最もよくフィットする方程式を見つけることができます。そして、その後、予測を行うことができます。したがって、もし:
model = LogisticRegressionWithLBFGS (LabeldPoint of values)
次のように予測関数を使用して可能性を計算できます。これは1または0です:
model.predict(1,2,3) = 1 or 0.
オッズ
ロジスティック回帰は理解するのが難しいですが、オッズの観点から見ると理解しやすくなります。競馬やサッカーに賭ける人々はそれを理解しているに違いありません。
odds =(probability of successes / probability of failure)
サイコロを振ると、オッズは(1/7)/(6/7)=⅙です。ロジスティック回帰では、結果は0または1です。したがって、オッズは:
odds (y) = p(y=1)/ p(y=0) = p(y=1)/ (1 - p(y=1))
ロジスティック回帰はオッズの対数です。確率は以下のような線形関数から生じることを忘れないでください:
Odds (x) = a1x1 + b1x2 + c1x3 + d
その対数は:
log(Odds (x)) = log(a1x1 + b1x2 + c1x3 + d)
両側をeで上げて元のオッズの式を得ます:
odds(x) = e**(a1x1 + b1x2 + c1x3 + d)
それが見えにくい場合は、心臓病患者の状況を考えてみてください。私たちは、何年にもわたる研究から得られた線形式を持っています。心臓病になる確率は次のような関数です:
(a1 * cholesterol) + (b1 * smoking) + ( c1 + genetic factors) + constant
それは線形方程式です。
サポートベクターマシン
サポートベクターマシン(SVM)では、データポイントのセットを2つの可能な結果のいずれかに割り当てることに関心があります:-1または1。(それがロジスティック回帰と同じだと思うなら、ほぼ正しいでしょう。しかし、いくつかの微妙な違いがあります。)
これはどのように役立つのでしょうか?一例は、癌をその特性に基づいて2つの異なるタイプに分類することです。もう一つは、手書き認識やテキスト感情分析です。つまり、たとえば顧客のコメントがポジティブかネガティブかを尋ねることです。
もちろん、SVMは、aまたはbの2つの結果のいずれかにしか選べない場合はあまり有用ではありません。しかし、ペアワイズ比較を使用してn個の可能な結果の間でデータを分類するように拡張できます。
例として、a、b、c、dの可能な結果がある場合、これら4つの値を3つのステップで確認できます。最初に(a,b)をペアワイズで見て、次に(a,c)、次に(a,d)というふうに。あるいは、(a, (b,c,d))、(b, (a,c,d))などのように1対全体を見ることもできます。
ロジスティック回帰、線形回帰、さらにはニューラルネットワークと同様に、基本的なアプローチは、トレーニングセットxに対してこれらの式mx + b = 1とmx + b = -1を正しくする重み(w)とバイアス(b)を見つけることです。mとxはベクトルであり、m * xは内積m • xです。
たとえば、mが(m1,m2,m3,m4,m5)で、xが(x1,x2,x3,x4,x5)である場合、m •x + bは(m1x1 + m2x2 + m3x3 + m4x4 + m5x5) + bとなります。
線形回帰では、最小二乗誤差アプローチを使用しました。SVMでは、同様のことを行います。ハイパープレーンと呼ばれるものを見つけます。これは、すべてのデータポイントを分離する平面または線を見つけ、そのすべての重みと入力変数がハイパープレーンの一方または他方に配置されるようにします。これにより、データを1つのカテゴリーまたは別のカテゴリーに分類します。
2次元空間では、図は以下のようになります。m • x + b = 0の直線がハイパープレーンです。これは、m • x + b = 1とm • x + b = -1の最大距離を置くように配置され、データを結果1と-1に分けます。
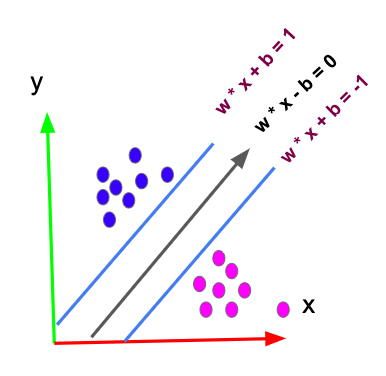
高次元では、点は識別できない塊のように見えます。曲がったハイパープレーンを簡単に見ることはできません。したがって、これらのn次元ポイントを高次元n+1にマッピングし、カーネルと呼ばれる変換関数を使用します。すると、それは再び平坦な2次元空間のように見え、視覚化しやすくなります。次に、それらのポイントの間に直線を描きます。その後、ポイントをn次元の空間に戻してハイパープレーンを見つけます。完了です。
単純に聞こえますか?おそらくそうではありませんが、データを多次元のセットに分けるための機械的なプロセスを提供します。
これらの投稿は私自身の意見であり、必ずしもBMCの立場、戦略、または意見を代表するものではありません。