




ポイント: データオーケストレーションは、DataOpsフレームワーク内でデータワークフローを自動化し管理するために重要であり、運用効率を向上させます。タスクを統合されたパイプラインに接続し、信頼性と障害からの迅速な回復を保証します。
- データオーケストレーションはタスクのスケジューリングと依存関係を自動化します。
- ベストプラクティスには、管理を容易にするためのサブDAGの作成と、ワンクリック回復の有効化が含まれます。
データオーケストレーションは、複雑なパイプライン全体でデータの流れを調整し、自動化するプロセスです—タスクの依存関係を管理し、スケジュールを設定し、障害処理とリカバリをエンドツーエンドで行います。DataOpsフレームワークでは、データオーケストレーションは、断片化したアドホックなデータ操作を信頼できる再現可能なワークフローに変換する基盤的な層です。データオーケストレーションとDataOpsは、データエンジニアリングチームに、スケールでデータ駆動型プラットフォームを構築し維持するために必要な速度、ガバナンス、運用の厳格さを提供します。
なぜ組織はDataOpsを必要とするのか?
すべての組織はデータ駆動型になりたいと考えていますが、その野望と実行との間には大きなギャップがあります。新しい技術は未熟であり、戦闘テストされていません—技術の運用化がデータ駆動型になるための真の道です。
ほとんどのデータチームは「Day 2」を計画していません—製品チームが開発を完了し、プロダクションにデプロイする後の期間です。彼らにはアーティファクトをデプロイするためのエンドツーエンドプロセスがありますか?機能、パフォーマンス、負荷、ストレステストを実行しましたか?問題が発生した場合に、運用変更を元に戻す準備ができていますか?
新興技術を使用したPOCやPOVを実行し、実際のユースケースをプロダクションに正常にデプロイする間の断絶は広く見られます。寄与するほとんどの原因は、データ経済における欠けているコンポーネント:DataOpsによって対処できます。多くの組織はDataOpsを実践していますが、アドホックで断片的な方法であり—ガイドライン、仕様、または正式なプロセスなしに構築されています。
今日のデータインフラストラクチャは—取り込み、ストレージ、処理を含む—分散システム全体にデプロイされています:オンプレミス、パブリックおよびプライベートクラウド、ハイブリッド、エッジ環境。これらの環境は、サーバー、仮想マシン、ネットワーク、メモリ、CPUの複雑な混合であり、障害は避けられません。組織は、根本原因分析を迅速に実行し、平均修復時間(MTTR)を短縮できるツールとプロセスを必要とします。
DataOpsは、データの生成から消費までのすべてのステップでギャップ、非効率性、ミスアラインメントを排除します。それは、開発と運用の調整を共同、構造化、アジャイルな方法で調整し、組織がデータの配信を合理化し、自動化を通じて生産性を向上させ、信頼とガバナンスをもってデータ駆動型アプリケーションをデプロイできるようにします。
DataOpsとは何ですか?
DataOpsは、データプロセスと操作を合理化し自動化して、データ製品やソリューションの構築を加速し、組織がデータ駆動型になるのを支援します。DataOpsの目標は、アドホックなデータプラクティスから、プロセスやタスクを管理するための制御されたフレームワークを持つ正式なデータエンジニアリングアプローチに移行することです。
DataOpsは、パイプラインの開発とプロダクションデプロイメント中に発生する問題を検出、予防、軽減するための正式なプロセスとツールのセットを通じて達成されます。DataOpsは、アジャイルなデータパイプラインを開発するためにCI/CD原則を適用し、データのバージョン管理を通じて再利用性を促進し、データの生産者から消費者への統合を共同で管理します。また、データプラットフォームとサービスの構築、デプロイ、トラブルシューティングのエンドツーエンドの時間とコストを削減します。
分析、AI、およびMLを使用したデジタルトランスフォーメーションに投資している組織にとって、DataOpsはデータ資産を解放し、意思決定を改善するための重要なプラクティスです。DataOpsは、分散化を通じて革新を可能にします—そして、データオーケストレーションとワークフロー自動化プラットフォームは、分散したデータツールを一貫した、ガバナンスされたパイプラインに変えるための中央集権的な調整を提供します。共有インフラストラクチャ全体でのグローバルなオーケストレーションを処理し、ドメイン間の依存関係とポリシーの強制を行います。
なぜ組織はデータオーケストレーションを必要とするのか?
データオーケストレーションは、単一のツールが最新のデータスタックの完全な複雑さを扱うことができないため、必要です。今日のデータエコシステムは、ツール、フレームワーク、およびライブラリの豊かな景観を提供します—一部は明確に定義されたAPIを通じてアクセス可能であり、他はコマンドラインを介して呼び出されます—すべてを繋ぎ合わせてエンドツーエンドのデータ駆動型システムを構築する必要があります。
ほとんどの組織は数本のパイプラインを管理しているのではなく、数十または数百のパイプラインを管理しており、エッジからオンプレミス、複数のクラウドデータセンターにわたる複雑なデプロイモデルがあります。コンポーネントは分散アーキテクチャに基づいて構築された異なるデータセンター全体に実行され、サーバーや仮想マシンに分散されたサブコンポーネントがあります。すべてのハンドシェイクポイントは潜在的な障害ポイントであり、ネットワークの中断からサーバーの障害までです。
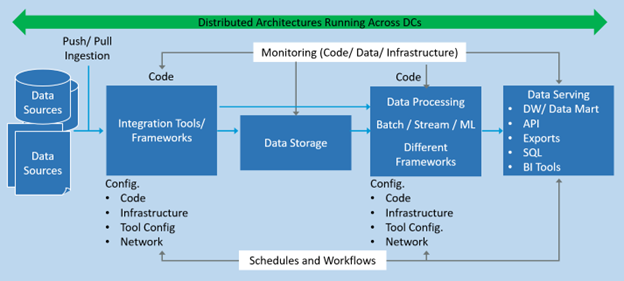
これらのパイプラインを構築する際、データエンジニアはパイプラインコードが意図した通りに実行され、データエンジニアリングのベストプラクティスに従い、ハッピーパスと障害シナリオの両方を処理することを保証する必要があります。目標は、すべてのコンポーネントを調整して、全体のパイプラインが弾力性を持ち、フェイルオーバーをサポートし、障害のポイントから回復できるようにすることです。
プロダクションパイプラインは複雑です—複数のフォーク、依存関係、トリガーロジックがあり、すべてオーケストレーターのスケジューリングおよびワークフローエンジンによって管理されます。データオーケストレーションは、複数のステークホルダー間でワークフローを制御および調整し、実行履歴を追跡し、ジョブをトリガーし、タスクの依存関係を強制し、トラブルシューティングのために完全な監査トレースでアクションを記録します。データエンジニアやデータサイエンティストから要求される主な機能には、使いやすさ、監視、強力なパイプラインの可観測性が含まれます—すべては適切に実装されたデータオーケストレーションレイヤーによって提供されます。
データオーケストレーションとは何ですか?
データオーケストレーションは、データスタック全体でタスクを接続する接着剤です。それは依存関係を管理し、定義されたワークフロー内のタスクを調整し、実行をスケジュールし、出力を管理し、障害シナリオを処理します。オーケストレーションプロセスは、オーケストレーションルールとビジネスロジックに従ってデータの流れを支配し、各データフローに関連するワークフローをスケジュールおよび実行します。
このフローストラクチャは、依存関係グラフとして表され、DAG(有向非循環グラフ)とも呼ばれます。データオーケストレーションは、タスクを論理的なステップのチェーンに接続して、適切に調整されたエンドツーエンドのデータパイプラインを形成するプロセスです。
データオーケストレーターは、タスク駆動型とデータ駆動型の2種類に分類されます。タスク駆動型オーケストレーターは、各ステップに入るまたは出るデータを認識せずに、ワークフローの実行順序にのみ焦点を当てます。データ駆動型オーケストレーターはさらに進みます—タスク間のデータの流れに気付き、アーティファクトの出力をバージョン管理し、自動テストと関連付けることができます。
優れたデータオーケストレーターは、データチームがエラーや障害を迅速に特定できるようにします。データオーケストレーターは、時間ベースのスケジュールまたはカスタム定義されたイベントロジックによってトリガーされる可能性があり、データドメインによって必要とされるインフラストラクチャは、DataOpsフレームワークを通じて管理されるセルフサービスのインフラストラクチャとして統一できます。
データオーケストレーションのベストプラクティスは?
データオーケストレーションは、ポータビリティを確保するために構成駆動型であるべきです—これは、アプリケーションとデータパイプラインスタック全体にまたがるより広範なワークフローオーケストレーションプラットフォームのコア原則でもあります。
効果的なデータオーケストレーションには、意図的な設計判断が必要です。以下のプラクティスは、パイプラインの弾力性、ポータビリティ、回復能力を向上させます。
DAGをサブDAGに分解する
複雑な依存関係グラフをできるだけ簡素なサブDAGに分解します。小さく、焦点を絞ったサブDAGは、テストしやすく、考えやすく、失敗が発生した場合に独立して再実行しやすくなります。
DAGをフォールトトレラントにする
一つのコンポーネントが壊れた場合、全体のパイプラインを最初から再実行せずに再実行できるように、サブDAGを設計します。
構成駆動型オーケストレーションを使用する
構成駆動型データオーケストレーションは、環境間のポータビリティを保証し、再現性と再生産性をサポートします—開発、ステージング、およびプロダクション全体にわたってパイプラインを管理するチームにとって重要です。
チェックポイントでワンクリック回復を可能にする
データオーケストレーションプロセスには、失敗のポイントからのワンクリック回復をサポートするチェックポイントを含むべきで、失敗したタスクを設定可能なバックオフ戦略を使用して再試行できる能力を備えています。
結論
企業は、データ駆動型意思決定のためのデータプラットフォームを構築する前に、データエンジニアリングとDataOpsの原則を組み込むべきです。これらの相乗効果のある能力は、組織にスケールするために必要なプロセスの正式性と速度を提供し、長期的にはデータと技術的負債を削減します。データオーケストレーションはオプションのレイヤーではありません—それはプロダクショングレードのDataOpsが構築されているコアピラーです。
よくある質問
データオーケストレーションとデータ統合の違いは何ですか?
データ統合は、複数のソースからデータを統合して統一されたビューを作成するプロセスです。データオーケストレーションは、全体のデータパイプラインにわたってスケジュール、シーケンス、依存関係の強制、障害処理、回復を管理する広範なワークフローを管理します。データ統合タスクは通常、より大きなデータオーケストレーションワークフロー内のステップとして実行されます。
データオーケストレーションにおけるDAGとは何ですか?
DAG、または有向非循環グラフは、データオーケストレーションでパイプラインタスク間の関係を表すために使用される依存関係構造です。DAGの各ノードはタスクであり、各エッジはタスク間の依存関係を定義します。「非循環」という特性は、循環依存関係が存在しないことを意味し、パイプラインを予測可能でデバッグしやすくします。
タスク駆動型とデータ駆動型オーケストレーションの違いは何ですか?
タスク駆動型オーケストレーターは、ステップ間のデータの流れを意識せずにワークフローの実行順序を管理します。データ駆動型オーケストレーターは、各ステージでのデータおよびアーティファクト出力を認識しており—バージョン管理、自動テスト、パイプライン全体の強力なデータライン追跡を可能にします。
データオーケストレーションはどのようにDataOpsフレームワークをサポートしますか?
データオーケストレーションは、DataOpsフレームワークの運用コアです。パイプラインの実行を自動化し、タスクの依存関係を強制し、回復ロジックで失敗を処理し、ガバナンスのための完全な監査トレースを提供します。データオーケストレーションがなければ、DataOpsプラクティスはアドホックなままであり、複雑なマルチ環境データインフラ全体でスケールするのは困難です。
データオーケストレーションワークフローは何がトリガーしますか?
データオーケストレーションワークフローは、主に2つの方法でトリガーされます:時間ベースのスケジュール(例えば、毎時または毎晩のバッチジョブ)またはカスタムイベントベースのロジック(例えば、新しいデータファイルが到着したり、上流のパイプラインが完了したとき)。ほとんどのエンタープライズオーケストレーターは、単一のパイプライン構成内で両方のトリガータイプをサポートしています。
この投稿に表現された見解や意見は、著者のものであり、必ずしもBMCの公式な立場を反映するものではありません。
これらの投稿は私自身の見解であり、必ずしもBMCの立場、戦略、または意見を反映するものではありません。