




ポイント: データマスキングは、機密情報を隠しながらその使いやすさを保つセキュリティ技術であり、GDPRのような規制に準拠するために重要です。技術には、静的および動的マスキング、暗号化、置換が含まれ、データ保護の特定のニーズに対応します。
- データマスキングは機密情報を保護し、無許可のアクセスを防ぎます。
- 組織はデータセキュリティを確保するために効果的なマスキングのベストプラクティスを採用することが重要です。
データ侵害は、毎年何百万もの人々の機密データをさらし、多くのビジネス組織が何百万ドルも失う原因となります。実際、2024年には、データ侵害の平均コストは$4.88百万でした。個人識別情報 (PII)は、すべての侵害されたデータタイプの中で最も高価なデータタイプです。そのため、データ保護は多くの組織の最優先事項となっています。これが、データマスキングが多くの企業にとって機密データを保護するための不可欠な技術となった理由です。
データマスキングとは何ですか?
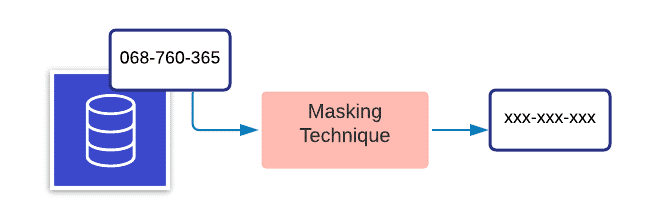
データマスキング、またはデータの曖昧化は、実際のデータを文字や数字のような修正された内容を使用して隠します。データマスキングの主な目的は、容易に同定できず、逆算されない代替データを作成することであり、機密として分類されたデータを保護します。重要なのは、データは複数のデータベース間で一貫性が保たれ、使いやすさは変更されないことです。マスキングを使用して保護できるデータの種類は多岐にわたりますが、データマスキングに適した一般的なデータタイプは以下の通りです:
- PII: 個人識別情報
- PHI: 保護された健康情報
- PCI-DSS: 支払いカード情報
- ITAR: 知的財産
データマスキングは一般的に、ソフトウェア開発やテスト、ユーザートレーニングなどの非生産環境に適用されます。実際のデータを必要としない領域です。マスキングにはさまざまな技術を使用できますが、この記事の次のセクションで説明します。(私たちのビッグデータおよびデータセキュリティの解説をチェックしてください。)
データマスキングの重要性
データマスキングは、企業にとっていくつかの方法で重要です:
- 機密データの露出リスクを排除することにより、一般データ保護規則 (GDPR) に準拠するのに役立ちます。これにより、データマスキングは多くの組織に競争上の優位性を提供します。
- サイバー攻撃者にとってデータを無意味にしつつ、その使いやすさと一貫性を保持します。
- 統合されたサードパーティアプリケーションとのデータ共有やクラウド移行に関連するリスクを軽減します。
- 外注プロジェクトに関連するリスクを回避します。ほとんどの組織は外注者と取引する際に単に信頼に依存するため、マスキングはデータが悪用されたり盗まれたりするのを防ぎます。
データマスキングの種類
使用ケースに応じて使用できるデータマスキングの種類はいくつかあります。その中でも、静的およびオンザフライのデータマスキングが最も一般的です。
静的データマスキング (SDM)
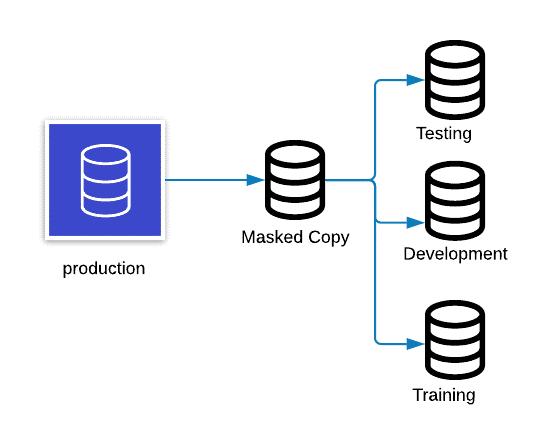
静的データマスキングは一般的に、生産データベースのコピーで機能します。SDMは、実際のデータを明らかにすることなく、正確に見えるようにデータを変更し、開発、テスト、トレーニングを正確に行います。プロセスは次のように進みます:
- 生産データベースのバックアップまたはゴールデンコピーを別の環境に取ります。
- 不要なデータを削除し、静止状態のままマスキングします。
- マスクされたコピーを希望の場所に保存します。
動的データマスキング (DDM)
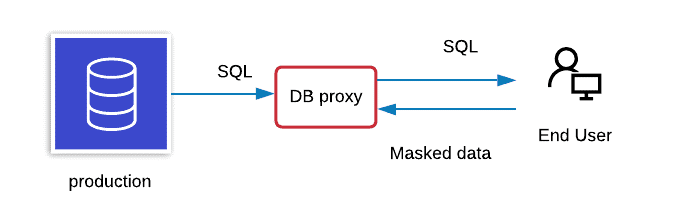
DDMは、実行時に動的に発生し、データを生産システムから直接ストリーミングします。そのため、マスクされたデータは別のデータベースに保存する必要はありません。主に、顧客の問い合わせの処理や医療記録の処理など、アプリケーションの役割ベースのセキュリティを処理するために使用されます。したがって、DDMはマスクされたデータが生産システムに書き戻されないように、読み取り専用のシナリオに適用されます。データベースプロキシを使用して、元のデータベースに来るクエリを変更し、要求者にマスクされたデータを渡すことができます。DDMを使用すると、事前にマスクされたデータベースを準備する必要はありませんが、アプリケーションにはパフォーマンスに対する障害がある可能性があります。
決定論的データマスキング
決定論的データマスキングは、列データを同じ値に置き換えることを含みます。たとえば、データベースに複数のテーブルがあるファーストネームの列がある場合、ファーストネームが含まれる多くのテーブルがある可能性があります。'Adam'を'James'にマスクすると、マスクされたテーブルだけでなく、すべての関連テーブルでも'James'として表示されるべきです。マスキングを実行するたびに、同じ結果が得られます。
オンザフライデータマスキング
オンザフライデータマスキングは、生産環境から別の環境(テストまたは開発など)にデータが転送される際に発生します。オンザフライデータマスキングは、次のような組織に理想的です:
- ソフトウェアを継続的に展開する
- 重い統合を持つ
マスクされたデータのバックアップコピーを継続的に保つことが難しいため、このプロセスでは、必要に応じてマスクされたデータのサブセットのみを送信します。
統計データの曖昧化
生産データはさまざまな統計情報を保持する可能性があり、統計データの曖昧化技術によって擬装することができます。差分プライバシーは、データセット内の実際の個人情報を明らかにすることなく、データセットのパターンに関する情報を共有できる技術の一つです。
データマスキング技術
次に、データマスキングの技術を見てみましょう。
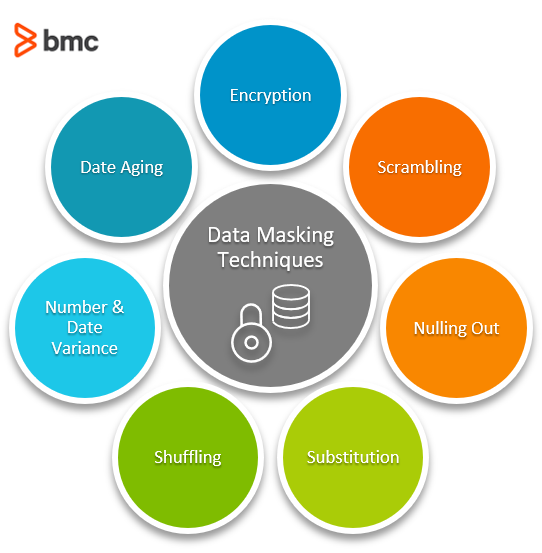
暗号化
暗号化は、最も複雑で最も安全なデータマスキングの種類です。ここでは、データをマスキングし、データを復号化するためにキー(暗号化キー)が必要な暗号化アルゴリズムを使用します。暗号化は、元の状態に戻す必要がある生産データにより適しています。ただし、データは、認可されたユーザーのみがキーを持っている限り安全です。無許可の当事者が侵入すると、キーを使用してデータを復号化し、実際のデータを見ることができます。したがって、暗号化キーの適切な管理が重要です。
スクランブル
スクランブルは、元のコンテンツを隠すために文字や数字をランダムな順序に混ぜる基本的なマスキング技術です。この技術は実装が簡単ですが、特定のデータタイプにのみ適用でき、機密データを期待通りに安全にすることはできません。たとえば、生産環境でID番号934587の従業員が文字スクランブルを経ると、他の環境では489357として表示されます。元の順序を記憶している人は、元の値を解読できる可能性があります。
ヌリング
ヌリングは、データ列にヌル値を適用することでデータをマスキングし、無許可のユーザーがその実際のデータを見られないようにします。これはもう一つの簡単な技術ですが、主な問題は以下の通りです:
- データの整合性を低下させる
- そのようなデータを使用したテストや開発を困難にする
置換
置換は、データを別の値に置き換えることでマスキングすることです。これは、データの元の外観を保持しながら、最も効果的なデータマスキング方法の一つです。置換技術は、さまざまなデータタイプに適用できます。たとえば、顧客名をランダムなルックアップファイルでマスキングすることができます。これは実行が非常に難しい場合がありますが、データの侵害から保護する非常に効果的な方法です。
シャッフル
シャッフルは置換に似ていますが、同じ個人のマスキングデータ列をランダムにシャッフルするために使用します。たとえば、複数の従業員記録の従業員名の列をシャッフルします。出力データは正確なデータのように見えますが、実際の個人情報は明らかにしません。ただし、誰かがシャッフルアルゴリズムを知っている場合、シャッフルされたデータは逆計算される危険があります。
数値および日付の変動
数値および日付の変動方法は、重要な財務および取引日付情報をマスキングするために適用されます。たとえば、従業員の給与列を従業員の給与変動でマスキングすると、最高額と最低額の給与の間の給与が表示されます。データセットの意味を保つために、すべての給与に±10%の変動を適用できます。
日付のエイジング
このマスキング技術は、定義されたデータマスキングポリシーに基づいて、許容可能な日付範囲内で日付フィールドを増加または減少させます。たとえば、生年月日フィールドの日付を1000日減少させると、日付'2021年1月1日'が'2018年4月7日'に変わります。
データマスキングの例
以下の例は、データマスキングのさまざまな技術がどのように機能するかを示しています:
- 金融サービスにおける顧客データマスキング:他者と共有する際に、顧客のクレジットカード番号、社会保障番号、その他の機密データを保護する必要があります。クレジットカード番号4111-1234-5678-9012は、4111-XXXX-XXXX-9012のようにマスキングできます。
- 医療における患者データのプライバシー:HIPAAのようなさまざまな規制や、医療サイバーセキュリティおよび回復力法のセクション405(d)のようなフレームワークは、患者情報を保護することを要求します。データをマスキングすれば、まだ使用できます。たとえば、2001年5月15日生まれの「ジョン・ウィンストン」という患者は、「患者1234」としてマスキングされ、「05/XX/2001」として生まれます。
- HR分析のための従業員給与の匿名化:組織は給与トレンドを分析したいが、個々の従業員のプライバシーを維持したいと考えるかもしれません。従業員の名前を「Emp 001」のような番号でマスキングし、その識別子に給与を関連付けることができます。
- eコマースのソフトウェアテストにおけるデータマスキング:現実的なデータでシステムをテストすることは役立ちますが、実際の顧客データを安全に保つ必要があります。出荷先住所のようなものを「123 テストストリート、テストシティ、TS、99999」とマスキングできます。
データマスキングのベストプラクティス
データマスキングを開始する準備はできていますか?以下は従うべきベストプラクティスです。
機密データを特定する
データをマスキングする前に、次の情報を特定してカタログ化します:
- 機密データの場所
- それを表示できる権限のある人
- それらの使用
企業のすべてのデータ要素がマスキングを必要とするわけではありません。代わりに、生産および非生産環境の既存の機密データを徹底的に特定します。データの複雑さや組織構造によっては、これに相当な時間がかかる場合があります。
データマスキング技術のスタックを定義する
大規模な組織が全体で単一のマスキングツールを使用するのは実用的ではなく、データは大きく異なるため、選択した技術は特定の内部セキュリティポリシーに準拠する必要がある場合や予算要件を満たす必要がある場合があります。場合によっては、マスキング技術を開発する必要があります。したがって、必要な要因をすべて考慮して、適切な技術のセットを選択してください。同じデータタイプが同じ技術を使用するように、一貫性を保つことが重要です。
データマスキング技術を保護する
マスキング技術と関連データは、機密データと同様に重要です。たとえば、置換技術は、置換のためのルックアップファイルを使用できます。このルックアップファイルが誤って手に渡ると、元のデータセットが明らかになります。組織は、マスキングアルゴリズムにアクセスできるのは認可された人のみであるという必要なガイドラインを確立すべきです。
マスキングを再現可能にする
時間が経つにつれて、組織や特定のプロジェクトや製品の変化により、データに変更が生じる可能性があります。毎回ゼロから始めることを避けてください。代わりに、マスキングを再現可能で迅速かつ自動なプロセスにして、機密データに変更が生じたときにそれを実装できるようにします。
エンドツーエンドのデータマスキングプロセスを定義する
組織は、以下を含むエンドツーエンドのプロセスを持つ必要があります:
- 機密情報の特定
- 適切なデータマスキング技術の適用
- データマスキングが期待通りに機能していることを保証するための継続的な監査
データマスキングは不可欠
データマスキングは、機密データの真正性を隠すことによって保護する多くの組織にとって不可欠なプロセスです。
関連するリーディング
- BMC機械学習およびビッグデータブログ
- 企業のためのデータ倫理
- AIサイバー攻撃とその仕組みの説明
- 企業セキュリティのためのパスワードのソルトとストレッチ
- 7つのビジネスクリティカルなITポリシーとその実装方法
- ITベストプラクティス:最良の導入
これらの投稿は私自身のものであり、必ずしもBMCの立場、戦略、または意見を表すものではありません。