ご要望またはご協力できることがございましたらお気軽にお問い合わせください
一般的なお問い合わせと所在地情報
お問い合わせ

 Control-M + Spark
あなたのスパークワークフローは、PySparkスクリプトやJava/Scalaアプリケーションが実行される前に始まり、上流で何かが壊れると失敗する可能性があります。HDFSパーティションが遅れて到着したり、予想サイズを下回ったりすることがあります。Hive変換が処理ウィンドウを逃すことがあります。Control-Mは、HDFSファイル到着、Hive変換、スパーク実行、Snowflakeデリバリーの完全なチェーンを調整します。
一般的なワークフローの問題
これはあなたの週のようですか?
これはエッジケースではありません。これらは、複数のツールでSparkジョブを実行しているチームの通常の運用条件です。Control-Mが各ケースをどのように処理するかを示します。
遅延データ
あなたのHDFSパーティションは遅れています。午前2時のSparkジョブは準備ができています。
Control-Mは、Sparkジョブをリリースする前に必要なHDFSファイルと最小サイズを監視します。到着条件が定義されたウィンドウ内で満たされない場合、ウォッチャーは不完全なデータに対して処理を開始するのではなく、失敗します。
ジョブの失敗
あなたのspark-submitが失敗しました。3つの下流ジョブがその出力を待っています。
Control-MはSparkジョブをエンドツーエンドのワークフローの一部として追跡し、失敗後に依存するジョブが進行するのを防ぎ、定義された回復アクションを適用して不完全な処理が下流の配信に波及しないようにします。
AIRFLOW · SPARK
あなたのAirflow DAGは完了しました。Sparkのワークロードはまだ開始されていません。
Control-MはAirflow DAGとSpark処理の間の依存関係を調整し、上流の条件が満たされて初めてSparkジョブをリリースします — 切り離されたスケジュールやオーケストレーションレイヤー間の手動ハンドオフに依存することなく。
HDFS準備
あなたのSparkコードは健全です。HDFS準備コマンドが失敗しました。
Control-MはSpark実行の前後にHDFSコマンドを実行し、コマンドの失敗がジョブを失敗させるべきかどうかを判断できます。準備とクリーンアップは、隠れたスクリプト依存関係ではなく、ワークフローの管理された部分になります。
SLAリスク
Sparkはまだ処理中です。あなたの下流の分析の締切が近づいています。
Control-Mは完全なビジネスサービス内でSparkワークロードを追跡し、依存するジョブにわたってSLA監視を適用し、エンドツーエンドのワークフローが必要な完了時間を逃す前に遅延を浮き彫りにします。
Control-M + Spark
Control-M + Spark
|
workload.types |
PySparkスクリプト · Javaアプリケーション · Scalaアプリケーション · スパークアプリケーションJAR · アプリケーション引数 · スパークコマンドラインオプション |
|
trigger.type |
HDFSファイル到着 · 最小ファイルサイズ · 上流ジョブの完了 · 時間スケジュール · ワークフロー依存関係 · Control-Mイベント |
|
cross_tool.deps |
Apache Airflow DAG · Hiveジョブ · HDFSコマンド · Snowflakeジョブ · Databricksジョブ · GCP Dataproc · 下流ファイルデリバリー |
|
cloud.platforms |
Hadoop/YARNクラスタ · オンプレミスおよびクラウドホストのHadoop · GCP Dataproc、Azure HDInsight、Amazon EMR、OCI Data Flowのための別々のControl-M統合と一緒に実行 |
|
error_handling |
事前コマンドの失敗処理 · 事後コマンドの失敗処理 · 依存関係ゲーティング · 再実行アクション · 下流カスケード防止 · SLAアラート |
|
throughput |
分散データ処理 · クラスター規模のワークロード · バッチスパークアプリケーション · ジョブレベルのオーケストレーション · レコードごとのワークフローのスケジューリングなし |
|
observability |
ジョブステータス · ジョブ出力 · YARNの集約ログ · ワークフロー依存関係 · SLA監視 · エンドツーエンドのワークフローの可視性 |
エンドツーエンドオーケストレーション
1つのプロダクションワークフロー。スタック内のすべてのツール。
Control-Mは、スパーク、Airflow、HDFS、Hive、Snowflake、ファイル転送、およびクラウドサービス全体でワークフローを調整し、依存関係追跡、SLA可視性、および自動リカバリーを全てのジョブフローで提供します。
- クロスツール依存関係: HDFS → Hive → Spark → Snowflake、1つのフローで別々のControl-Mジョブタイプにわたって調整
- データ意識のトリガー: ファイル到着、APIイベント、Airflow完了、上流ジョブ結果
|
スパーク |
PySpark実行 · Java/Scalaアプリケーション · 引数 · コマンドラインオプション · ジョブ監視 |
|
HDFS |
ファイル監視 · 最小サイズ基準 · コマンド · 準備 · クリーンアップ |
|
Hive |
スクリプト実行 · パラメーター · 依存関係調整 · ジョブ監視 |
|
Apache Airflow |
DAGトリガー · ステータス監視 · ツール間依存関係調整 |
|
Snowflake |
SQL実行 · データロード · ストアドプロシージャ · 下流ワークフロー調整 |
|
GCP Dataproc |
Sparkバッチ、ワークフローテンプレート、サーバーレスSparkバッチ |
|
Azure HDInsight |
Sparkバッチ実行、アプリケーションパラメーター、Sparkログ |
airflowの共存
Control-MはあなたのAirflow DAGを置き換えません。それはその上のレイヤーを実行します。
反対意見は一般的です: “私たちはすでにAirflowを使用しています。” 問題はAirflowが何をするかではなく、Airflowが実行される前後に何が起こるかです。そこがパイプラインが実際に失敗する場所です。
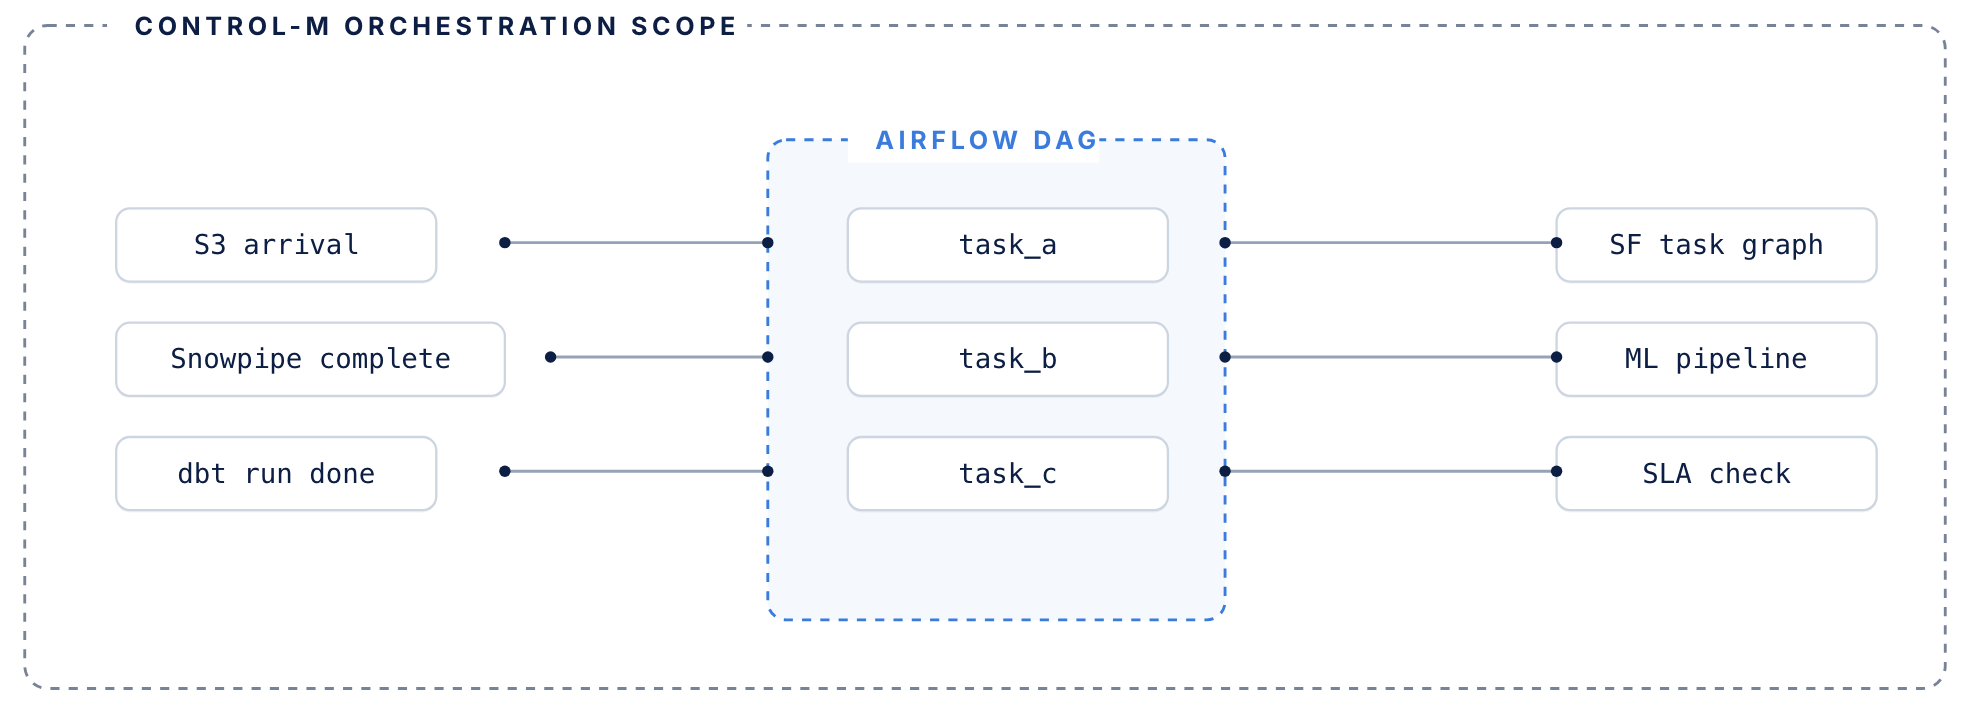
AirflowはそのDAGを管理します。Control-Mはその周りのすべてを管理します。
airflowが処理します
データパイプライン内のDAGレベルのオーケストレーション
- DAGレベルのタスクオーケストレーションをデータパイプライン内で
- Pythonオペレーター、センサー、タスク依存関係
- パイプライン内で実行されるジョブの実行グラフ
- 単一のDAGコンテキスト内での再試行を管理
control-mが追加します
DAGの周りの調整レイヤー
- DAGの周りの調整レイヤー — 上流の条件(ファイルの到着、APIイベント、他のツールの完了)に基づいてAirflowをトリガーします
- 各DAGのSLA貢献を、単独のルーチンだけでなく、完全なエンドツーエンドのワークフロー全体にわたって追跡します
- Airflowが開始する前に上流の依存関係が失敗した場合に失敗回復を管理します
- 既存のDAGは再作成または移行する必要はありません
パイプラインを監視する
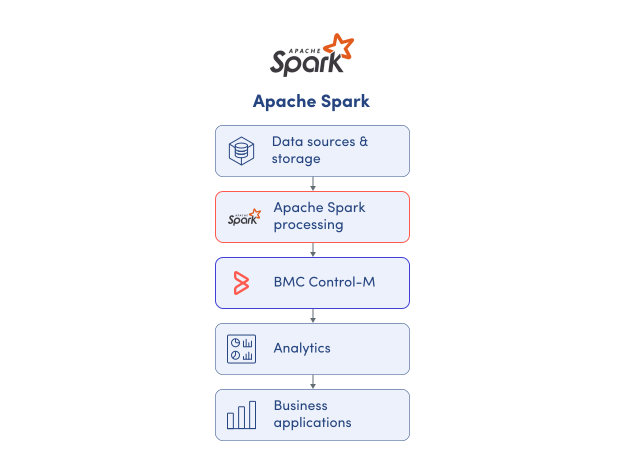
完全なデータパイプライン内でSpark実行を監視します。
Sparkはアプリケーション内で何が起こるかを示します。プロダクションパイプラインは通常、ストレージ、変換、オーケストレーション、デリバリーシステムにまたがります。Control-MはデータチームにSparkのジョブと依存関係の周囲を1つの運用ビューを提供します:
-
Sparkジョブ実行ステータス
-
上流および下流の依存関係
-
ジョブ出力とログ
-
エンドツーエンドワークフローの可視性
-
障害と回復ステータス
SLA保証
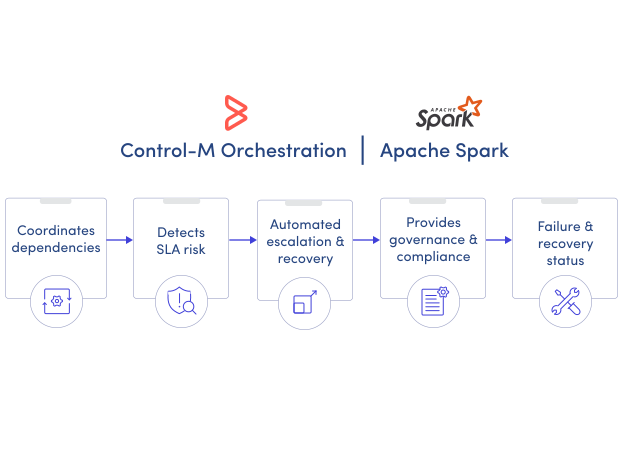
期限に間に合わせてSparkを管理する。
成功したSparkアプリケーションも、依存しているビジネスプロセスにとっては遅すぎる場合があります。Control-MはSpark実行をエンドツーエンドのサービスSLAに接続し、チームが遅延を特定し、納品が遅れる前に依存関係を管理できるように支援します:
-
エンドツーエンドSLAトラッキング
-
必要な完了時間
-
依存関係に配慮したワークフローモニタリング
-
遅延と障害の可視性
-
調整された回復アクション
複雑なワークフローに秩序をもたらす
Control-Mがチームにどのように複雑なプロセスを可視化、調整、制御してオーケストレーションするかを学びます。
