ご要望またはご協力できることがございましたらお気軽にお問い合わせください
一般的なお問い合わせと所在地情報
お問い合わせ

 Control-M + ハイブ
あなたのHiveワークフローは、Beelineジョブが実行される前に始まり、上流の何かが壊れると失敗する可能性があります。HDFSファイルがHDFSファイルウォッチャーによって期待されているにもかかわらず到着しません。Sqoopインポートが遅れて終了し、Hiveの読み込みが待機します。Control-Mは、HDFSデータの到着、Sqoopの取り込み、Hiveの実行、下流の分析配信の完全なチェーンを調整します。
一般的なワークフローの問題
これがあなたの週のように聞こえますか?
HDFSデータ到着
あなたの午前2時のHiveロードが開始されました。HDFS入力は決して到着しませんでした。
Control-MはHiveジョブをHDFSファイルウォッチャーに依存させることができるので、実行は必要なデータを待ち、固定の開始時間に依存しません。上流のファイル条件が満たされてからクエリが開始されます。
SQOOP · HIVE
あなたのSqoopインポートは遅れて終了しました。Hiveスクリプトはすでに期限切れです。
Control-MはSqoopとHiveジョブを同じスケジューリング環境に配置し、Hiveステップをリリースする前に上流ジョブの完了を評価し、取り込みが遅れたときに依存関係のチェーンを維持します — 脆弱な時間ベースの調整を避けるためです。
クエリ失敗
Beelineはエラーを返しました。あなたの下流の分析ジョブは実行されてはいけません。
Control-Mはワークフローの一部としてHiveジョブを監視し、前提条件が失敗した場合、依存する処理が進むのを防ぎます。オペレーターは、失敗したHive実行が下流の処理に波及するのを許可する代わりに、中央で回復を管理できます。
SLAリスク
Hiveはまだ実行中です。あなたの朝の分析配信はそのSLAに近づいています。
Control-MはHadoopワークロードにSLA管理を追加し、Hiveジョブを大きな生産フローの中で追跡します。チームは遅延や依存関係を可視化し、遅れたクエリが遅れたビジネスデータの配信を引き起こす前に確認できます。
安全な実行
Hiveワークロードが環境を移動しました。資格情報は別のスクリプトに埋め込まれています。
Control-MはHiveServer2接続のためのHadoop接続プロファイルを使用し、Hiveホスト、Hiveポート、データベース名、Hiveユーザー、パスワード、Kerberos認証に必要なHiveプリンシパルを含みます。接続の詳細はHiveジョブ定義とは別に保持され、スケジュールされたワークロード全体での資格情報の取り扱いを減らします。
Control-M + ハイブ
Control-M + ハイブ
|
ワークロードタイプ |
Hive Beelineジョブ · Hiveスクリプト実行 · HiveQLクエリ · ETL処理 · データウェアハウスのロード · テーブル/パーティション操作 |
|
トリガータイプ |
HDFSファイル到着 · 上流ジョブの完了 · 時間スケジュール · 複雑な依存関係 · リソースの可用性 · ワークフロー条件 |
|
クロスツール依存関係 |
HDFSファイルウォッチャー · Sqoopジョブ · Sparkジョブ · MapReduceジョブ · Pigジョブ · Oozieワークフロー · 下流Control-Mジョブ |
|
クラウドプラットフォーム |
Hadoopクラスター(オンプレミスまたはクラウドホスト) · HDFS · HiveServer2 · Linux Control-M/Agent |
|
エラーハンドリング |
ジョブステータスの監視 · 下流依存関係の制御 · 高度なスケジューリング基準 · リソース制御 · SLA管理 · 中央集中的なリカバリー |
|
スループット |
分散Hadoop処理 · 大規模データセット · バッチETL · Hive SQL処理 · 同時HiveServer2ワークロード |
|
可視性 |
中央集中的なジョブ監視 · ワークフロー依存関係の可視性 · SLA追跡 · ジョブ出力 · 実行ステータス · 過去のワークフローレコード |
エンドツーエンドのオーケストレーション
1つのプロダクションワークフロー。スタック内のすべてのツール。
Control-Mは、Hive、HDFS、Sqoop、Sparkをまたいでワークフローを調整します。さらに、Airflowやマネージドファイル転送などの隣接ツールを単一のジョブフローで、依存関係の追跡、SLAの可視性、すべての自動回復を提供します。
- クロスツール依存関係: HDFS到着 → Sqoopインポート → Hiveクエリ → Spark分析
- データ認識トリガー: HDFSファイル到着、上流ジョブ完了、APIイベント、クエリ完了
|
ハイブ |
Beelineジョブの実行 · Hiveスクリプト実行 · 接続プロファイル · 依存関係管理 |
|
HDFS |
ファイル到着監視(HDFSファイルウォッチャー) · HDFSコマンド · 上流データ依存関係の制御 |
|
Sqoop |
インポート/エクスポート調整 · 依存関係の順序付け · ジョブ監視 |
|
Spark |
Pythonのジョブ · Scala/Javaのジョブ · 複数ジョブの依存関係 |
|
Airflow |
DAGの実行 · ステータスの監視 · エンタープライズのワークフロー依存関係 |
|
マネージドファイル転送 |
ファイルの移動 · ファイル到着の依存関係 · セキュアな転送のオーケストレーション |
airflow共存
Control-MはあなたのAirflow DAGを置き換えません。それはそれらの上のレイヤーを実行します。

AirflowはそのDAGを管理します。Control-Mはそれを取り巻くすべてを管理します。
airflowが処理する
データパイプライン内のDAGレベルのオーケストレーション
- データパイプライン内のDAGレベルのタスクオーケストレーション
- Pythonオペレーター、センサー、タスクの依存関係
- パイプライン内で実行されるジョブの実行グラフ
- 単一DAGコンテキスト内でのリトライを管理
control-mを追加
DAGの周りの調整レイヤー
- DAGの周りの調整レイヤー — 上流の条件(ファイル到着、APIイベント、他のツールの完了)に基づいてAirflowをトリガーします。
- 各DAGのSLA貢献を、単独のルーチンだけでなく、エンドツーエンドのワークフロー全体で追跡します。
- Airflowが開始される前に上流の依存関係が失敗した場合の障害回復を管理します。
- 既存のDAGを再記述または移行する必要はありません。
パイプラインを監視する
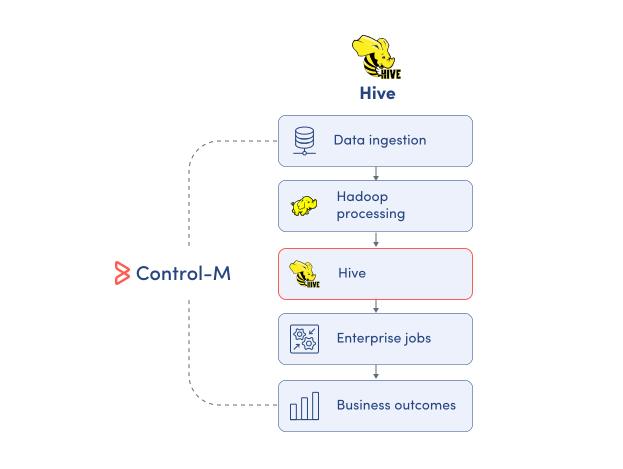
フルデータパイプライン全体でHiveの実行を監視する
HiveServer2はリモートクライアントがクエリを実行し、結果を取得できるようにしますが、プロダクションの配信はしばしばHiveの外の作業に依存しています。Control-MはHiveジョブと周囲のHadoopおよびエンタープライズのステップを集中管理のワークフロー監視に取り込むことで、データチームがコンテキスト内で実行を追跡できるようにします:
-
Hiveジョブの実行ステータス
-
上流および下流の依存関係
-
集中管理のワークフロー監視
-
ジョブの出力と結果
-
エンドツーエンドのパイプライン可視性
SLA保証
Hive依存のデータ配信を予定通りに保つ
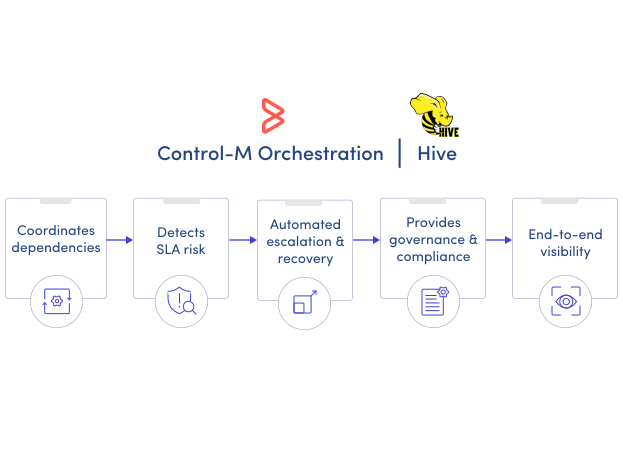
成功したHiveクエリは、エンドツーエンドのデータサービスにおける1つのマイルストーンに過ぎません。Control-Mは、より広範なワークフロー全体にわたるSLA管理を追加し、チームが依存関係や遅延を特定し、予定されたデータ配信にリスクをもたらす要因を特定できるようにします:
-
エンドツーエンドのSLA追跡
-
予測遅延検出
-
複雑な依存関係管理
-
集中管理の障害可視性
-
高度なスケジューリング基準