ご要望またはご協力できることがございましたらお気軽にお問い合わせください
一般的なお問い合わせと所在地情報
お問い合わせ

 Control-M + Hadoop MapReduce
あなたの Hadoop MapReduce ワークフローは、プログラム JAR が実行される前に始まります — そして、上流で何かが壊れると失敗する可能性があります。未完成の HDFS 入力ファイル。遅れて完了する Sqoop インポート。Control-M は、HDFS データの到着、Sqoop の取り込み、MapReduce の実行、そして下流の Hive 処理を調整します。
一般的なワークフローの問題
これがあなたの週のように聞こえますか?
これはエッジケースではありません。複数のツールで Hadoop MapReduce ジョブを実行しているチームのための通常の運用条件です。Control-M がそれぞれをどのように処理するかは以下の通りです。
入力準備
あなたの午前2時の MapReduce ジョブが開始されました。HDFS 入力はまだ到着していません。
Control-M HDFS File Watcher は、必要なファイルと最小ファイルサイズを待機し、成功する前に完了します。MapReduce ジョブはそのイベントに依存したまま、欠落しているか不完全な入力データに対しての早期実行を防止できます。
失敗回復
MapReduce ジョブは失敗しました。あなたの下流の Hive 処理はまだ待っています。
Control-M は MapReduce と下流の Hadoop ジョブを同じ依存関係チェーンに配置します。処理の失敗は、定義された回復条件が満たされるまで、依存するジョブがリリースされるのを防ぎ、失敗を悪データが下流に伝播するのを抑制します。
パイプラインのタイミング
Sqoop は早期に完了しました。MapReduce はまだそのスケジュールされた開始時間を待っています。
Control-M は、ワークフロー依存関係を介して Sqoop と MapReduce を調整します。上流のジョブが完了条件を満たすと、別の固定時間スケジューリングウィンドウを待つことなく、処理は MapReduce ステージに移行できます。
HDFS 準備
昨日の HDFS 出力が残っています。今夜の MapReduce 実行は安全に開始できません。
Control-M は MapReduce 実行の周囲に HDFS の前後コマンドをサポートし、準備とクリーンアップを行います。構成可能なコマンド失敗処理は、失敗したコマンドがジョブを停止するかどうかを決定し、チームに不安全な実行条件に対する明示的な制御を提供します。
SLA リスク
MapReduce が長時間実行されています。あなたの朝の分析配信は今や危険にさらされています。
Control-M は Hadoop ワークロードに SLA ジョブを添付し、より広い依存関係チェーン内で MapReduce を管理できます。データチームは、孤立したクラスターのジョブを監視するのではなく、エンドツーエンドのワークフローの一部としてスケジュールに敏感な処理を追跡できます。
Control-M + Hadoop MapReduce
Control-M + Hadoop MapReduce
|
workload.types |
Java MapReduce · MapReduce ストリーミング · HDFS コマンド · HDFS ファイルウォッチャー · Hive · Pig · Sqoop · Spark · DistCp · Oozie · Impala · Distributed Shell · Tajo |
|
trigger.type |
HDFS ファイル到着 · 最小ファイルサイズ · 時間スケジュール · 上流ジョブの完了 · Control-M 依存条件 |
|
cross_tool.deps |
HDFS ファイルウォッチャー · Sqoop · Hive · Pig · Spark · Oozie · DistCp · Impala · Distributed Shell · Tajo · 企業 Control-M ジョブ |
|
cloud.platforms |
セルフ管理型 Hadoop クラスター · Linux 実行ホスト · オンプレミス環境 · ハイブリッド企業ワークフロー(管理されたクラウド Hadoop については、Azure HDInsight および AWS EMR 統合を参照) |
|
error_handling |
前コマンド失敗処理 · 後コマンド失敗処理 · 依存制御 · HDFS ファイルウォッチャータイムアウト · SLA ジョブモニタリング |
|
throughput |
分散大規模データ処理 · クラスターに基づく実行 · 並列 MapReduce ワークロード · 高ボリュームバッチ処理 |
|
observability |
集中型 Hadoop ジョブモニタリング · ワークフロー依存関係の可視性 · SLA ジョブトラッキング · Control-M モニタリングドメイン |
エンドツーエンドのオーケストレーション
1つの生産ワークフロー。スタック内のすべてのツール。
Control-M は、Hadoop MapReduce、HDFS、Sqoop、Hive、Spark、Oozie、およびファイル転送を単一のジョブフローで調整します — すべての依存関係の追跡、SLA の可視性、そして自動リカバリを備えています。
- クロスツール依存関係: HDFS ファイル → Sqoop → Hadoop MapReduce → Hive → 分析ハンドオフ
- データ認識トリガー: HDFS ファイル到着、上流の完了、ファイルサイズ基準、処理結果
|
Hadoop MapReduce |
プログラム JAR 実行 · メインクラスと引数 · HDFS 前/後コマンド · 依存オーケストレーション |
|
HDFS |
ファイル到着検出 · 最小サイズ基準 · HDFSコマンド · 準備とクリーンアップ |
|
Sqoop |
インポート/エクスポートジョブ · ジョブ引数 · HDFS統合 · 依存関係調整 |
|
Hive |
Hiveジョブ実行 · スクリプトとパラメータ · アップストリーム/ダウンストリーム依存関係 |
|
Spark |
Pythonジョブ · Scala/Javaジョブ · Sparkオプション · 依存関係調整 |
|
Oozie |
ワークフロー提出 · ジョブプロパティ · ワークフロー抽出 · 依存関係調整 |
|
DistCp |
分散コピー · ソース/ターゲットパス · 転送オプション · ワークフロー依存関係 |
airflow 共存
Control-M はあなたの Airflow DAG を置き換えません。それはその上にあるレイヤーを実行します。
一般的な異議: 「私たちはすでに Airflow を使用しています。」問題は Airflow が何をするかではなく、Airflow が実行される前後に何が起こるかです。パイプラインが実際に失敗するのはその部分です。
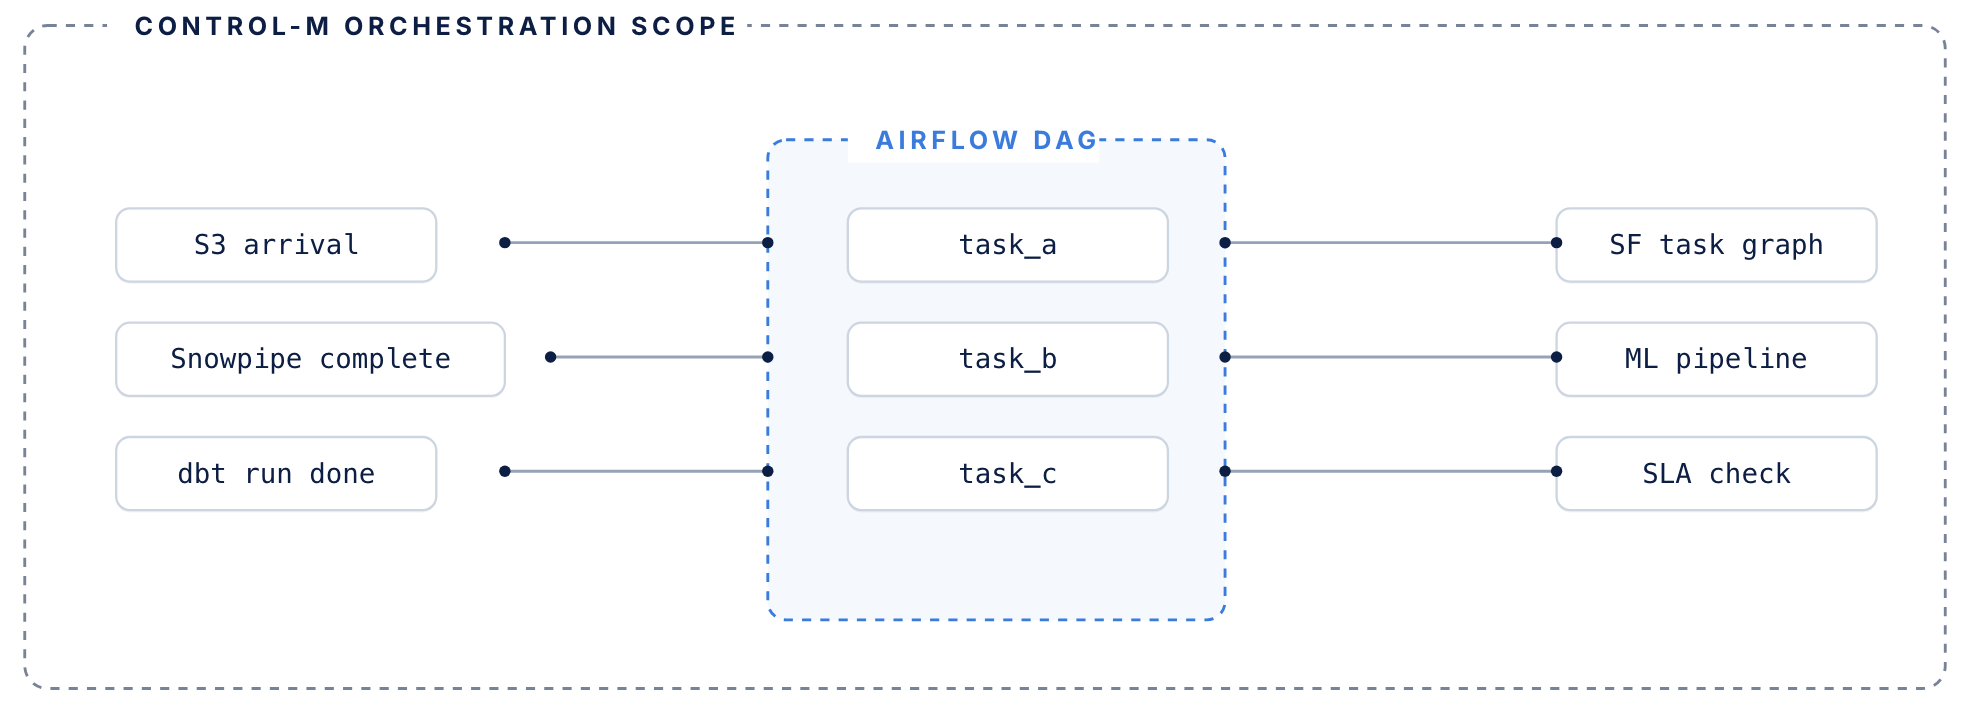
Airflow はその DAG を管理します。Control-M はそれを取り巻くすべてを管理します。
airflow は処理します
データパイプライン内の DAG レベルのオーケストレーション
- DAG レベルのタスクオーケストレーションデータパイプライン内
- Python オペレーター、センサー、タスク依存関係
- パイプライン内で実行されるジョブの実行グラフ
- 単一 DAG コンテキスト内でのリトライを管理
control-m が追加します
あなたの DAG 周辺のコーディネーションレイヤー
- DAG 周辺のコーディネーションレイヤー — 上流条件に基づいて Airflow をトリガー: ファイル到着、API イベント、他のツールの完了
- 各 DAG の SLA 貢献をフルエンドツーエンドワークフロー全体で追跡します。自分のルーチンだけではありません
- 上流の依存関係が Airflow が開始する前に失敗した場合、失敗の回復を管理します
- 既存の DAG を書き換えたり移行したりする必要はありません
パイプラインの監視
完全なデータパイプラインを通じてHadoop MapReduceジョブを監視
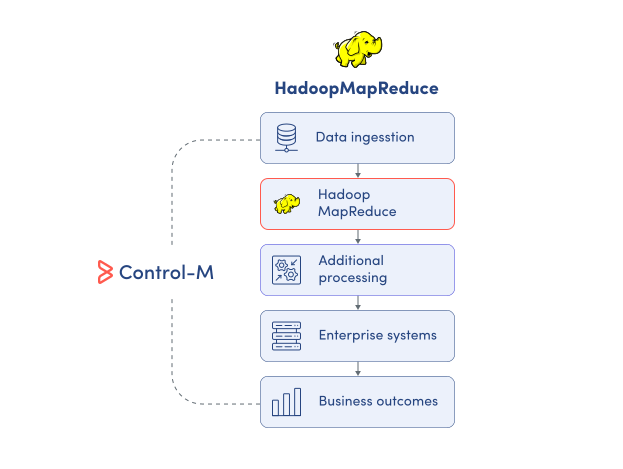
Hadoopはクラスター内での実行を公開しますが、生産パイプラインは単一のMapReduceジョブを超えて拡張します。Control-MはMapReduceと周囲のワークロードを集中管理し、データチームが完全なワークフローのコンテキストで処理を監視できるようにします:
-
MapReduce実行ステータス
-
アップストリームおよびダウンストリーム依存関係
-
クロスプラットフォームワークフローの可視性
-
Hadoopジョブの監視
-
エンドツーエンドの処理ステータス
SLA保証
MapReduce処理を配信SLAに合わせて維持
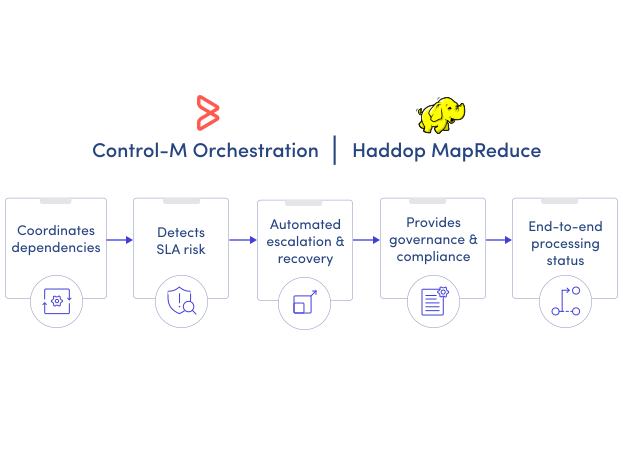
成功したMapReduceジョブは、完全なデータサービスが時間通りに終了することを保証するものではありません。Control-MはHadoop処理をエンタープライズスケジューリング、依存関係、SLA管理に接続し、チームがフルパイプラインにわたって時間に敏感な配信を管理できるようにします:
-
Hadoop SLAジョブ追跡
-
高度なスケジューリング基準
-
複雑な依存関係管理
-
リソースプール制御
-
エンドツーエンドのSLA可視性
複雑なワークフローに秩序をもたらす
Control-Mがチームに複雑なプロセスをより可視化し、調整し、制御する手助けをする方法を学ぶ。
