ご要望またはご協力できることがございましたらお気軽にお問い合わせください
一般的なお問い合わせと所在地情報
お問い合わせ

 Control-M + GCP マネージドインスタンスグループ
GCP マネージドインスタンスグループのワークフローは、Compute Engine インスタンスグループの更新が実行される前に開始されます — そして、上流の何かが壊れると失敗する可能性があります。到着しない Cloud Storage デプロイメントマニフェスト。メンテナンスウィンドウの後に終了する Cloud Build リリース。Control-M は、各 Control-M ジョブタイプを介してこれらの GCP サービスを調整します; マネージドインスタンスグループプラグイン自体がインスタンスグループのライフサイクル、ターゲットインスタンスアクション、および未管理グループのプロビジョニングを処理します。
一般的なワークフローの問題
これがあなたの一週間のように聞こえますか?
これらはエッジケースではありません。それらは、複数のツールを使用してGCPマネージドインスタンスグループワークフローを実行しているチームの通常の運用条件です。Control-Mがそれぞれをどのように処理するかは次のとおりです。
デプロイメント依存関係
あなたのCloud Buildリリースは遅れて終了しました。02:00のインスタンスグループの更新はすでに開始されました。
Control-Mは、マネージドインスタンスグループの更新を成功したCloud Buildの完了に依存させます。更新は、その前提条件が成功した後にのみ実行され、不適切なインフラ変更を防ぎ、ツール間でリリースのシーケンスを一貫して保ちます。
更新失敗
Compute Engineはあなたの更新リクエストを受け入れました。ロールアウトはまだ成功していません。
Control-Mは、設定されたマネージドインスタンスグループのジョブステータス、結果、および出力を監視します。ステータスのポーリングと失敗処理により、不成功な操作が明らかになり、ジョブの依存関係が失敗したControl-Mジョブの結果に基づいて次のワークフローステージの進行を防ぎます。
インスタンス回復
マネージドVMは再作成が必要です。あなたの回復ステップは3つの別々のツールにまたがっています。
Control-Mは、上流の条件と下流の検証ジョブを伴った調整されたワークフロー内でサポートされているインスタンス再作成アクションをスケジュールします。オペレーターは実行を追跡し、失敗を中心的に処理でき、切り離されたスクリプトやコンソールを手動で調整する必要がありません。
APIレート制限
Compute Engine APIがHTTP 429を返します。あなたの夜間メンテナンスジョブは失敗します。
Control-Mはインスタンスグループ操作のためのジョブ実行と失敗処理を集中管理しますので、失敗した夜間メンテナンスジョブが即座に浮上し、単一のコンソールから再実行できるようになります。
メンテナンスSLAリスク
あなたのインスタンスグループのメンテナンスが遅れています。06:00のサービス引き渡しが迫っています。
Control-Mは、マネージドインスタンスグループのジョブにSLA管理を付加し、完全なワークフロー全体にわたって依存関係を追跡します。チームは締切リスクを可視化し、遅延をエスカレーションし、定義されたサービスコミットメントに対して下流の引き渡しを調整できます。
Control-M + GCP マネージドインスタンスグループ
Control-M + GCP マネージドインスタンスグループ
|
API と自動化機能 |
Control-M Automation API · ジョブ:GCP マネージドインスタンスグループ · JSON ジョブ定義 · Compute Engine REST API · ctm provision image CLI · ステータスポーリング · 設定可能な API リトライ · ライフサイクルアクション: 作成、更新、削除、およびインスタンスグループのステータス監視; インスタンスレベルの停止、開始、再作成、および保留中の更新の適用; 未管理インスタンスグループの作成と削除。 |
|
デプロイメントモデルとインフラの柔軟性 |
Control-M SaaS · Control-M 自管理 · Linux エージェント · Windows エージェント · 集中接続プロファイル · Google Cloud プロジェクト · マネージドおよび未管理インスタンスグループのための Google Cloud REST API 操作 · Control-M アプリケーションインテグレータプラグイン |
|
セキュリティポスチャ |
Google Cloud サービスアカウント認証 · IAM ベースの認証 · 集中資格情報プロファイル · Google Cloud IAM 権限 · Control-M アクセス制御 · セキュアな接続構成 · ジョブ実行履歴 |
|
インシデント対応と MTTR 有効化 |
ジョブステータスポーリング · 失敗ベースの依存関係制御 · ジョブ出力インスペクション · 自動回復ワークフロー |
エンドツーエンドのオーケストレーション
1つのプロダクションワークフロー。スタック内のすべてのツール。
Control-M は、GCP マネージドインスタンスグループ、Cloud Build、Cloud Storage、Compute Engine、Cloud Monitoring、そしてすべてのクラウドサービスの単一のジョブフロー全体でワークフローをオーケストレーションします — 依存関係の追跡、SLA の可視性、およびすべてにわたる自動回復を備えています。
- クロスツール依存関係: Cloud Storage アーティファクト → Cloud Build → GCP マネージドインスタンスグループの更新 → デプロイメント検証
- データ認識トリガー: Cloud Storage ファイル到着、API イベント、Cloud Build 完了、上流ジョブ結果
|
GCP マネージドインスタンスグループ |
グループの作成と更新 · 制御されたインスタンスの管理 · ジョブステータスの監視 · 依存関係の調整 |
|
Google Cloud Build |
ビルド完了の調整 · インフラ変更のゲート · 上流ジョブの結果を追跡 |
|
Google Cloud Storage |
アーティファクト到着の検出 · 依存ワークフローの開始 · ファイルベースの前提条件の調整 |
|
Google Compute Engine |
VM 操作の調整 · インフラジョブの順序付け · クロスジョブ依存関係の管理 |
|
Google Cloud Monitoring |
設定されたジョブまたはAPIを通じてモニタリングチェックを調整します · 操作の検証をシーケンスします |
|
Google Cloud Functions |
関数ジョブを実行します · 検証ステップを自動化します · 下流のアクションを調整します |
airflow共存
Control-MはあなたのAirflow DAGを置き換えるものではありません。それはその上のレイヤーを実行します。
一般的な異議があります:「私たちはすでにAirflowを使用しています。」問題はAirflowが行うことではなく、Airflowが実行される前後に何が起こるかです。そこが実際にパイプラインが失敗する場所です。
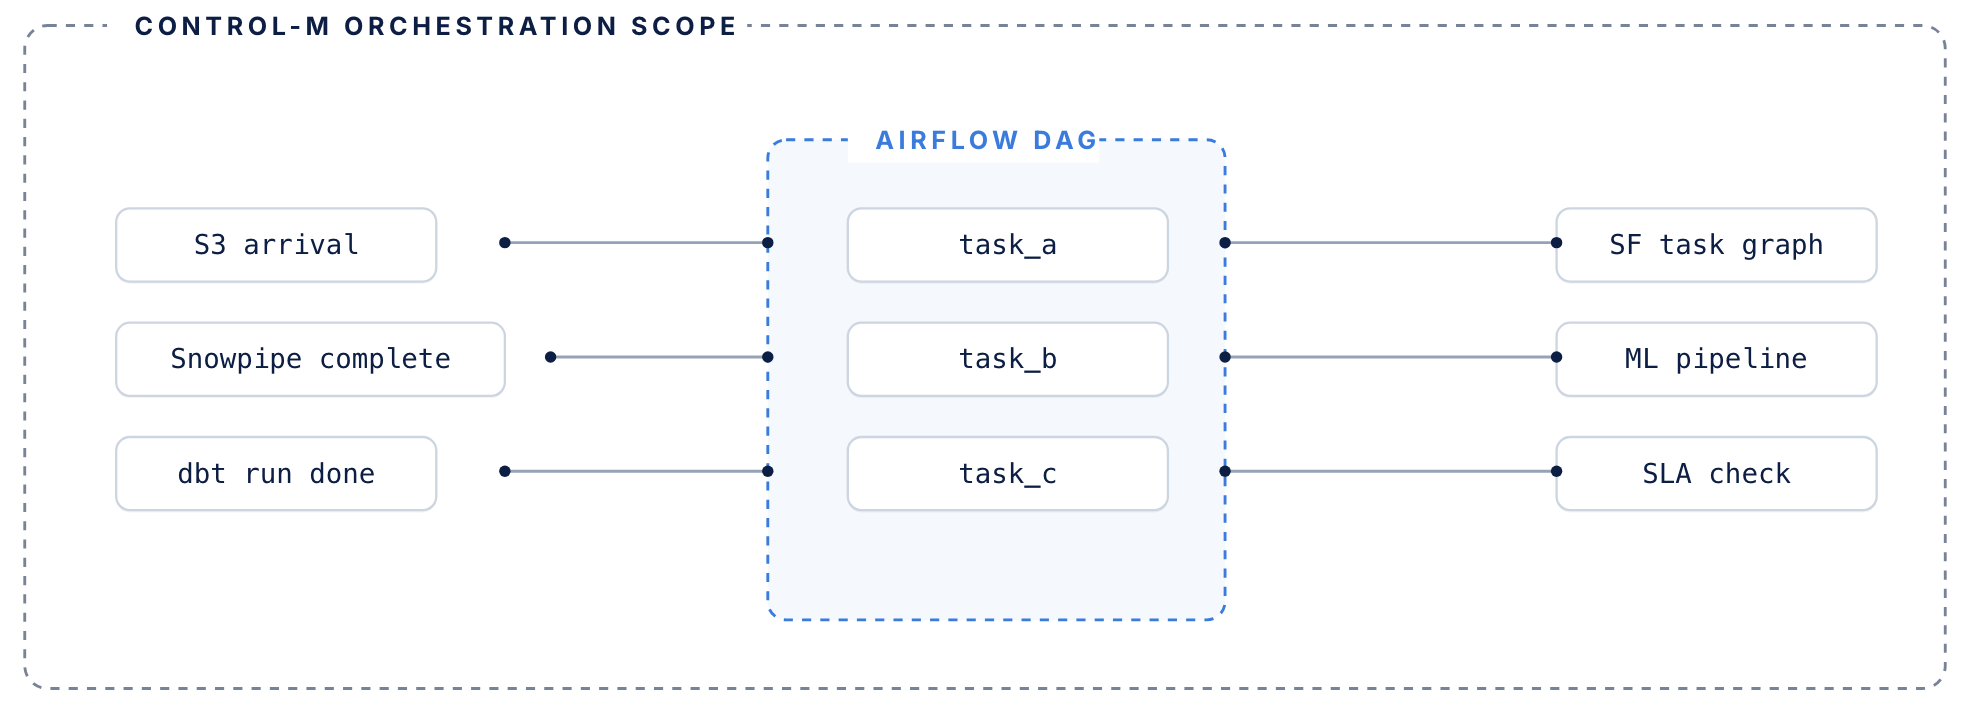
AirflowはそのDAGを管理します。Control-Mはそれを取り巻くすべてを管理します。
airflowが処理します
データパイプライン内のDAGレベルのオーケストレーション
- データパイプライン内のDAGレベルのタスクオーケストレーション
- Pythonオペレーター、センサー、タスク依存関係
- パイプライン内で実行されるジョブの実行グラフ
- 単一のDAGコンテキスト内でリトライを管理
control-mが追加します
あなたのDAGの周りの調整レイヤー
- DAGの周りの調整レイヤー — 上流の条件に基づいてAirflowをトリガーします:ファイル到着、APIイベント、他のツールの完了
- 各DAGのSLA貢献を全エンドツーエンドのワークフローで追跡します。自分のルーチンだけではありません
- Airflowが開始する前に上流の依存関係が失敗した場合の障害回復を管理します
- 既存のDAGを再作成したり移行したりする必要はありません
インフラを監視する
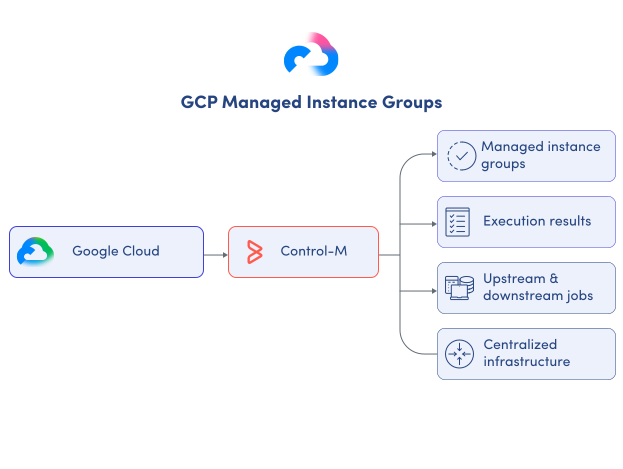
1つの場所からGCPマネージドインスタンスグループのジョブを監視します
Google Cloudはインフラレベルのステータスを提供しますが、それだけではインスタンスグループの操作が依存するエンタープライズワークフローにどのように影響するかを示しません。Control-Mはプラットフォーム全体でジョブ実行の可視性を集中化し、DevOpsやSREチームにアクセスを提供します:
-
マネージドインスタンスグループのジョブステータス
-
実行結果とジョブ出力
-
上流および下流のジョブ依存関係
-
ジョブの期間と実行履歴
-
集中化されたインフラワークフローモニタリング
SLA保証
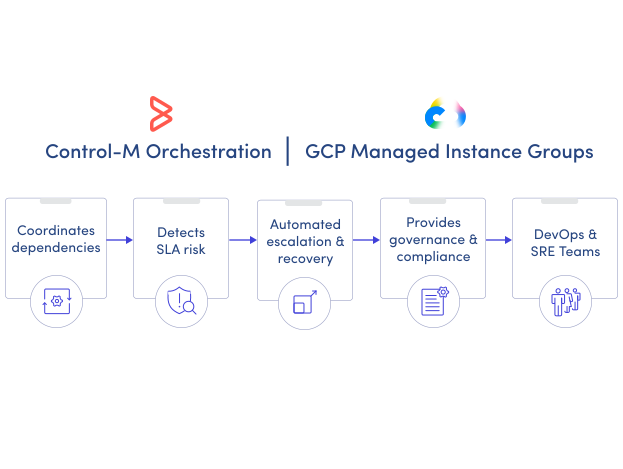
GCPマネージドインスタンスグループのメンテナンスワークフローをスケジュール通りに保つ
Google Cloudはインフラの操作を管理しますが、外部システム全体のビジネスの締切を追跡しません。Control-MはマネージドインスタンスグループのジョブをエンドツーエンドのSLA管理に接続し、プラットフォームチームが遅延を特定し、回復を調整し、重要なサービスの引き渡しを保護します:
-
設定可能なワークフローSLA締切
-
SLAモニタリングと違反予測
-
上流依存の障害可視化
-
自動ジョブリトライと再実行
-
調整された下流実行制御
複雑なワークフローに秩序をもたらす
Control-Mがチームに複雑なプロセスを可視化、調整、制御してオーケストレーションする方法を学びます。
